
客户都开始问 AI 了,它为什么不引用你的网站?
一篇学习类文章,解释为什么 AI 答案引擎不引用你的网站,涵盖内容与技术基础、摘要开关、各引擎引用差异,以及 90 天的 AI 可见度落地节奏。
上个月,一个做企业服务的老朋友约我喝咖啡。落座第一句话就是:出怪事了。
我说你先喝口,慢慢说。
他说,公司官网在 Google 上排名一直不错,核心词常年前三。可前两天市场部小姑娘跑来问他:老板,我在 ChatGPT 里问"我们这个行业哪家公司靠谱",翻了半天,答案里没我们。
他一脸想不通:排名好好的,客户换了个地方问,我就不存在了?
我说,这事一点都不怪。你撞上的,是很多人正在撞的那堵新墙:AI 搜索。
什么叫 AI 搜索?
你以前用搜索引擎,是"提问,然后自己翻答案"。AI 搜索反过来,它直接给你答案,还在答案底下附上参考文献。ChatGPT、Perplexity、Google 的 AI Overviews,都是这一类。业内管这摊事叫 AEO,答案引擎优化。
这个市场涨得有多快?Wix Studio 拉过一份数据:主流答案引擎的月独立访客,2025 年一季度还是 6.34 亿,到 2026 年一季度,涨到了 9.04 亿。一年,涨了四成多。
你的客户正在成建制地搬家。以前他们搜,现在他们问。想知道自己撞没撞墙,可以先试试 HubSpot 那个免费的 AI Search Grader,给品牌在答案引擎里的存在感打个分。
但是,先别慌,也别急着去学什么玄学新招。因为有一个基本判断,你可能想反了。
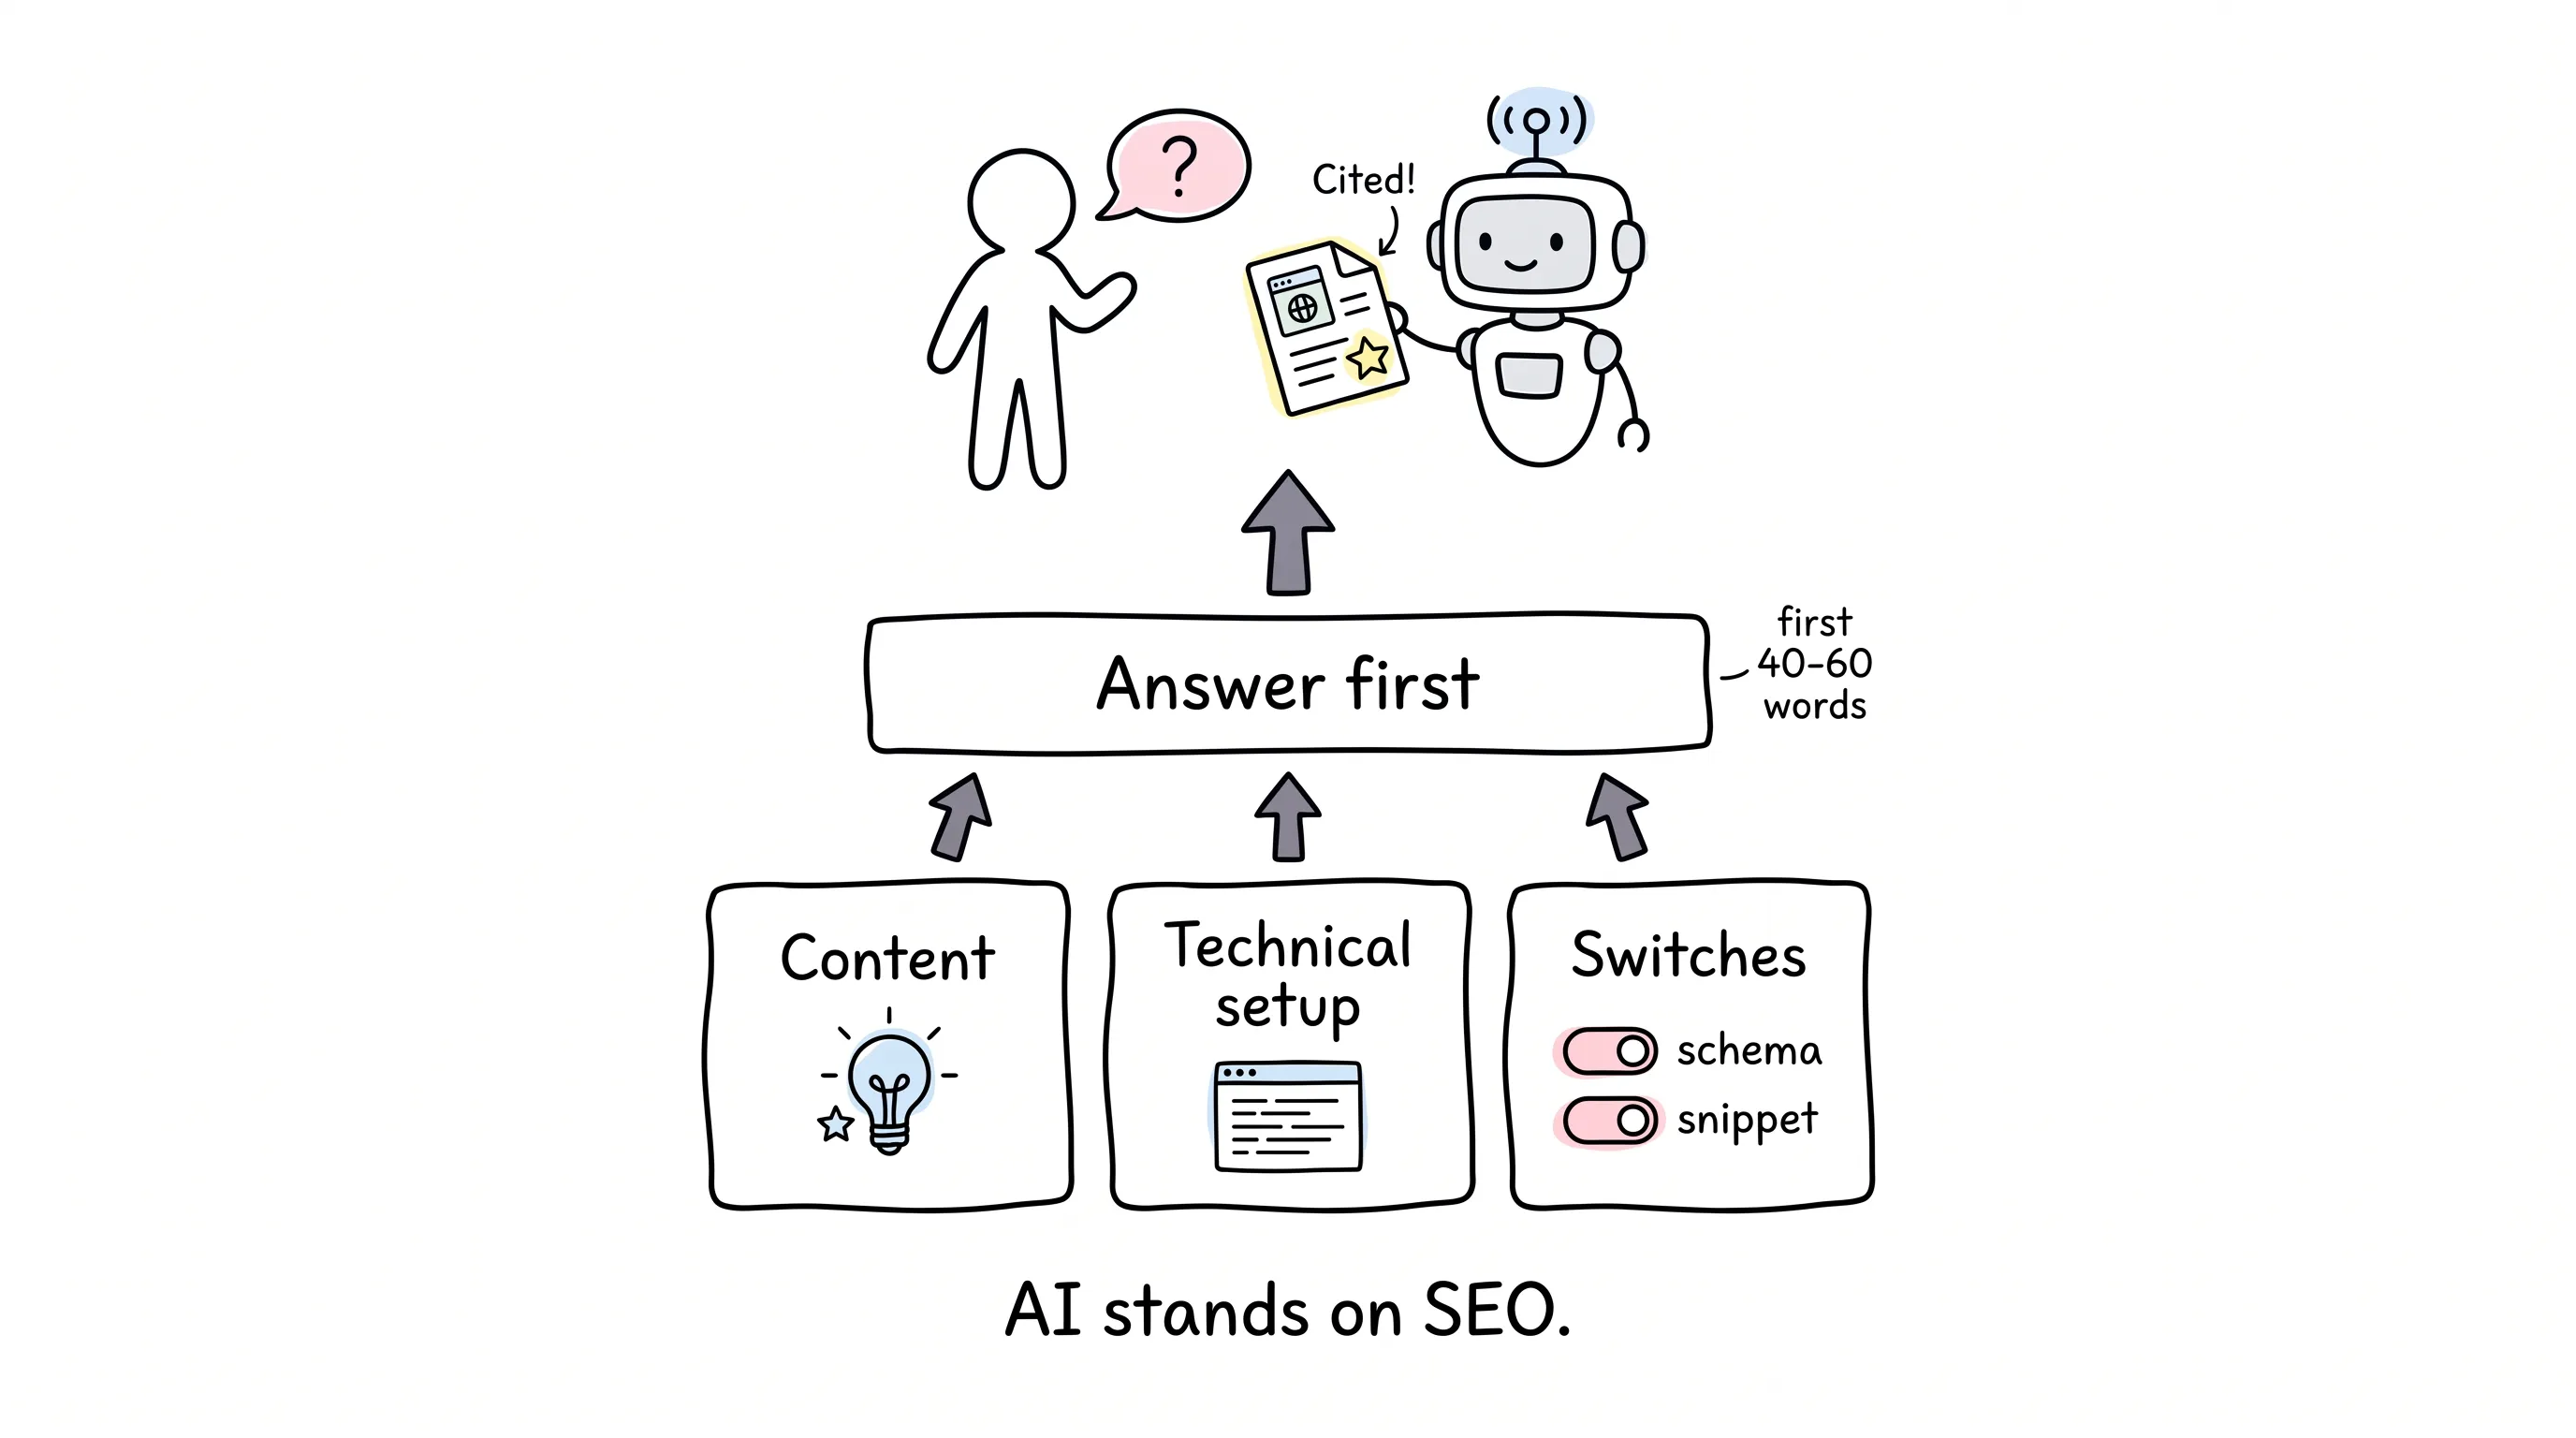
AI 搜索没有取代 SEO,它是站在 SEO 肩膀上的。
你想想看,一个答案引擎想在答案里引用你的网页,它得先干什么?
它得先找到你,爬取;读完你,索引;掂量一下你配不配,排名。这一整套动作,跟传统搜索是同一套。Google 自己说过,AI Overviews 跑在定制版的 Gemini 上,背后用的还是它现成的搜索系统。ChatGPT 搜索也一样,网页结果部分来自 Bing 这些供应商。
所以地基是同一块。一个连搜索引擎都爬不动、索引不进的页面,在 AI 的答案里更没有座位。
地基怎么打?先从最重的那块说起。
第一块地基:内容
Google 在自己的 AI 优化指南里说得很直白:独特、有吸引力、有用的内容,对你网站在生成式搜索里的存在感影响最大。它还专门区分了两种内容:一种叫商品化内容,把网上通行的常识重新打包一遍;另一种,建立在一手经验和真专业上。
你想想看,AI 自己就是"重新打包常识"的天花板。它为什么要引用一个它自己就能编出来的页面?
没有动机。
**AI 不引用它自己就能编出来的东西。**所以,它真正稀罕的,是它编不出来的:原创数据、行业老手的判断、真实的一手经历。
这事有数据撑腰。SE Ranking 分析了 21.6 万个网页,发现:引用了专家观点的内容,平均被 ChatGPT 引用 4.1 次;没引用的,2.4 次。带着 19 个以上数据点的页面,平均 5.4 次;数据单薄的,2.8 次。
写的时候还有个动作很关键:把你的洞察,一句一句、明明白白地摆出来。引擎摘录的时候,它想要的是一段能单独成立、意思完整的话。你写得越"整",它越方便搬。
第二块地基:技术
Google 说得很清楚:一个页面要进 AI Overviews,没有额外门槛,前提就俩,被索引,并且能以摘要的形式展示出来。
速度也在悄悄加分或减分。SE Ranking 的数据:首屏内容绘制快于 0.4 秒的页面,平均被 ChatGPT 引用 6.7 次;慢过 1.13 秒的,只有 2.1 次。差了三倍。慢,是真的会被少引用。
还有一个坑,特别隐蔽:JavaScript。
Googlebot 会渲染 JS,只要你不拦着。但很多 AI 爬虫只读原始 HTML,脚本一概不执行。你的页面要是把核心内容全靠浏览器里的脚本现画,那在 ChatGPT 和 Perplexity 眼里,可能就是一张白纸。
怎么办?核心内容用服务端渲染的 HTML 直接吐出来,别让爬虫猜。顺手再检查一下 robots.txt,别误拦了你想请进门的爬虫。
内部链接也别省,它们是爬虫的指路牌。页面结构同样要清晰:标题层次分明,正文是纯文本,跟广告、边栏分得清清楚楚。这对读者好,对模型也好。
两个容易被忽略的开关
先说结构化数据,也就是 schema。它相当于给你的页面贴一张机器可读的标签:这是产品,价格是这个,作者叫什么,评分几颗星。标签越准,引擎猜得越少,引用起来越放心。
但标签有条铁律:必须诚实。标签里说的,得跟页面上人眼看得见的内容一致。给爬虫看一套,给用户看另一套,这在搜索引擎那儿有个专门的名字,叫 cloaking,伪装,是老牌违规。
schema 是放大器。它放大你本来就清晰可信的内容,救不了一页空话。
再说第二个开关,我管它叫"摘要旋钮"。Google 的规矩是:页面必须在允许展示摘要的状态下,才有资格进 AI Overviews。也就是说,你控制摘要的那几个开关,同时握着你在 AI 答案里的命运。
一共三个:
nosnippet,整页禁摘。等于跟 AI 说:别引用我。
max-snippet,限量供应。设成 0,等于 nosnippet;设成 -1,不限量,长度 Google 自己看着办。
data-nosnippet,精准屏蔽。页面里某一段不想被单独摘出去,就给它打上这个标记,其他部分照常。适合保护那些怕被断章取义的段落。
这三个开关装在哪?页面的 robots meta 标签,或者 X-Robots-Tag HTTP 头。主流 CMS 和 SEO 插件都能设,不用碰代码。发布前,用 schema 校验工具过一遍,确认页面能被正常解析。
提醒一句:哪天发现一篇好好的文章死活不被引用,先去翻它的 robots 标签。很可能是一个忘删的 nosnippet,或者一个设得太小的 max-snippet,把路堵死了。
把答案摆在脸上
CXL 分析过 AI Overviews 的引用分布,结论很直白:大多数被引用的段落,来自页面的前三分之一;底部那 40% 的内容,只贡献了五分之一的引用。
HubSpot 的 AEO 指南给过一个更具体的动作:把每个小节的核心答案,放进开头 40 到 60 个词里。先给结论,再展开细节。
小标题也有讲究。Kevin Indig 研究过 ChatGPT 的引用习惯,发现两件事:被引用的文本里,带问号的比例差不多是普通文本的两倍;而跟问题相关的引用里,78.4% 指向的是标题。你把 H2、H3 直接写成读者会问的那个问题,等于给引擎递了一道现成的"题目",旁边再配一段"标准答案"。
关键事实,多拆成列表和表格。2026 年有一篇预印本研究了结构化排版,同样的信息,列表和表格的提取准确率,比成段散文高出 43%。
对了,动笔前还有个准备动作:把客户常问的问题归成一簇一簇,再把你的品牌、产品、核心话题连成一张关系图。引擎看清了你们之间的关系,才好把你的内容放进答案。
AI 也会看图说话
生成式结果里可以配图片和视频。你不用为此单独准备什么,把图文视频按 SEO 的常规做法配好,AI 这边顺带受益。
视频值得单独说。Fan Out 做过一次站外引用研究:YouTube 是第二大被引用的平台,拿了 1531 次引用。更有意思的是,其中 13.7% 的引用,直接指向视频里某个打了时间戳的时刻。
但别指望 AI 真的"看"视频。它很大程度上靠视频周围的文字判断相关度。所以,上传视频记得配三件套:文字稿、内容摘要、时间戳。
本地和商品数据是另一条路。Google 说,它的生成式回答在合适的时候会拉取商品清单、商品信息和本地商家信息。想让你的货出现在这些答案里,Merchant Center 的 feed 和 Google Business Profile 保持新鲜,两个都别荒着。Google 还推出了 Business Agent,一个挂在搜索上的对话体验,客户可以直接跟你的品牌聊。做零售和服务的朋友,值得盯一下。
一个引擎,一个玩法
你以为所有 AI 的口味一样?差远了。
先看引用量。Fan Out 的数据:站外引用里,Perplexity 一家占了 59%,平均一条答案引 10.8 个来源,属于引用狂魔。ChatGPT 挑剔得多,平均一次查询只引 3.3 个。
再看吃什么。Perplexity 爱逛讨论区,LinkedIn、G2、Reddit 这类页面占它引用的 17.35%,是各家平均水平的两倍还多。在 B2B SaaS 主题的查询里,96% 的 LinkedIn 引用只来自 Perplexity 一家。它还偏爱新鲜、结构清晰、带来源链接的内容。ChatGPT 则更爱传统长文。
连上新的速度都不一样。SE Ranking 和 Search Engine Land 做过一个假品牌实验:刚发布的页面,Perplexity 一到三天就推上了头位;ChatGPT 反应慢,但越往后,对这个品牌的引用越扎实。
最扎心的是这个数:只有 7.7% 的被引用网址,同时出现在不止一个引擎里。
也就是说,你在 Perplexity 里杀疯了,ChatGPT 那边可能一片寂静。反过来也一样。别指望一篇文章通吃所有引擎,把每个引擎当独立渠道来经营。
四个偏方,一个都别试
这段时间,各种 AEO 偏方满天飞。我挑四个最热的,挨个泼冷水。
第一味,llms.txt。给 AI 递小纸条,听着挺美好吧?SE Ranking 在 2025 年 11 月分析了将近 30 万个域名,结论:有没有这个文件,跟 AI 引用量没有相关性。更打脸的是,把这个变量从预测模型里删掉,模型反而更准了。Google 也明说了:这类特殊 AI 文件,我们忽略。老老实实做 SEO。
第二味,给机器单独做一版 .md 页面。一版给人看,一版给 AI 看?Google 的 John Mueller 明确反对:LLM 从第一天起就能解析普通 HTML,不需要你开小灶。而且,给爬虫一套内容、给人另一套,前面说了,这叫 cloaking,踩红线的。
第三味,专用"AI 标记"。Google 说了,生成式搜索不需要任何专用 schema。那数据怎么说?两边打架。AirOps 和 Kevin Indig 那边,加了 JSON-LD 的页面被 ChatGPT 引用的比例是 38.5%,不加是 32%,有 6.5 个点的优势。可 Ahrefs 拿 1885 个页面做了对照实验,没测出有意义的提升,AI Overviews 的引用反而降了 4.6%,而且没法确定就是 schema 的锅。我的建议:把 schema 当卫生习惯,标签老实描述页面上看得见的内容。但别指望它是火箭燃料。
第四味,制造提及。去各个论坛铺假好评,试图喂出 AI 的答案。能成吗?短期真能。还是那个假品牌实验:一个虚构品牌,30 天内就在五个答案引擎上几乎拿下了全部品牌词可见性。但注意,赢的全是只有它自己能答的品牌词,竞争性话题上一个没拿下。而且 Google 把操纵生成式回答定性为 spam,成规模的操纵内容会被降权。短线投机,长线塌方。
被引用了,然后呢?
光数引用次数,是自嗨。要看两样东西:可见性,和转化。
可见性方面,先拍基线快照。市面上有免费的打分工具,比如 HubSpot 的 AEO Grader,能给你的品牌在 ChatGPT、Perplexity、Gemini 里的存在感拍个快照,还附带跟对手的声量对比。HubSpot 的 AEO 产品可以持续盯着这些引擎,发现你在哪些问题上正在滑坡。该先刷新哪个页面,看数据,别拍脑袋。
转化方面,有个反常识的数据。Microsoft Clarity 研究了 1200 多个网站:AI 带来的访问量,不到 1%。听着可怜吧?但这些访客的注册点击率有 1.66%,传统搜索只有 0.15%。十倍都不止。WebFX 分析了 23 亿个会话:AI 带来的访客,转化率比自然搜索高出大约 1.2 倍。
量小,质高。这就是 AI 流量的性格。
再往后,把这股流量接进 CRM 算钱。HubSpot 的 AI Referrals(Marketing Hub 和 Content Hub 的 Professional、Enterprise 版本里有)能把来自 ChatGPT、Perplexity、Gemini 的流量单独归成一个来源,跟普通自然搜索分开看。Marketing Hub Enterprise 还有多触点收入归因,能把这些 AI 访客一路连到成交。
不过有个坑得说清楚:很多 AI 发现是"零点击"的,客户在答案里看了你的品牌,根本没点进来。这部分,任何网站工具都算不到,归因只能覆盖点了链接的那一段。知道这个局限,你就不会被报表骗了。
然后固定节奏复盘:每月重新拍一次基线,看赢了哪些、输了哪些,喂回下一轮修改。这个循环转起来,一次性优化才变成复利。
90 天,把这事变成制度
最后,说个落地节奏。
第 1 到 30 天,定人。指定一个人或一个小组,对 AI 可见性负责,就像你们给 SEO 定负责人一样。基线快照、优先救哪些页面,都归他拍板。责任落在人头上,才不会人人都管、人人不管。
第 31 到 60 天,定节奏。把每月复盘变成写进日历的制度:审哪些页面、按什么周期、看哪些信号。话题热得快的页面,周期调紧;长青内容可以缓一缓。
第 61 到 90 天,定规矩。协作的人一多,质量就会漂移。把选材标准、命名规则、schema 用法、答案前置格式写成文档,人人一个标准。再加一道风险审查:健康、金融、法律、安全这类话题,会被 AI 直接当答案复述出去,错了代价很高。发布前过一遍事实核查,该上合规就上合规。
引擎会一直变。人、节奏、护栏不变,这事就能自己滚动。
回到那杯咖啡
写完这篇,我给那位朋友回了条消息:先别急着怪 AI 偏心。回去查三件事:你的页面能不能被爬、够不够快、核心内容是不是服务端渲染。然后把每个小节的开头 60 个词重写成"先给答案"。最后,看看 Perplexity 和 ChatGPT 各自吃什么,分开伺候。
三个月后再见分晓。
也许到时候他还会跟我抱怨。不过抱怨的内容可能变成:客户在 AI 里随口一问,答案里全是他公司。
那就不是事故了。
那是资产。
继续阅读
相关文章
你的品牌,AI 知道吗?聊聊 GEO 这门新手艺
一篇介绍 GEO(生成式引擎优化)的科普文章:拆解 ChatGPT、Perplexity、Gemini 等引擎的类型差异,说明 GEO 与 SEO 在目标和衡量指标上的不同,以及哪些 SEO 老功夫仍然适用。
89% 的零售商都在用 AI 了,电商这场仗,打法全变了
本文梳理 AI 在电商中的应用:涵盖个性化推荐、智能搜索、动态定价、智能客服、库存预测与风控等场景,并讨论 B2B 电商、生成式 AI 内容、工具选型、落地风险与六步实施路径。
AI 内容跑得飞快,可「谁批的」三个字,你答得上来吗?
本文探讨 AI 内容生产提速与治理缺位之间的落差,梳理从提示词校验、品牌护栏、权限、审批流、人工分级审核,到版本谱系、IP 管理、审计留痕与素材复用的九个控制点,说明如何让 AI 生成的营销物料全程可追溯、可问责。