
这5个生成式AI场景,已经在真金白银地赚钱了
长文解析五个已进入生产环境的生成式AI场景:医疗文档处理、电商推荐、流程编排、私有RAG部署与带记忆的AI客服,并总结选型与合规三条铁律。
前段时间,我参加了一个企业服务圈的饭局。一桌人,聊AI聊得最热的,早就不“用不用”了,在聊“为什么我的AI项目还停在演示阶段”。
一个做了十几年企业软件的老哥,端着杯子问我:你说,大模型都进化成这样了,怎么真正落地的还是少数?
我当时没答上来。回来翻了翻手上的项目,又对了一圈外面的数据,我想明白了。
先看一组扎心的数字
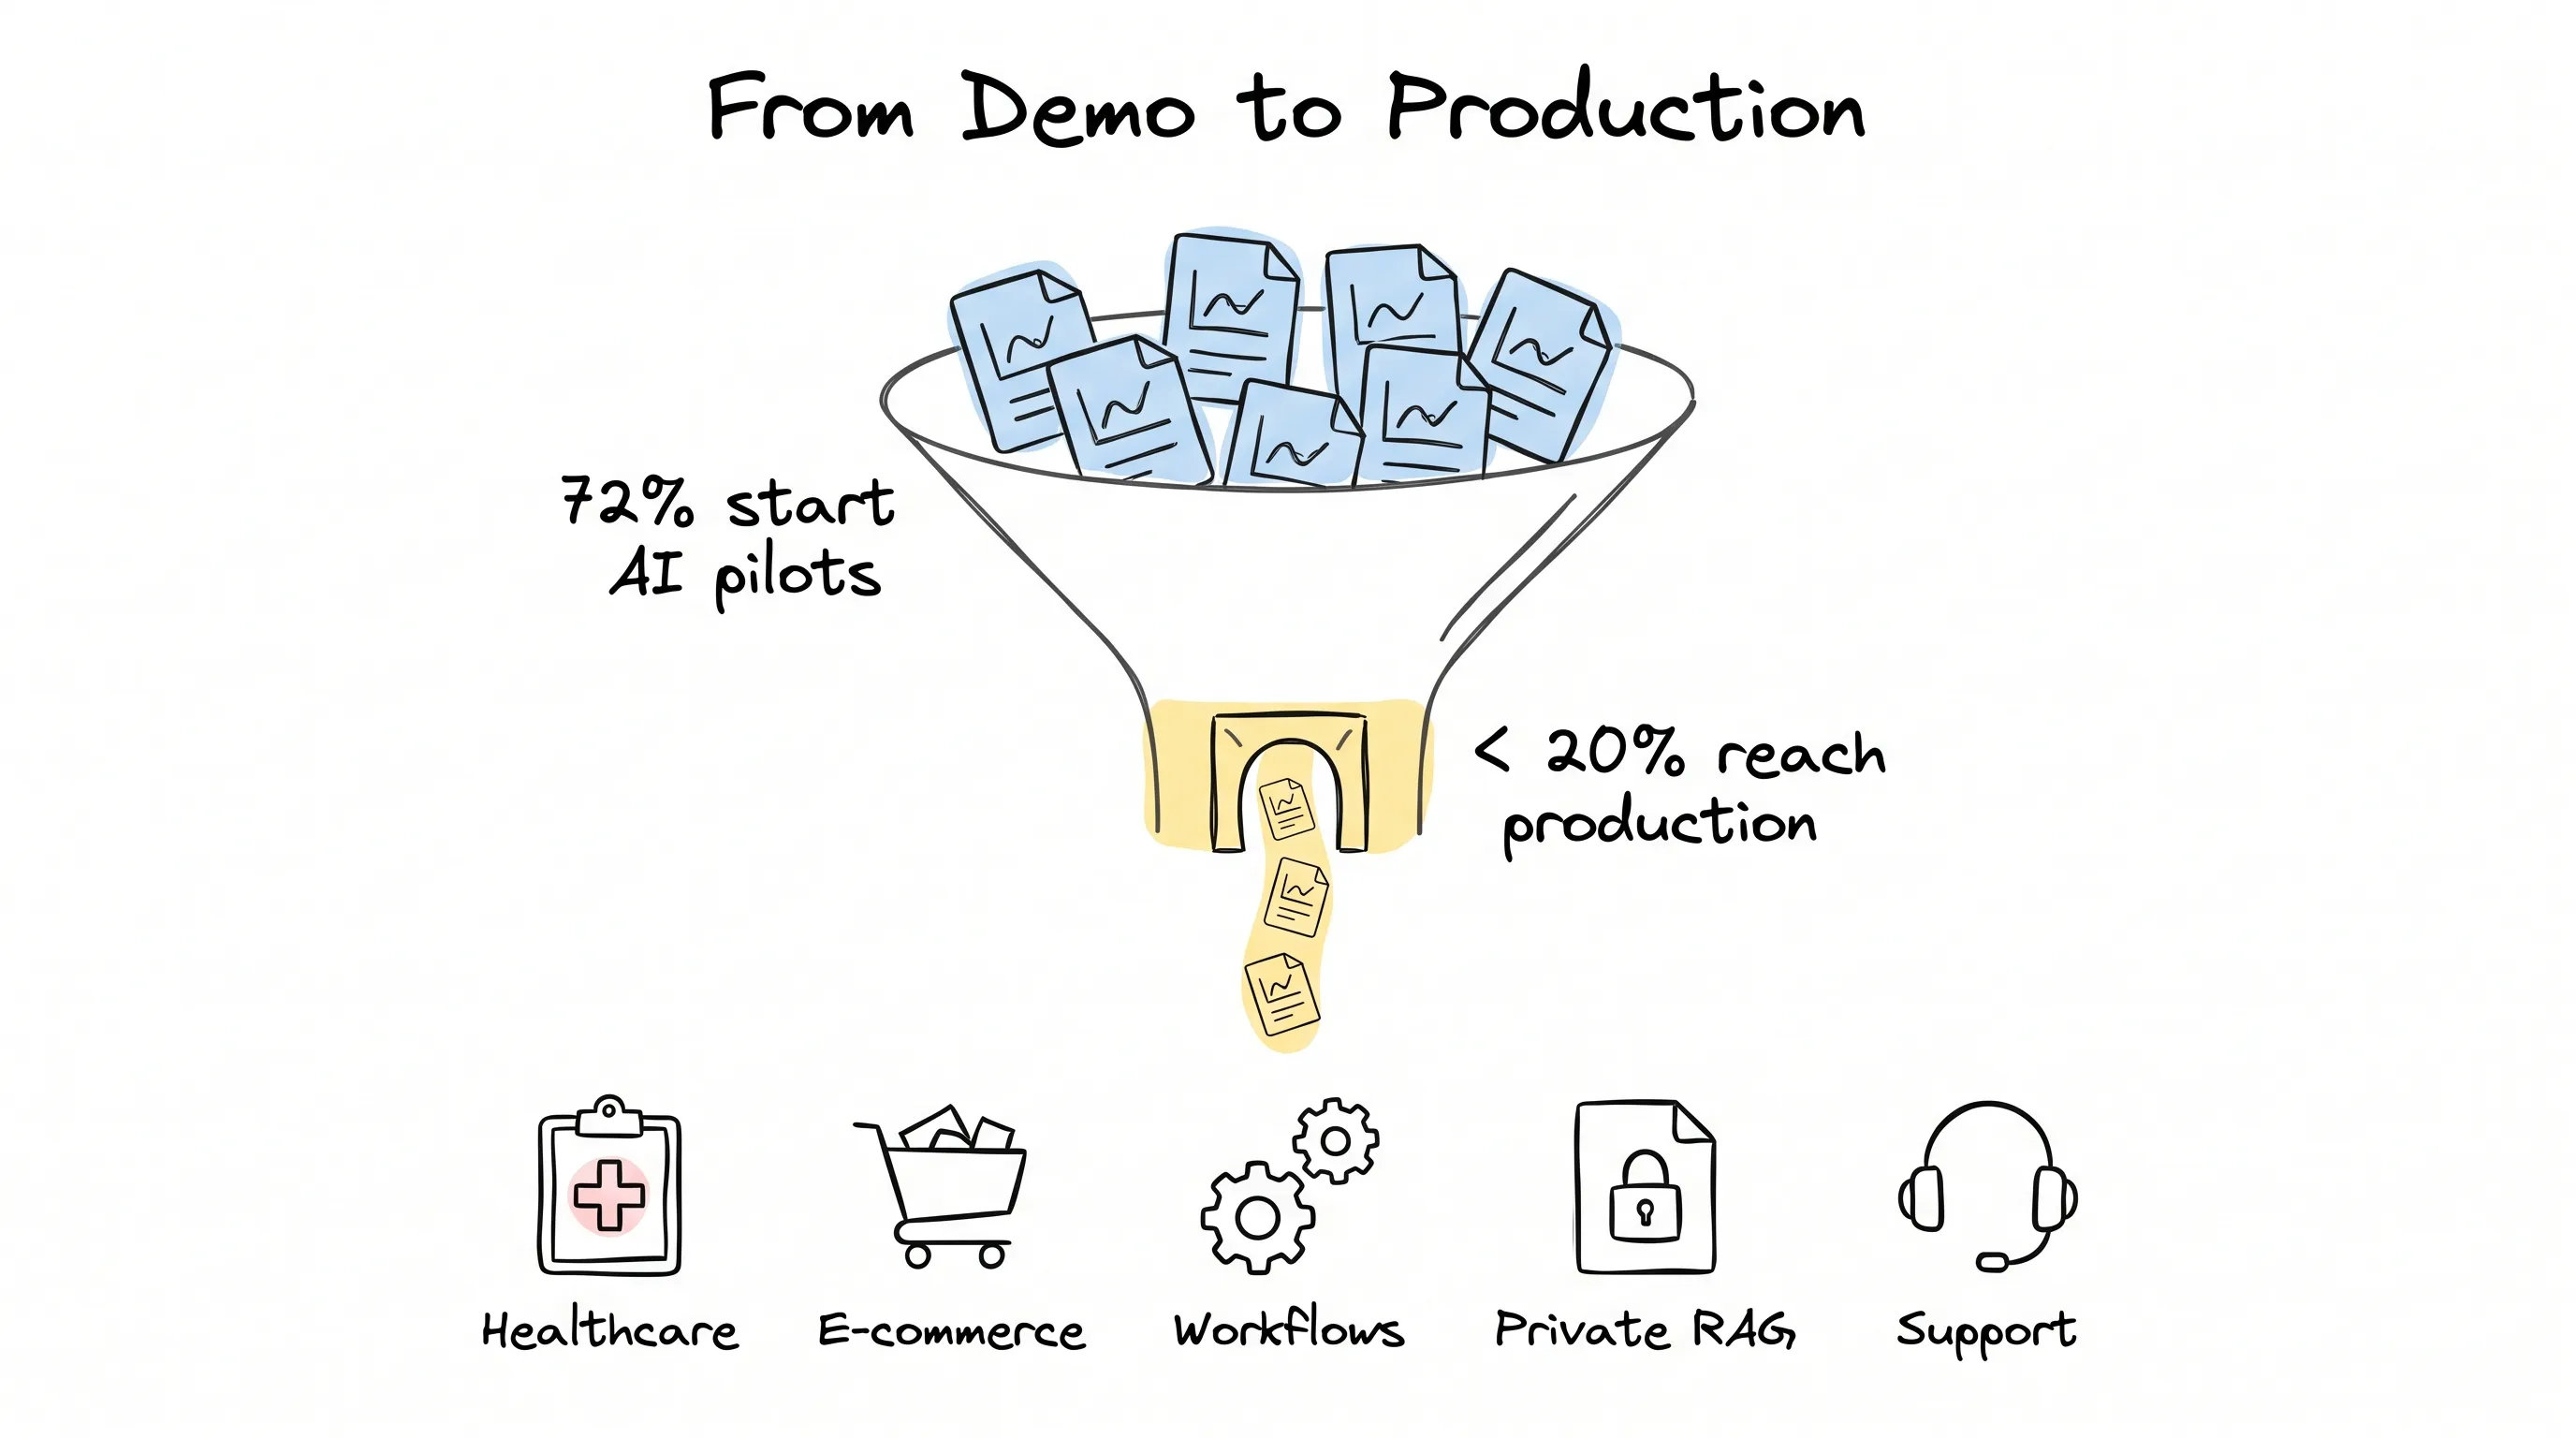
2025年,德勤做过一份调查:72%的企业,已经把生成式AI项目摆上了台面。
听着挺热闹,对吧?
但另一头,各家分析机构反复点出来的数字是:这些试点里,能真正跑进生产环境的,不到两成。
剩下那些呢?有的死在安全评审,有的卡在系统集成。更多的,是演示惊艳了所有人,然后有人轻飘飘问了一句:数字呢?
然后就没了。
大部分公司的AI,活不过演示。
问题出在模型上吗?我这两年看下来的项目不少,说句得罪人的话:几乎从来不是。卡住的,是五件一点也不性感的事:场景切得准不准,数据管道过不过得了合规,模型是不是够用就好,账第一天算不算得清,以及有没有在选模型之前,就想好它怎么接进你现有的系统。
空讲道理没意思。我给你讲5个已经跑进生产、真的算得出钱的场景。每个场景,我都把背后的架构拆给你看。
场景一:医疗,先把人从“搬数据”里捞出来
医疗行业,本质上是在纸上运转的行业,数字化的那种纸。挂号单、病历、保险理赔、术前授权。
有个数字我第一次看到时愣了半天:一个普通的护理协调团队,30%到40%的时间,花在把信息从一份文档搬进另一个系统。也就是说,他们最贵的脑子,天天在干录入员的活。
现在的做法是什么?OCR先把纸上的字捞出来,一个在临床语料上微调过的大模型负责读懂它、拆成结构化字段,然后直接写进电子病历系统。合规上,训练用合成数据,管道全程加密,每一步留审计日志;转录用AWS HealthScribe,本身就是HIPAA合规的服务;输出按HL7 FHIR的标准来,病历系统直接认。
居家护理平台Careonix把这套东西装进了患者入院流程。手写体的潦草、缩写的歧义、多份文件对不上,模型一起处理。
但这套架构真正值钱的地方,是它会“对文件”。什么叫对文件?患者的入院表、保险卡、过往就诊记录,三份材料一次对齐。术前授权的周期,从3到5天,压到几个小时。
场景二:电商推荐,钱藏在“为什么想买”里
传统推荐引擎有个天花板:它知道“和你像的人买了什么”,但它不知道“你,此刻,为什么想要这个”。
钱,就藏在这句话里。
现在的新打法,是把推理能力塞进推荐层。系统读你的浏览上下文、会话意图、购买历史,实时生成个性化的商品讲述和类目建议。商品目录用语义向量建索引,不做关键词匹配;旁边再挂一个动态定价模型,盯着竞品和需求信号实时调价。
效果多实在?眼镜电商Lenskart接上AI推荐层之后,转化率涨了20%。Sephora的销售额涨了13%。这已经不是行业里的传奇,在变成基线。
不过这里有个坑,我必须提醒你:大模型绝不能编造商品参数。推荐系统必须有一层约束,把模型的输出死死摁在真实商品目录上。不然会怎样?你会得到一件根本不存在的商品的绝美文案。信任这东西,当场就死。
场景三:流程编排,让AI当调度员
一张销售订单,从下单到确认,要穿过五个系统。一个新员工入职,三个平台,七道审批。
人工交接慢,还只是小事。真正的麻烦是:错误在交接里滚雪球,合规在交接里漏水。
新的解法叫AI原生编排:流程的骨架还是自动化工具,判断的脑子换成大模型。比如n8n做编排,大模型做路由决策,再挂一个RAG,让它随时查公司政策。
一家叫QuickShift的物流公司,把调度团队换成了这套系统:n8n管道收进司机档期、路线数据、配送时间窗,大模型给出调度建议,输出直接触发短信、邮件、订单系统里的确认。标准订单,全程没有人。
这里有个选择,很多企业会踩错:为什么是自托管的n8n,而不是Zapier?因为你的流程里跑的是财务数据、病历、客户隐私。自托管,数据在自己手里;走第三方平台,数据从别人的机器上过。在受监管的行业,这件事没有商量余地。
场景四:私有模型加RAG,让AI认识你自己的公司
公开大模型有个致命空白:它不认识你的公司。
你的报价逻辑、客户历史、内部政策、上一版方案,它一概不知。员工一旦要对着这些专有信息做判断,公开模型就废了。更糟的是,有人把机密上下文贴进对话框,责任就出去了。
德勤2025年那份调查里还有个数字:72%的中小企业,把“没法安全地用内部数据”列为上生成式AI的头号障碍。
解法是私有部署,外面套一层RAG。我拆开讲:内部文档,PDF、SharePoint、Confluence、Slack、CRM导出,切块、向量化,存进向量数据库,Pinecone、Weaviate、pgvector都行。用户提问,语义检索捞出最相关的几段;私有模型(Llama 3、Mistral,或者微调过的GPT)只对着捞出来的内容推理,不联网,不调外部接口,部署在你自己的云上。
用起来什么感觉?一个销售工程师问:“Q4我们给物流客户的报价是多少?”答案从真实提案里长出来。
知识第一次变成了资产。而且这资产,越用越厚。
场景五:客服,给AI装上记忆
市面上的AI客服,大多有失忆症。
这次聊完,下次再来,从头再讲一遍。这不是AI客服,这是一张稍微聪明一点的FAQ页面。病根在架构:传统客服机器人里,每场对话都是无状态的,没有记忆层。
解法分两层。记忆这层,用Anthropic提出的MCP(Model Context Protocol),让AI跨会话、跨工具、跨用户地保持上下文;再接上CRM,这个客户的历史交互、未结工单、购买记录,随叫随到。动作这层,大模型只做结构化的操作:查订单、触发退款、转人工,每一个动作都是预定义的工具调用,不给它自由发挥的空间。中间再加一路实时的情绪识别,发现用户急了,立刻转人工。
一家SaaS平台接完这套之后,68%的进线工单,不需要人工介入。偶尔真的要升级,人工客服收到的也是一份完整的上下文摘要,客户一个字都不用重复。
想想美国银行的Erica,超过10亿次客户交互。会记人的AI,省的不只是处理时长,是流失率。
拆完五个场景,我总结三条铁律
一条,模型够用就好。
一个38亿参数的小模型(比如Phi-3.5 Mini),部署在本地,做文档分类,比GPT-4更快、更便宜、也更好管。最强的模型,往往也是最贵、最慢、最难控制的那个。能力匹配需求,别用火箭送外卖。
二条,合规是地基,不是装修。
上面五个场景,每个都踩着合规线:医疗是HIPAA,企业数据是主权,电商支付是PCI。系统跑通了再回头补合规,难度是重建的几个数量级。跑进生产最快的那些团队,都把合规当成设计约束,而不是上线前的检查项。
三条,先定义“什么算能用”,再选模型。
死在集成阶段的试点,都犯同一个错:为演示优化,不为集成优化。选型之前,先回答三个问题:输出怎么接进我现有系统?六个月后谁维护?一次失败的推理长什么样?答不上来,你手上那个东西不是产品,是Demo。
那从哪开始?
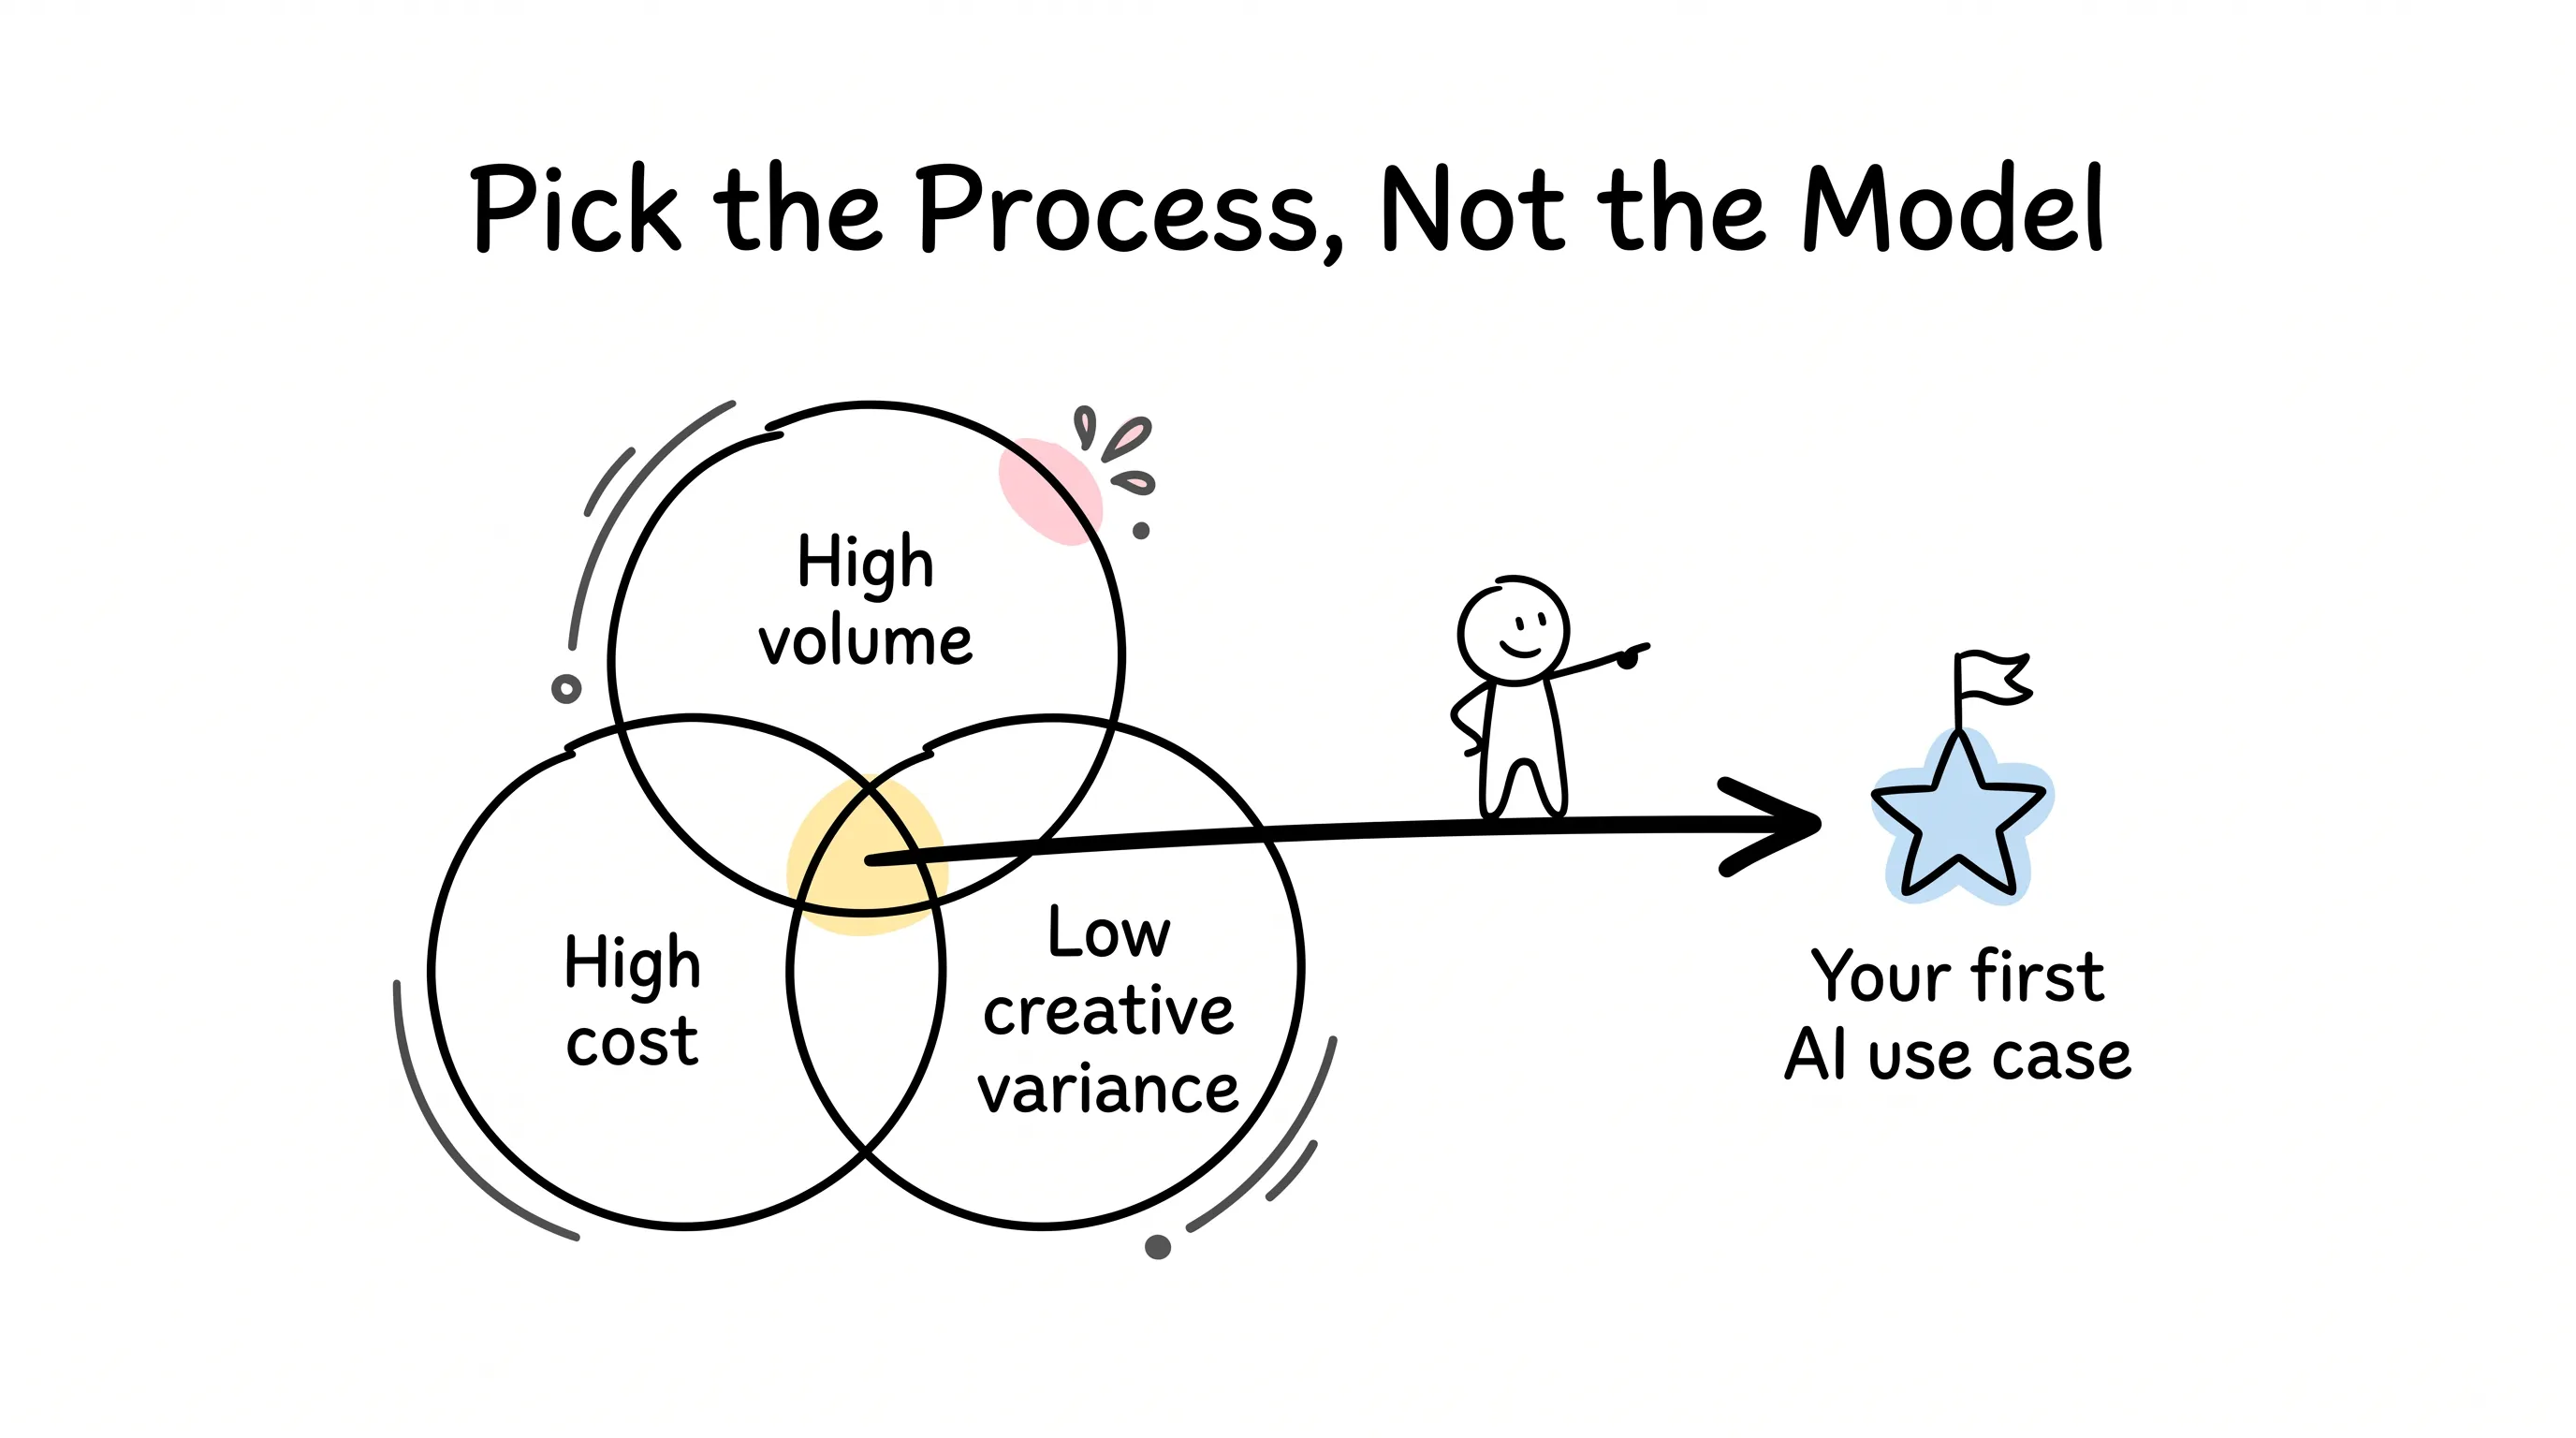
2026年了,如果你正在评估生成式AI,记住,第一个问题不是“选哪个模型”。
是“选哪个流程”。
找个什么样的流程?高流量、高成本、低创意方差。什么叫低创意方差?就是最优解基本固定,你最好的员工怎么做,系统就原样复制,一百次也不走样。
找到它,那就是你的第一个生成式AI场景。场景选对了,剩下的都是工程;选错了,再贵的模型也救不回来。
那天饭局散场,老哥问我下一步怎么办。我说,先别管模型。回公司,把你最贵、最重复、最不需要灵感的那件事找出来,它就是答案。
也祝你,永远不用在演示会上,解释为什么Demo很惊艳、数字很难看。
继续阅读
相关文章

跨境生意,是时候换一套 AI 工具箱了
一篇 learn 类文章,讲解跨境电商卖家如何用 AI 工具应对语言、法规、物流、支付与欺诈五道坎,梳理翻译、库存、客服、营销、风控五格工具箱与五步上手路径,并提示转化率、CLV 等指标和过度依赖 AI 的风险。

社交媒体营销的脏活累活,正在被 AI 一件件接管
本文介绍 AI 在社交媒体营销中可承担的四类工作:受众数据分析、文案与设计创作、广告定向与创意测试、垃圾内容过滤,并提醒内容判断和数据安全仍需人工把关。

AI 都这么能干了,你的社媒营销还在纯靠人肉?
本文将 18 款常用 AI 工具按用途分为六类,覆盖用户洞察、内容生产、内容排期、评论私信、广告投放和视觉制作,并讨论个性化、趋势预测与虚拟网红等趋势。