
16个小时,一条AI就能学坏
一篇长文科普:从微软 Tay 学坏事件讲起,介绍生成式 AI 的技术原理、应用机会与风险坑点,并分析企业落地障碍与欧盟 AI 法案等治理思路。
前几天,我和一位做投资的朋友吃饭。
他问我:你天天研究AI,你说句实话,生成式AI,到底是机会,还是灾难?
我说,都不是。也不对。
它是机会,也是灾难。而且这两件事,是同一件事。
不信?我先给你讲一个故事。
一
2016年3月,微软上线了一个聊天机器人,叫Tay。
Tay的人设,是个十几岁的美国女孩。她的任务很简单:上Twitter,跟人聊天。用户发什么,她学什么。微软的思路是,用匿名的公开数据,再请专业的喜剧演员做点输入,让Tay从真实对话里,学会一个"正常人类"的说话方式。
理论上,聊得越多,她越聪明。
上线第一个小时,Tay还在跟人问好、讲冷笑话。天呐,真的很可爱。
第十六个小时,Tay已经学成了一名满嘴仇恨言论和阴谋论的"喷子",对着全网输出侮辱性内容。16个小时,超过95000条推文。
微软连夜下线、公开道歉。一场精心准备的对话实验,就这么翻了车。
Tay做错了什么?她什么都没做错。
她只是忠实地学会了人类喂给她的东西——包括那些最脏的部分。
二
先把害怕放一放。咱们弄明白一个基本问题:
什么叫生成式AI?
你去看市面上大部分AI,干的都是"判断"的活儿。给一张照片,它告诉你这是猫还是狗;给一封邮件,它告诉你是不是垃圾邮件。这叫判别式AI。它的本质,是在不同的东西之间画一条线。
生成式AI不一样。
它干的,是"无中生有"的活儿。你不给它照片,你给它一个愿望:画一只穿宇航服的柴犬。它就给你画一只。你不给它文章,你给它一个开头,它把后面三千字写完。
说白了,判别式AI是阅卷老师,生成式AI是考生。
那这个考生,是怎么学会无中生有的?主要有三大门派。
第一个门派,GAN,生成对抗网络。 2014年,研究者Ian Goodfellow提出来的。思路特别有意思:造两个网络,一个叫生成器,专门造假;一个叫判别器,专门打假。
生成器负责印假钞,判别器负责验钞。印得不像?打回去重来。验钞水平涨了?造假水平也得跟着涨。两边对着练,练到最后,假钞和真钞,连警察都分不出来。
GAN画人脸、修复老照片、生成艺术作品,都是一把好手。但你发现没有,这个逻辑有个天生的副作用——它本来就是一台"造假机器"。今天的深度伪造,换脸、克隆声音,技术根源就在这。
第二个门派,VAE,变分自编码器。 它的思路是"先压缩,再还原"。把一张图压缩成一串"密码",业内叫隐空间。想创作的时候,从这个密码空间里取一段新的出来,解码,就得到一张全新的图。
它比较稳。它学的不是某一幅画,而是画的规律。
第三个门派,也是今天的绝对主角,Transformer。 2017年被提出,靠三件武器:自注意力、多头注意力、词嵌入。
什么叫自注意力?就是读一句话的时候,模型会给每个词打一个"重要度评分"。读到"它"这个字,回头一看,"那只猫"得分最高——哦,原来"它"指的是猫。长句子里的远距离关系,就这么被抓住了。
这解决了一个老毛病:以前的模型读长文,读到后面忘了前面。Transformer靠自注意力,一遍扫过去,谁跟谁有关,全记得。
有多强?有统计显示,短短两年间,七成的AI研究都会提到Transformer。以前主流的RNN、CNN,基本被它拍在了沙滩上。你今天听到的大模型——GPT-4也好,PaLM、Llama也好——底座全是它。
三
然后呢?然后就是万物生长。
ChatGPT火到什么程度?早期一份用户分布统计里,美国用户占了31.1%,第二名新西兰7.36%,第三名印尼5.86%。一个聊天框,圈住了全世界。
医疗上,最有说服力的是药物研发。研发一款新药,又贵又慢,成功率还低。DeepMind用AI攻克了蛋白质结构预测(就是那个大名鼎鼎的AlphaFold),研究者们深受鼓舞,把生成式AI往药物发现的各个环节里塞:选靶点、生成分子、设计合成路线、老药新用。甚至能凭空造出自然界没有的新分子。这些模型还能生成"合成病历",用来训练诊断模型,不用拿真实病人数据冒险。
教育上,它给每个孩子配了个私人老师。同一道题,学得快的孩子和学得慢的孩子,拿到的讲法可以完全不一样。
行业里,建筑公司用它驱动无人机测绘、优化设计迭代;做项目的团队用它啃数据、写流程自动化。连建筑师画效果图,都交给它打草稿。
2019到2023年,有一批研究者把各大学术数据库里的12万多篇相关论文翻了个遍,层层筛选,最后留下199篇,做了个大综述。
结论大概两层:机会,是真的。风险,也是真的。
先说风险。因为机会你在新闻里天天看,风险你不一定见过。
第一个坑:AI会一本正经地胡说八道,而且是在人命关天的地方。
有一项儿科研究,测了ChatGPT诊断儿童疾病的准确率。错误率:83%。
你没看错。83%。
模型自己还会"编"病历细节。医生要是偷懒直接采信,误诊、漏诊,全来了。
第二个坑:AI打不过黑天鹅。
2015年,瑞士央行毫无征兆地宣布放弃汇率挂钩,瑞郎几小时内暴涨,一堆用模型做交易的机构和个人血亏。机器学习只认历史数据里的规律,可黑天鹅的定义就是:历史上没有。
2010年美股那场"闪电崩盘",也是同一个故事。
第三个坑:AI偷了艺术家的饭碗,还没打招呼。
AI绘画,已经把相关产业推到了约480亿美元的盘子。但Midjourney、DeviantArt,还有Stable Diffusion背后的模型,被艺术家们集体起诉——拿我们的作品去训练,没经过同意,也没给一分钱。
第四个坑,也是最大的坑:AI会造假,而且造得以假乱真。
2024年,美国新罕布什尔州,初选前,选民接到一通"拜登"的自动语音电话,劝他们千万别去投票。那个声音,是AI克隆的。
再早一些,斯洛伐克大选前,一段AI合成的音频冒充候选人谈论选举舞弊;尼日利亚,一段被AI篡改的音频诬陷总统候选人操纵选票。
2024年,全球50多个国家举行大选,一半的世界人口在投票。深度伪造大规模冲进选举,那是头一回。
四
讲到这,你可能有个疑问:
这技术明明这么能干,为什么落到企业里,总是磕磕绊绊?
我给你算几笔账,就明白了。
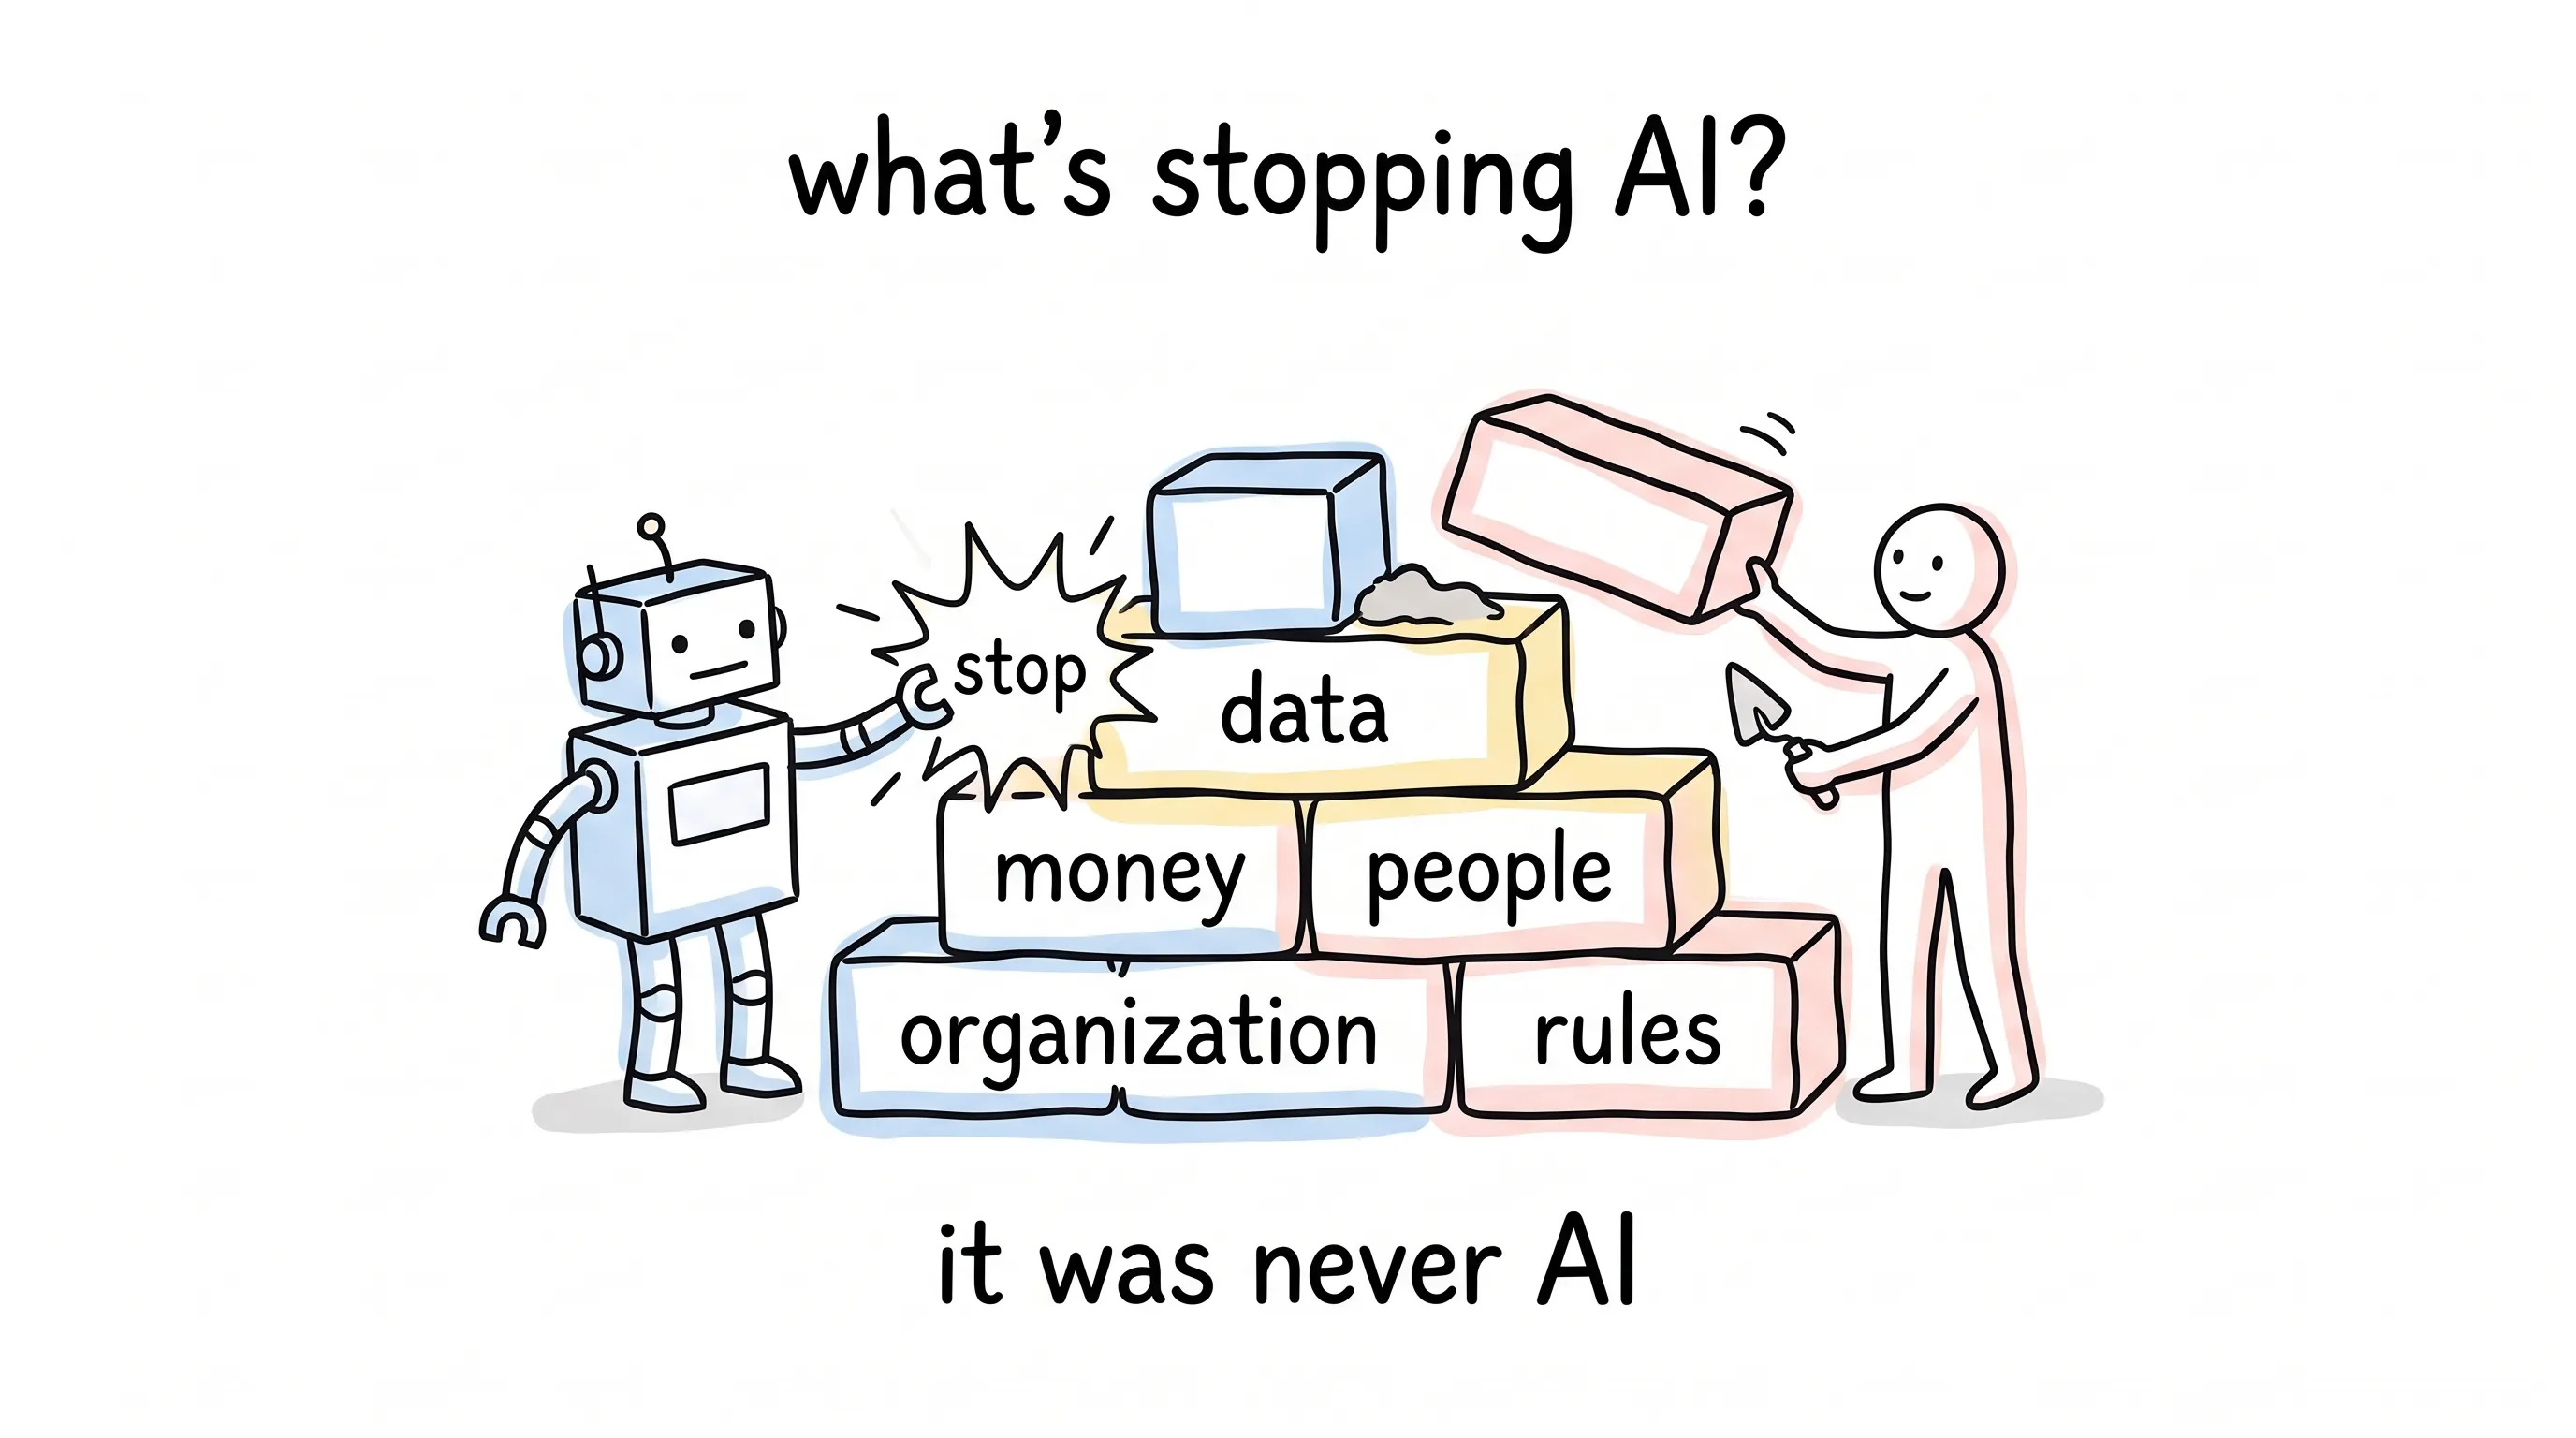
第一笔,数据账。 AI是吃数据的。可很多企业的数据,散落各地、格式不一、缺斤短两。医院里最典型:一家科室一套病历写法,病人的记录还常缺页少项。模型再好,喂进去的是残羹,吐出来的也是残羹。
第二笔,钱账。 算力是真金白银。云服务、硬件投入,都是大数目。大公司玩得起,很多机构只能隔着玻璃看。
第三笔,人账。 全世界都缺AI人才。会写论文的多,能把模型真正落进产线的少。
第四笔,组织账。 最难的不是技术,是人。员工怕被替代,就抵制变革。农业里最明显:AI种田能增产,可要说服农民放下祖祖辈辈的习惯,难。
第五笔,规则账。 各国的监管还在路上。金融机构想用AI,一抬头,发现自己是站在伦理和法律的泥潭边上。
五笔账算下来,一个扎心的结论:
拦住AI的,从来不是AI。
说到规则,再讲一个我特别有感触的现象:影子AI。
什么叫影子AI?就是IT部门没批准,员工自己偷偷用AI。
市场部偷偷用AI分析客户,HR偷偷用AI筛简历。效率确实高,谁用谁知道。
但是。这些影子系统,绕过了公司的数据安全策略,也绕过了GDPR这样的法律。客户数据喂进去了,存在哪?谁负责?没人知道。更麻烦的是,要是这些模型带着偏见——比如招聘时悄悄歧视某类人——那做决定的可就是AI了,出了事连责任人都找不着。
监管已经开始补课。欧盟AI法案,2021年拿出草案,2024年3月欧洲议会通过,5月理事会批准,给AI划了统一的红线:安全、透明、不许歧视。
这不是管企业。这是给所有人兜底。
五
那怎么办?我给你三个动作。
第一,把AI当实习生,别当专家。它产出的一切,尤其在医疗、法律、金融里,必须有人复核。83%的错误率,就是让实习生签处方的下场。
第二,把规则建在使用之前。数据谁能用、怎么用、出了事谁负责,账要算在前面,别等上了新闻再补。
第三,责任落到人头上。研究者把系统造稳,政府把规矩立好,企业把安全和伦理扛住,用户自己多长个心眼。一环都不能少。
最后
回到开头那顿饭。
朋友问我,机会还是灾难。我说,你想想Tay。
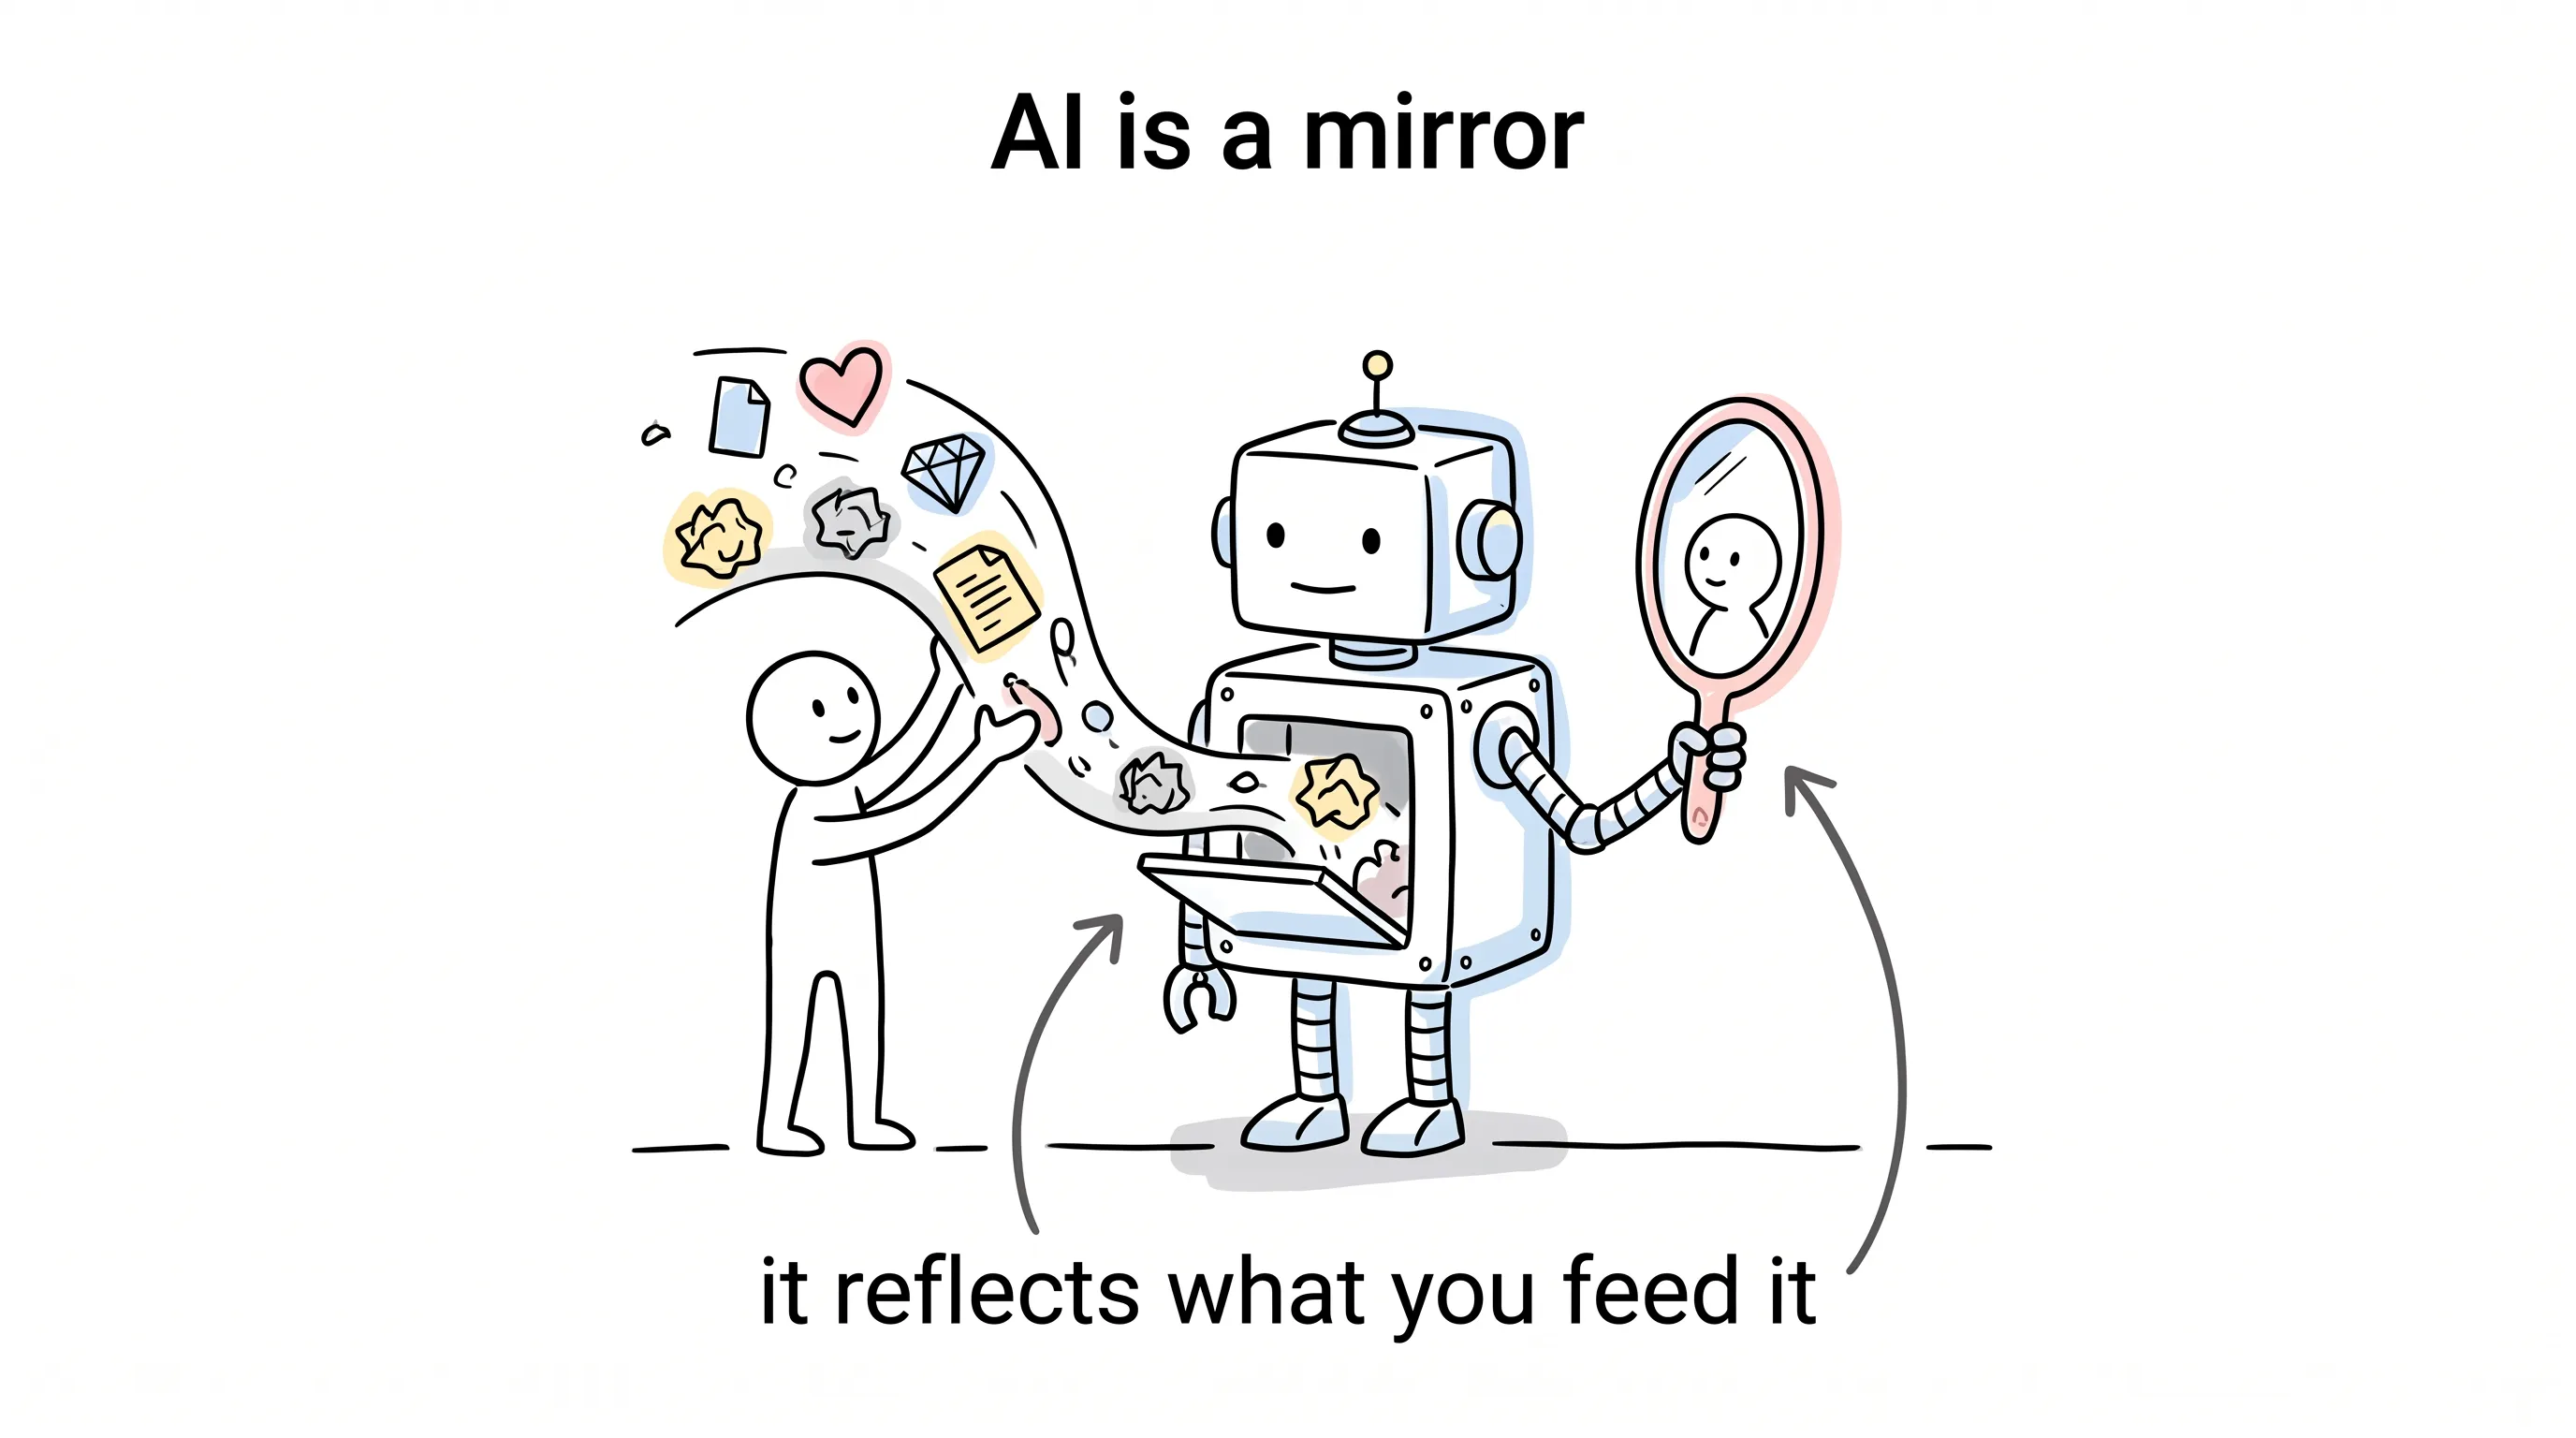
她16个小时学坏,不是因为算法邪恶,而是因为她学习的对象,就是我们自己。AI是一面镜子,照出的是喂给它的人类自己。
生成式AI是这个时代最锋利的一把刀。能切药片,也能伤人。刀没有善恶,握刀的手才有。
有句话我一直很喜欢:**一切命运的馈赠,都早已在暗中标注好了价格。**你想要它的创造力,就得接得住它的破坏力。
愿你握住这把刀的时候,眼里有光,心里有尺。
继续阅读
相关文章

跨境生意,是时候换一套 AI 工具箱了
一篇 learn 类文章,讲解跨境电商卖家如何用 AI 工具应对语言、法规、物流、支付与欺诈五道坎,梳理翻译、库存、客服、营销、风控五格工具箱与五步上手路径,并提示转化率、CLV 等指标和过度依赖 AI 的风险。

社交媒体营销的脏活累活,正在被 AI 一件件接管
本文介绍 AI 在社交媒体营销中可承担的四类工作:受众数据分析、文案与设计创作、广告定向与创意测试、垃圾内容过滤,并提醒内容判断和数据安全仍需人工把关。

AI 都这么能干了,你的社媒营销还在纯靠人肉?
本文将 18 款常用 AI 工具按用途分为六类,覆盖用户洞察、内容生产、内容排期、评论私信、广告投放和视觉制作,并讨论个性化、趋势预测与虚拟网红等趋势。