
把AI装进营销部,到底分几步?
本篇双语学习文章讲解将生成式AI引入营销部门的MARK-GEN七步框架,并以服装行业的虚拟试穿模型SVTON和照片生成视频的FashionFlow为例,同时指出训练周期长、算力成本高、数据工作量大等局限。
前段时间,一个做女装电商的朋友约我吃饭,诉了一晚上苦。
他做线上服装店,卖得还行,但有个数字让他头疼:退货率。
顾客买衣服,隔着屏幕,看不见真人上身。模特图再漂亮,穿到自己身上是另一回事。犹豫半天,干脆买回来试试。不合适,退。
我说,那你为什么不让顾客下单前,先"试"一下?
他说,试?隔着屏幕,怎么试?
我说,现在能试了。用AI。
他愣住了。
别笑。这件事背后,藏着一个比"试衣服"大得多的话题:一家企业,想把生成式AI真正装进自己的营销部,到底该从哪儿下手?
老三样,走不动了
先看看,大部分企业的营销,在靠什么。
社交媒体,搜索引擎,电子邮件。
没错,这三样老当益壮。社交媒体上做内容、投广告,能带来互动;搜索引擎是很多人上网的入口;电子邮件便宜、直达、骚扰感低。
但它们有个共同的命门:内容和渠道,是分开的。
渠道是现成的,内容得靠人做。文案要人写,图要设计师修,视频要团队剪。想给一万个顾客做一万个版本?想想成本吧。
麻烦的是,这些路本身,也开始难走了。
社交媒体上,个性化是一把双刃剑。推得不够准,顾客没感觉;推得太准,又像偷窥。这有个说法,叫"个性化悖论"。有个流传挺广的数字:72%的顾客,一旦觉得隐私被冒犯,就会直接跟这家公司说再见。
搜索引擎那边也不太平。有人统计过:搜索结果页里,六成到八成的人点的是自然排名,点广告位的只有一到四成。想靠搜索引擎优化冲前排?可以。但搜索引擎隔三差五改算法,你得跟着不停调,又贵,又没有保证。
老三样,都是"把顾客领到货架前"的手艺。可货架上的内容,还是靠人一刀一刀刻出来的产能。
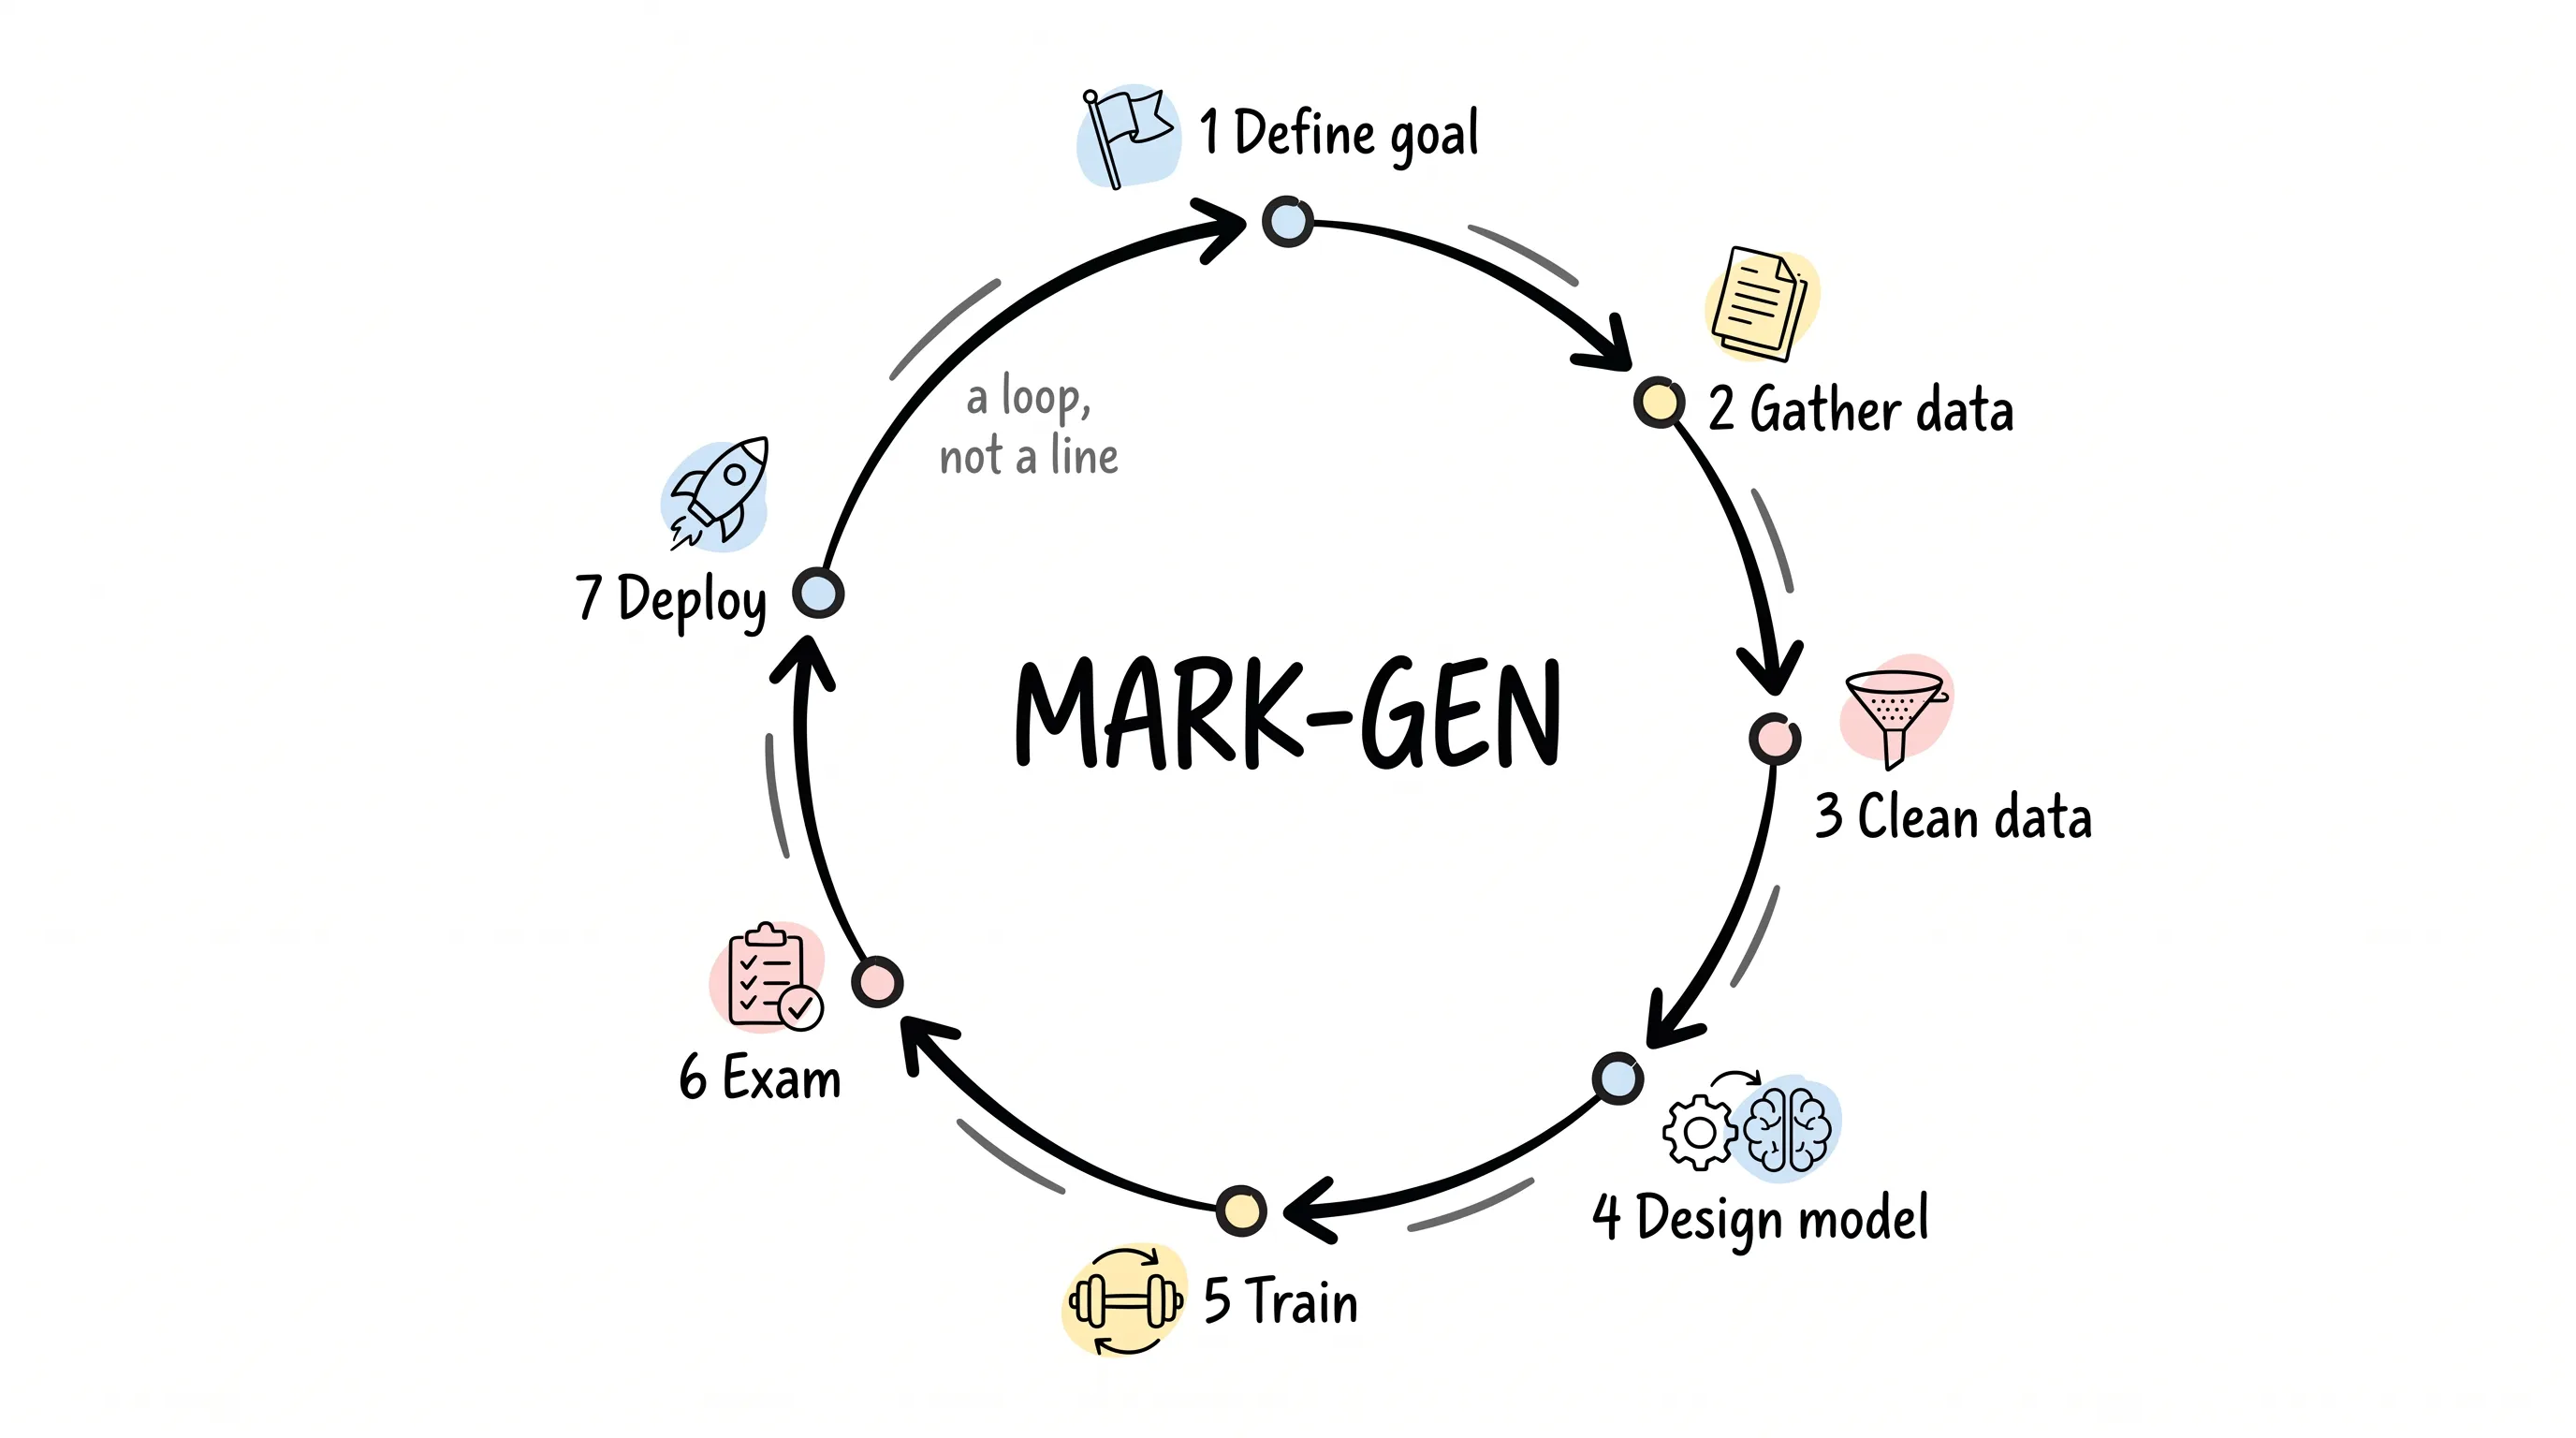
2024年,有一组研究者认真回答了这个问题。他们提出了一套框架,叫MARK-GEN。要回答的问题就一个:一家企业,想自己动手养出一个会做营销内容的AI,分几步?
我给你讲讲。七步。
什么叫MARK-GEN?七步
第一步,定目标。你想让AI帮你推广什么?想传达什么?先想清楚,别上来就闷头喂模型。
第二步,收数据。想让AI生成打动人的内容,就得让它见过足够多的真实样本。
第三步,洗数据。原始数据是脏的,视频、文字、图片混在一起,得筛,得整理,还要切出一块留作"考卷"。
第四步,设计模型。从零写,或者站在别人肩膀上改,都行。
第五步,训练。让模型反复做题,反复调参,直到输出的东西像样。
第六步,考试。用没见过的新数据测它,看它是真学会了,还是只会背题。
第七步,上线。接进真实业务,算效果。
听起来像流水线?不是。这套框架最聪明的地方在于:**它是个圈,不是一条线。**任何一步不合格,都可以退回去重来。
研究者选的例子,是服装行业。为什么?因为服装营销极度依赖"上身效果",是图像类问题里最难啃的一块。这块都能啃下来,别的行业更不在话下。
他们做了两个实验。我讲给你听。
第一个故事:让顾客"云试衣"
假设你开一家线上服装店,名字随便取,就叫Clothing Ware。
你手里有一个叫SVTON的虚拟试穿模型。它能干什么?把一张衣服单品图,和一张顾客的照片,"缝"在一起,生成一张你穿着这件衣服的图。
听起来简单,里面是三步功夫。
先"认人":找出身体的哪些部位该配合这件衣服。再"掰衣":把衣服图片做几何变形,掰弯、缩放、挪位,让它贴合顾客的身形,连自然的褶皱都补画出来。最后"合成":把人和衣融成一张图,该露出的手臂,也生成得妥妥帖帖。
你想想看,像不像一个AI裁缝?
训练它的数据,是个叫VITON的数据集:一万六千多张专业模特图,每张都配着对应的单品图。一万四千多张拿来练,两千来张留着考试。后来原版因为版权问题下架了,社区又做了个高清版VITON-HD,分辨率直接翻了两番。
这套系统上线后,有两种玩法。
第一种,投放。拿到顾客授权的数据后,给顾客生成"专属试穿图",做成广告横幅,投到第三方网站上。你想想看,顾客刷到广告,看到的是自己穿着那件外套。这个点击率,和一张千篇一律的模特图,是一个量级吗?
第二种,进店。把试穿功能装到自家官网,顾客上传照片,自己挑衣服试。试明白了,再下单。
算笔账:看得准了,买错变少,退货变少;顾客满意,复购上涨;退货少了,来回运输的碳足迹也跟着降。一个小小的试穿模型,牵动的是整条生意的账。
生成的图精细到什么程度?衣服的纹路和细节都保得住。太强了。
第二个故事:一张照片,变一段视频
衣服静着不动,是打不动现在这批顾客的。得动起来。
拍视频?请模特、租影棚、排日程,一天下来都是钱。
这套框架里的第二个实验,用一个叫FashionFlow的模型,干了件更狠的事:给一张静态的服装照,直接生成一段视频。
它靠的是扩散模型。什么叫扩散模型?你可以想象成"先弄脏,再洗干净":把一张图不停加噪点,加到面目全非;然后训练AI学会反向操作,一层层把噪点洗掉。洗着洗着,一张全新的图就出来了。把这套逻辑搬到视频上,模型就能"脑补"出一张照片之后的画面,生成一段流畅连贯、缓缓展示衣服的视频。
前几年,手机修图应用Lensa能爆火,背后也是这套扩散逻辑。
训练数据,是个叫Fashion的数据集:五百条视频拿来练,一百条拿来考,每条三百多帧,各种角度、各种体型、各种材质。
最妙的是,这个模型还能和第一个故事接上:先用试穿模型生成顾客专属的试穿图,再让它动起来。顾客看到的,是自己穿着这件衣服在转圈。
研究里管这种愉悦,叫"享乐价值"。说白了,就是顾客觉得好玩、觉得爽。觉得爽,就愿意掏钱。
冷水,得泼一盆
讲到这儿,你可能会想,这不就是印钞机吗?
先别激动。这套框架的局限,提出者自己也讲得很清楚。
慢。深度学习模型的训练,动辄几周,甚至几个月。你的营销要是得追热点、天天变,这套打法根本转不过来。
贵。模型训练和运行,吃的是GPU这类专用算力。自己买,很贵;租服务器,便宜些,但这笔钱怎么都省不掉。
脏活累活多。数据这一关,要占掉整个项目八成到九成的时间。一万六千多张图,不是天上掉下来的。
还有一层风险:AI生成的人像,未必真是"你"的样子。生成得不像,甚至误导了顾客,反而砸自己的招牌。
所以这套东西,更像重型装备,别当瑞士军刀使。
回到那顿饭
饭局最后,我把这两个故事讲给了我朋友。
我说,你的问题,从来不止是退货率。你的问题在于,顾客在下单之前,从没有真正"见到"过衣服穿在自己身上的样子。
现在,框架有了,开源的模型也有了,连代码都摆在GitHub上了。
他还愣在那儿。
我想,他大概在算另一笔账:这套东西,我的公司养得起吗?
这个问题,我也没有答案。但可以肯定的是,营销这场仗,已经从"谁的渠道多",打到了"谁的内容产能大"。
渠道人人都有,内容产能正在分化。
这件事,正在发生。
继续阅读
相关文章

跨境生意,是时候换一套 AI 工具箱了
一篇 learn 类文章,讲解跨境电商卖家如何用 AI 工具应对语言、法规、物流、支付与欺诈五道坎,梳理翻译、库存、客服、营销、风控五格工具箱与五步上手路径,并提示转化率、CLV 等指标和过度依赖 AI 的风险。

社交媒体营销的脏活累活,正在被 AI 一件件接管
本文介绍 AI 在社交媒体营销中可承担的四类工作:受众数据分析、文案与设计创作、广告定向与创意测试、垃圾内容过滤,并提醒内容判断和数据安全仍需人工把关。

AI 都这么能干了,你的社媒营销还在纯靠人肉?
本文将 18 款常用 AI 工具按用途分为六类,覆盖用户洞察、内容生产、内容排期、评论私信、广告投放和视觉制作,并讨论个性化、趋势预测与虚拟网红等趋势。