
Google 把 AI 搜索的"拆单员"换成了小模型:R4T-Diffusion
前两天刷到 Google 官方博客发的一篇文章,介绍一个叫 R4T-Diffusion 的新框架。看完我第一反应是:太强了。
前两天刷到 Google 官方博客发的一篇文章,介绍一个叫 R4T-Diffusion 的新框架。看完我第一反应是:太强了。
你可能没听过这个名字。但如果你用过 AI 搜索,你已经享受过它背后的那套动作了。
我先给你讲清楚这套动作。
什么叫 query fan-out?
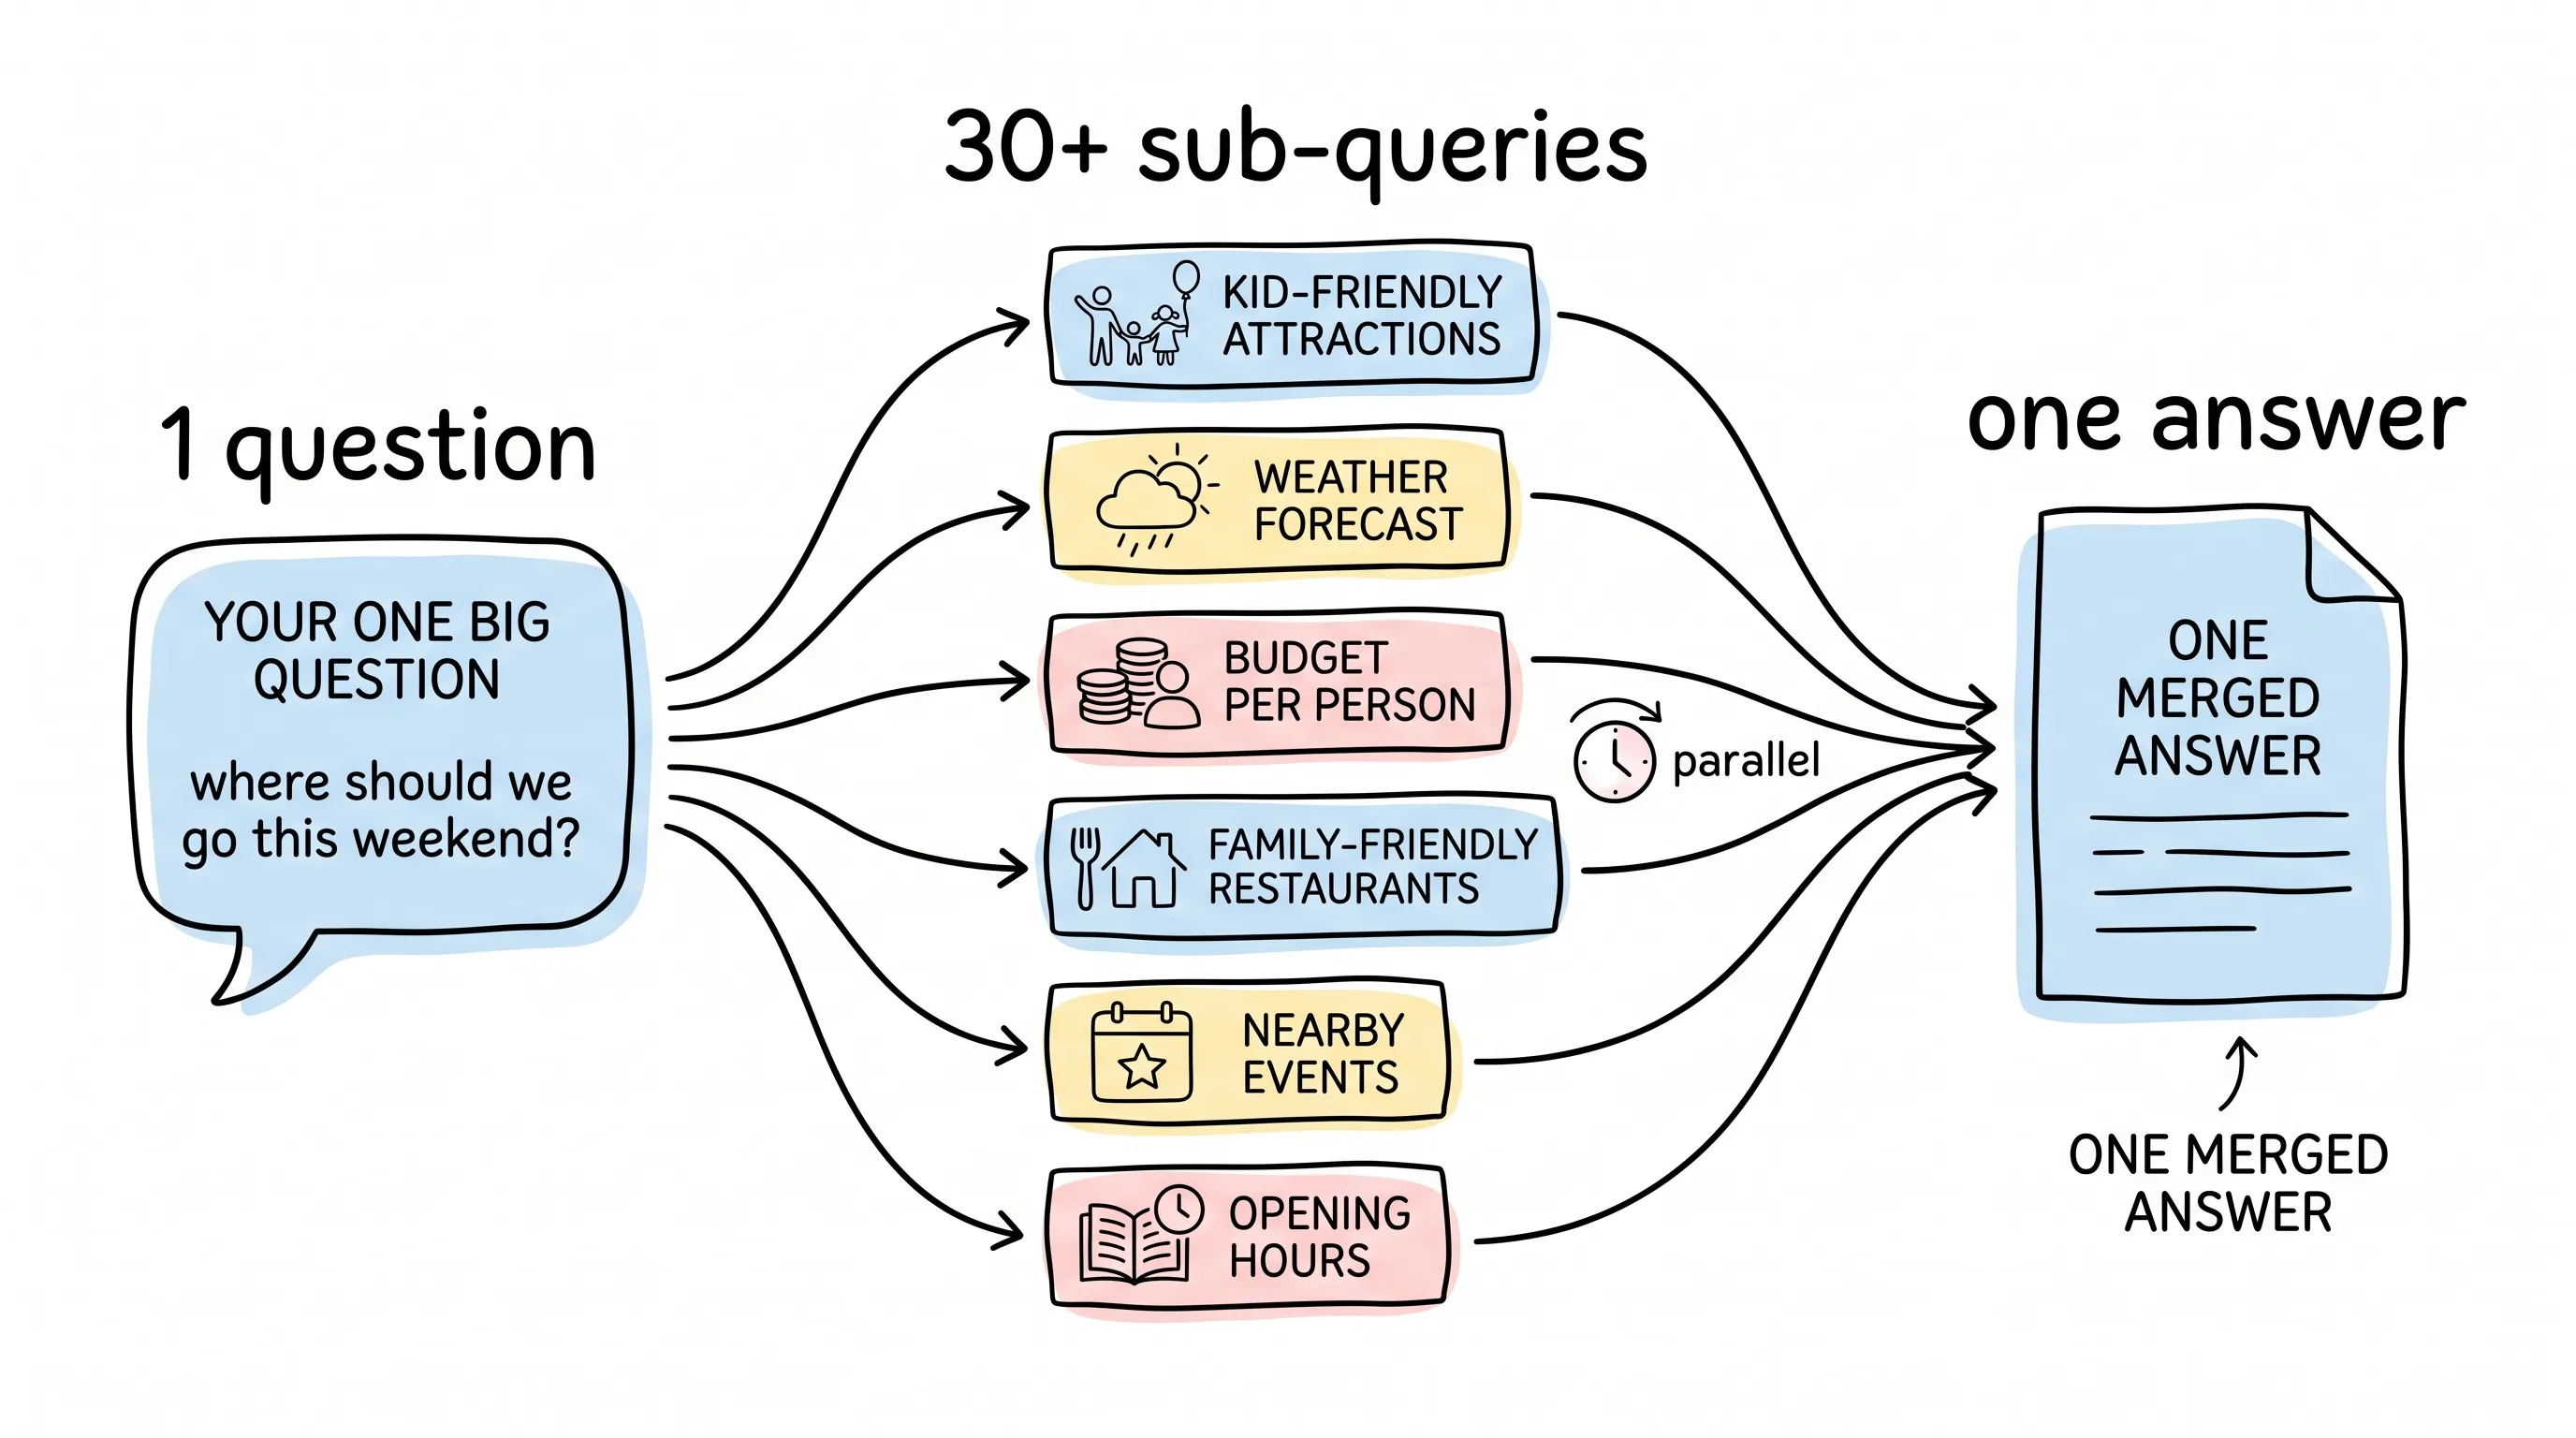
你在 AI 搜索里问一个问题,比如"帮我想想周末带家人去哪儿玩"。
这个问题很宽泛。AI 不会只拿着这一句话去搜。它会把你的大问题,自动拆成十几个、几十个小问题:适合小孩的周边景点、天气预报、人均预算、亲子餐厅……
拆完,分头去搜,再把结果汇总成一个答案。
这个"把一个问题拆成一群问题"的动作,就叫 query fan-out。你可以把它想象成一个特别能干的助理:老板一句话,他拆成一堆工单,分发给不同的人去办,最后把结果拼成一份报告。
问题是,拆单这个活,很贵。
拆得越广,搜索覆盖面越大,答案质量越高。但拆得多,意味着算力烧得多、时间等得久。这是老大难:要么拆得又广又好但慢得像蜗牛,要么快但拆得敷衍。
Google 这次干的事,就是把"拆单员"换了。
怎么换的?
论文里的方案,拆开看就三步。
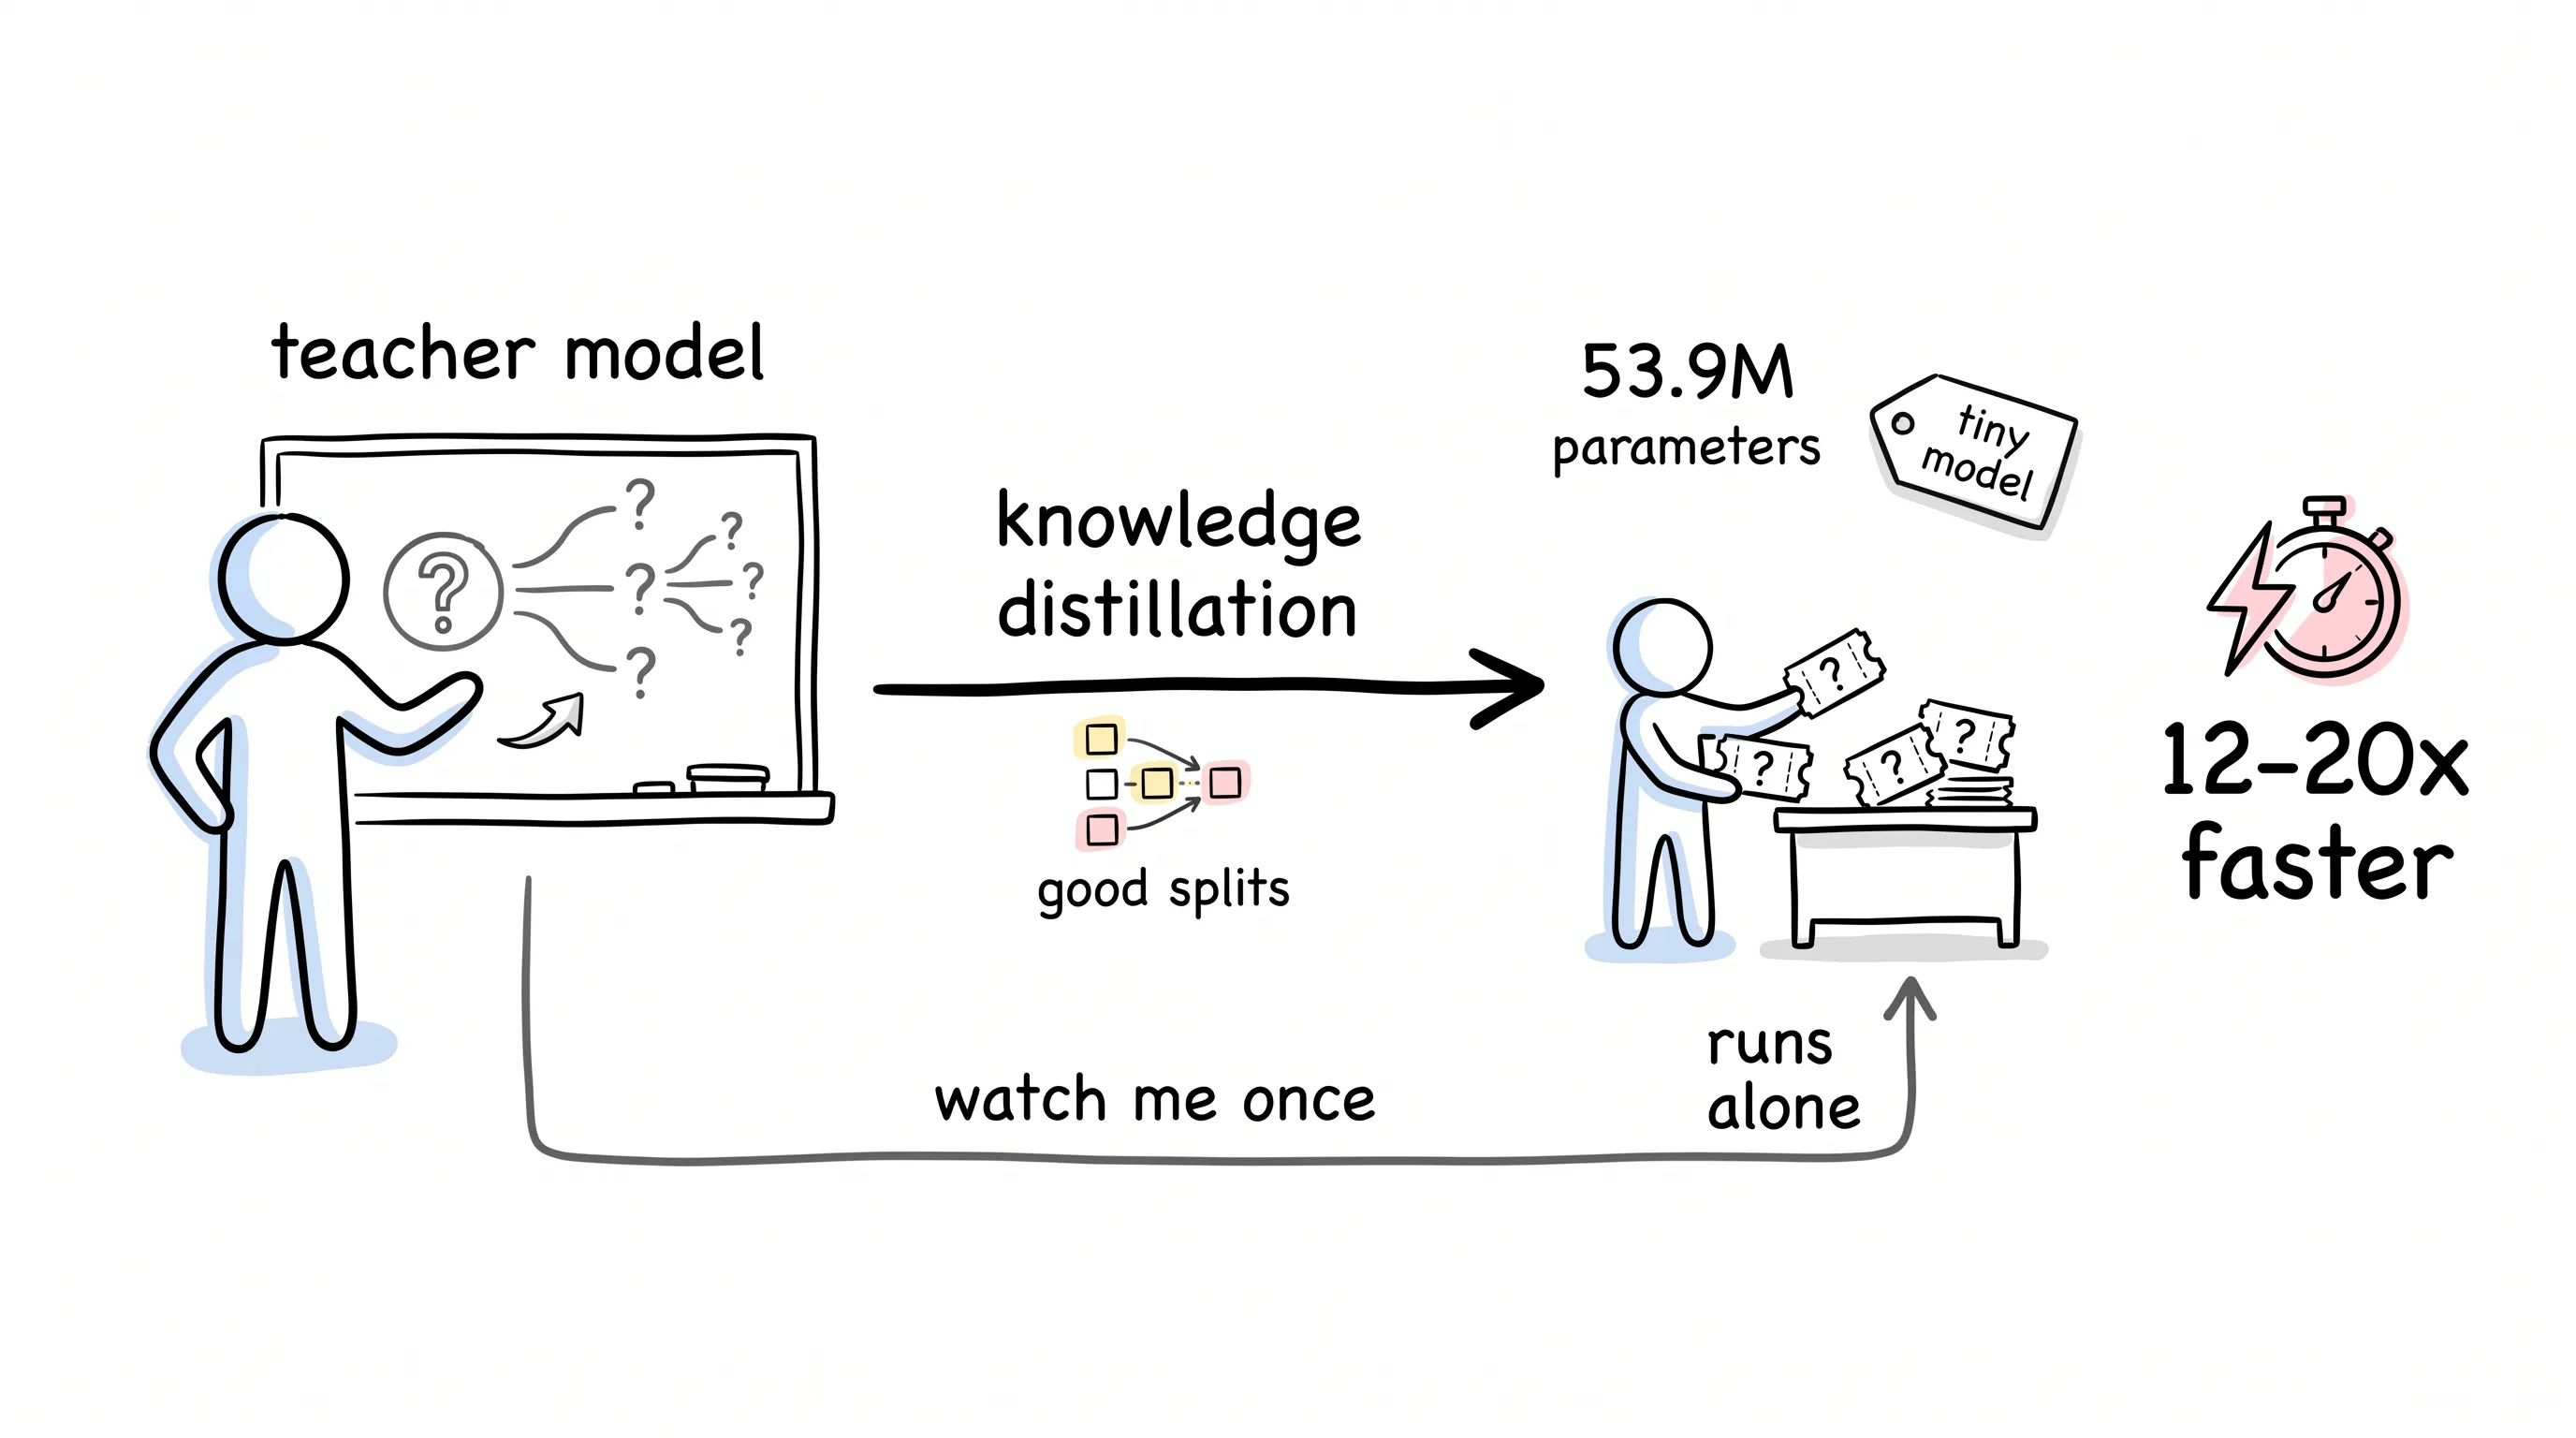
第一步,用强化学习训练一个大模型,让它知道"什么样的拆法是好拆法"。
第二步,把这个大模型的高质量拆单输出,攒成一批样本。
第三步,训练一个只有 5390 万参数的小模型,让它模仿大模型的行为。
5390 万参数,什么概念?在动辄千亿参数的大模型时代,这是个袖珍选手。
这套"大模型示范、小模型模仿"的打法,有个名字,叫知识蒸馏。2015 年,当时还在 Google 的 Jeff Dean 参与开创了这条路:把大模型的能力,转移给一个小得多的小模型,让小模型用极低的成本,干出大模型八成的活。
说白了就是:师傅出一次手,徒弟偷学到手,以后出活就不用再惊动师傅了。
拆得好的标准是什么?
你可能会问,凭什么说小模型拆得比以前好?
论文里给"好拆法"定了三条标准,我用大白话翻译一下。
第一,不瞎问。拆出来的每个子问题,都得能在真实的数据库里找到对应的东西。不能问出一个个根本查无此物的问题。
第二,不重复。模型用了个叫 Vendi Score 的指标来衡量多样性,逼着它把语义撒得足够开。你不能拆出"周边景点""附近的景点""附近好玩的地方",这是三个同义词,不是三个问题。
第三,不跑题。所有子问题都得拴回你最初那个大问题上,不能拆着拆着飘到九霄云外。
不瞎问、不重复、不跑题。这九个字,就是这套框架的核心。
到底快多少?
来算笔账。
按论文的说法,以前的生成方式像排队一样,一个问题接一个问题往外蹦。批量一大,延迟会一路涨到接近 50 秒。
50 秒什么概念?你在搜索框里敲完字,泡了杯茶回来,答案还没拆完。
而 R4T-Diffusion 是所有目标方向一口气同时生成,延迟压在亚秒级到几秒之间。官方的说法是,比自回归方案快 12 到 20 倍,延迟瓶颈直接给"砸穿"了。
快 12 到 20 倍,算力还省一大截。这就是"production ready"(生产可用)这几个词的底气。
只能用来搜索吗?
不是。
论文里明确列了这套框架的用武之地:推荐系统,比如 Google Discover、YouTube 的推荐;创意搜索;探索式的信息获取。
再往深想一步。论文作者认为,这套用强化学习合成对齐训练数据的思路,还能推广到答案本来就模糊、主观的结构化生成任务:规划、设计、创意生成。
这就有意思了。哪里没有标准答案,哪里就可能用得上它。
已经上线了吗?
这是我最关心的部分,也是我最没把握的部分。
时间线很有意思:论文今年 3 月就发了,博客 9 月 15 日才发,中间隔了整整半年。
Google 一贯的风格是:东西上了线,才会大张旗鼓写博客。这半年的时间差,很可能就是在悄悄试、慢慢推。
旁证也有一点。最近社交媒体上,有人说自己注意到 AI Mode 里展示的链接变多了,有人说流量涨了,还有人猜是某次没官宣的更新。
但这些都是猜测,没有实锤。
论文里比博客多说的那句话
有个细节,我想单独拎出来说。
博客里通篇是"生产可用""专家级搜索",一片叫好。但论文的结尾,研究人员加了一段博客里没有的话:R4T 在时尚、音乐这类领域表现很好,可在敏感场景里,它可能放大偏见。要部署,就得先做领域专属的偏见审计,配上监督机制。
论文的意思是:R4T 是个工具,工具之外,还得有人类的判断和把关。
我特别喜欢这句提醒。技术越能干,越要有人拽着缰绳。
最后
回到开头那个画面:你问 AI 一个大问题,它背后悄悄拆成几十个小问题,分头去查,再给你一个漂亮的答案。
以前,这个"悄悄"的成本很高。现在,一个小模型就能把它做到又快又好。
把贵的智慧,练成便宜的本能。这可能是 AI 圈里最划算的一门生意。
至于 Google 是不是已经把它用上了?半年前为什么不声不响?
我也不知道答案。但下次你在 AI 搜索里看到答案变快、链接变多的时候,可以想想背后是不是有个 5390 万参数的小模型,刚刚替你拆了三十个问题。
这是我的感觉,不一定对。
继续阅读
相关文章

跨境生意,是时候换一套 AI 工具箱了
一篇 learn 类文章,讲解跨境电商卖家如何用 AI 工具应对语言、法规、物流、支付与欺诈五道坎,梳理翻译、库存、客服、营销、风控五格工具箱与五步上手路径,并提示转化率、CLV 等指标和过度依赖 AI 的风险。

社交媒体营销的脏活累活,正在被 AI 一件件接管
本文介绍 AI 在社交媒体营销中可承担的四类工作:受众数据分析、文案与设计创作、广告定向与创意测试、垃圾内容过滤,并提醒内容判断和数据安全仍需人工把关。

AI 都这么能干了,你的社媒营销还在纯靠人肉?
本文将 18 款常用 AI 工具按用途分为六类,覆盖用户洞察、内容生产、内容排期、评论私信、广告投放和视觉制作,并讨论个性化、趋势预测与虚拟网红等趋势。