
亚马逊的客服,可口可乐的文案:大公司的 AI,都用在哪儿了?
一篇科普文章,梳理亚马逊、可口可乐、摩根大通、Netflix、Spotify、《纽约时报》和 IBM 等大公司在客服、文案、报告处理、推荐、广告和医疗辅助等场景使用 AI 的公开做法,并用通俗语言拆解大模型背后的技术原理。
前段时间,一个做快消的朋友约我喝茶。
落座第一句话就问:大模型这东西,除了帮大家写周报,到底还能干嘛?
我说,你别急。这个问题,问概念没用,得看动作。
看谁的动作?看大公司。他们人最多、钱最多、数据最多,试错成本也最高,所以动作最诚实。他们真金白银砸下去的地方,基本就是这门技术眼下最值钱的用法。
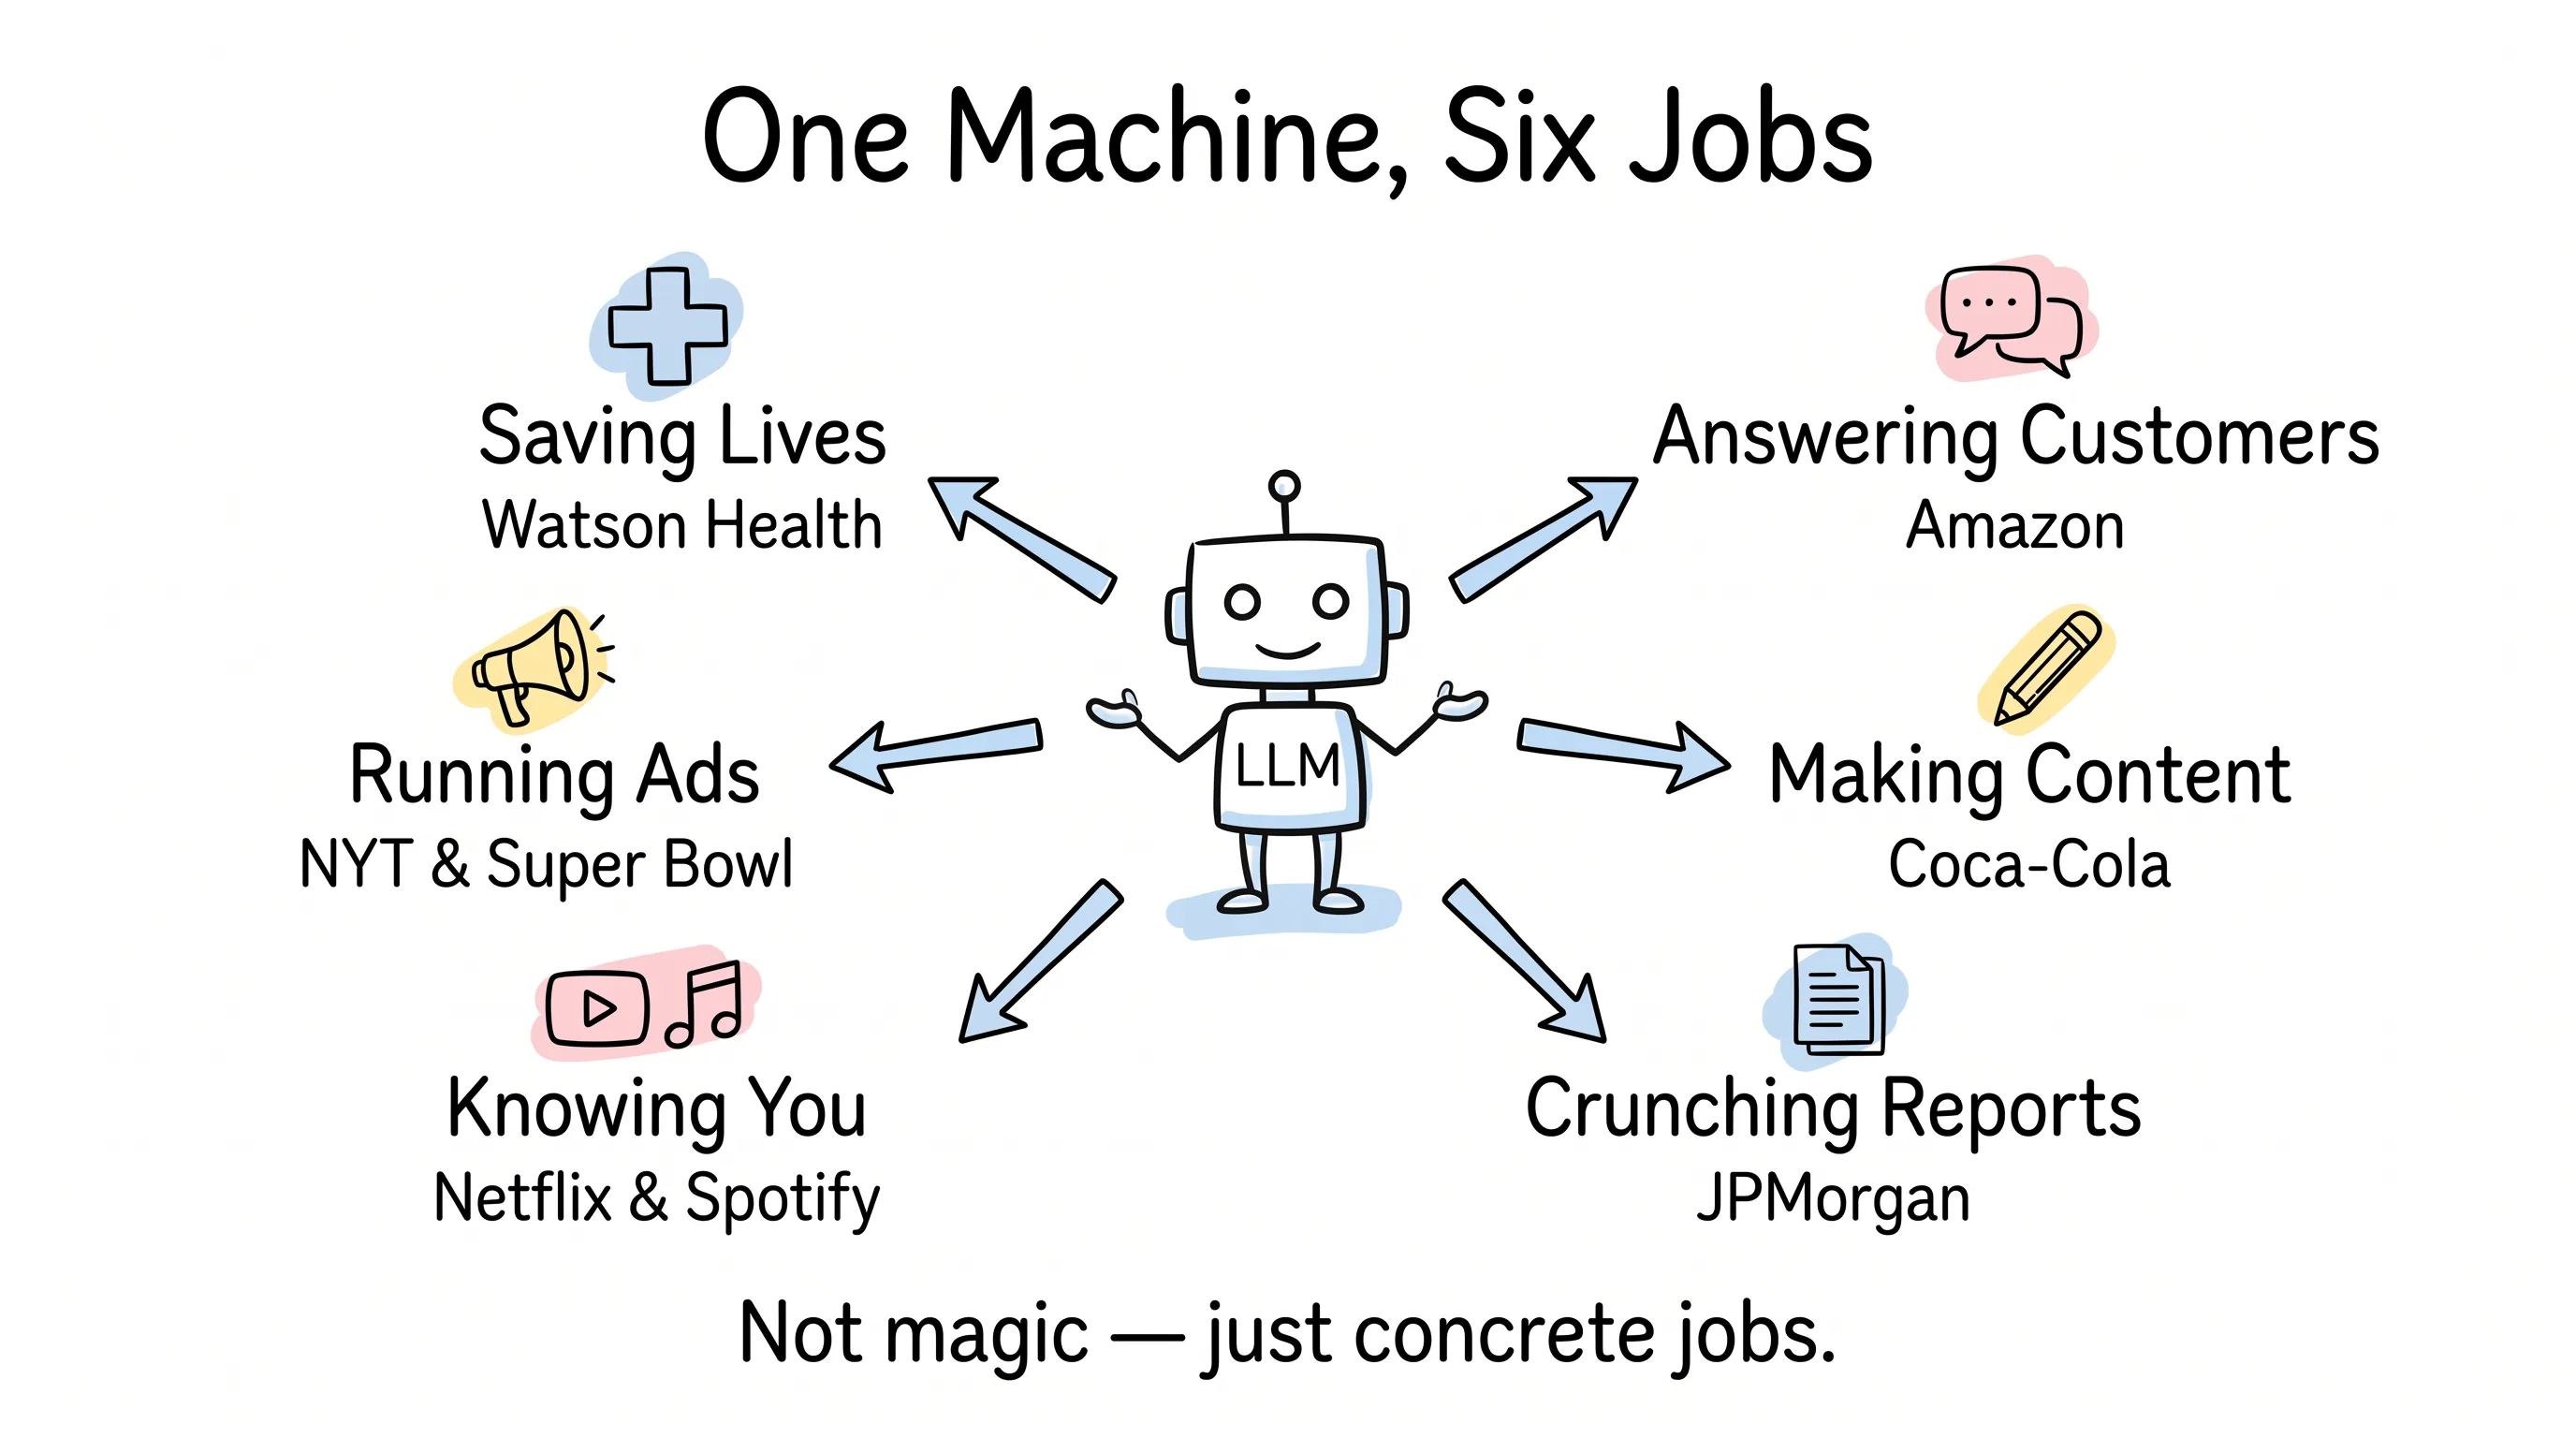
这几年,我陆续翻了不少公司的公开做法:亚马逊、可口可乐、摩根大通、Netflix、Spotify、《纽约时报》,还有 IBM。越看越觉得有意思。今天我带你逛一圈。
逛完你就明白:大模型不玄。它就是几样很具体的活儿。
第一件活儿:接客
先说离你最近的,客服。
你有没有发现,这两年找电商平台问问题,回复变快了?以前排队等人工,现在很多问题,秒回。
什么叫好的客服?说白了就两条:快,和对。
前一条,机器天生擅长。亚马逊很早就把大语言模型塞进了自己的聊天系统里,背后用的正是自家的 Amazon Lex。它能听懂你用大白话描述的问题,然后给出靠谱的答案。问题被听懂了,解决得快了,满意度自然上去。
但真正让我觉得值钱的,是下一个动作。
亚马逊没有把客服全交给机器。复杂的问题、绕来绕去的纠纷、带着情绪的投诉,照样交给人。
为什么?因为机器接得住常规问题,接不住人心。查订单、催发货、退换货,这类问题占大头,机器回得又快又稳;剩下那些一句话说不清的,还得人来。
AI 负责快,人负责难。这个队形,比「全部换成 AI」聪明得多。
这是我看到的第一课。
第二件活儿:造内容
再说可口可乐。
这个品牌最值钱的资产之一,是它的声音。热情、快乐,一百多年没变过味儿。这个声音能撑这么久,靠的是无数文案、海报、帖子,一天一天垒出来的。
现在,他们把 OpenAI 的 GPT-4 拉进了内容流水线。
第一个用途好理解:写。社媒帖子、营销文案、资讯内容,量大,还必须是可口可乐味儿。GPT-4 生成的东西有个特点,像人话。这就保证了不管发在哪个平台,品牌的声音不散。
第二个用途更有意思:反着用。让它去啃海量的消费者数据和行情信息,吐出规律和报告——最近大家喜欢什么?消费习惯在往哪儿偏?
写出去是嘴,看进来是眼睛。
同一个模型,一头管说,一头管听。
第三件活儿:啃报告
第三家,摩根大通(JPMorgan Chase)。它干的事不性感,但更硬。
银行每天面对什么?成堆的法律文件、财务报告,全是没结构的文字,全是术语。一个人读一份,要很久;读的人累了,还会看漏。
摩根大通用 IBM 的 Watson 来干这个活。靠自然语言处理,Watson 能快速啃完海量非结构化文本,精度还很高。原来要耗掉大量人天的工作,压成机器的几分钟。
省时间是明面上的好处。暗地里的更值钱:机器不累,不会因为看了八小时文件而看漏一行。出错概率降下来,结果可靠了,客户那头感受到的服务质量也跟着上去。
Watson 还有第二份工:抓坏人。机器学习模型盯着交易流水,一刻不停。哪笔交易的模式不对劲,马上标记出来。人眼盯不过来的东西,它替你盯着。
第四件活儿:懂你
接下来这两家,你大概率天天在用:Netflix 和 Spotify。
我把它们放一起讲,因为它们干的是同一件事:猜你喜欢。
Netflix 看你的观看记录、每一次点击和停留,慢慢拼出你的口味画像,推你可能爱看的剧。Spotify 看你的收听习惯、你建的歌单、你单曲循环了什么,预测你下一首会爱上的歌。
说白了,Spotify 就是一个懂你的私人 DJ:你还没开口,他已经知道你想听什么。
对了,这两家的推荐系统里,都有 BERT 这类语言模型的影子。你的每一次点击,都是一句话。机器在逐字读你这本日记。
你的每一次滑动都在投票。它们赢,赢在比你更懂你自己。
第五件活儿:放广告
广告这事,也被重新做了一遍。
一家是《纽约时报》。他们用 OpenAI 的 GPT-3 帮广告主干两件事:一是根据广告内容,推荐更好的投放位置;二是找出以前够不着的细分人群。投放更准了,广告主的钱花得更值了。
另一拨,是超级碗。这项比赛每年上亿人观看,是座数据金矿。生成式 AI 把观众数据嚼碎,按偏好和行为分组,给不同的人看不同的广告。
同一条 30 秒广告,从千人一面,变成千人千面。
第六件活儿:救命
最后一件,我最想说。因为它关乎性命。
IBM 的 Watson Health 在医疗方向干的活,叫临床决策支持。简单说:医生看病的时候,它在旁边把海量医学文献和患者数据翻一遍,给出有证据支撑的诊断和治疗建议。
医生也是人,人的阅读量有上限,而医学文献每天都在涨。旁边坐着一位读过「全部文献」的助手,诊断的依据就多一层,流程也快一截。它还能从数据里看出疾病流行的苗头,帮着做早期发现和预防。
这种用法,真好。比写诗画画实在多了。
底下是同一台机器
六件活儿讲完了。你可能想问:客服、文案、风控、推荐、广告、医疗,八竿子打不着的六个领域,用的真是同一门技术?
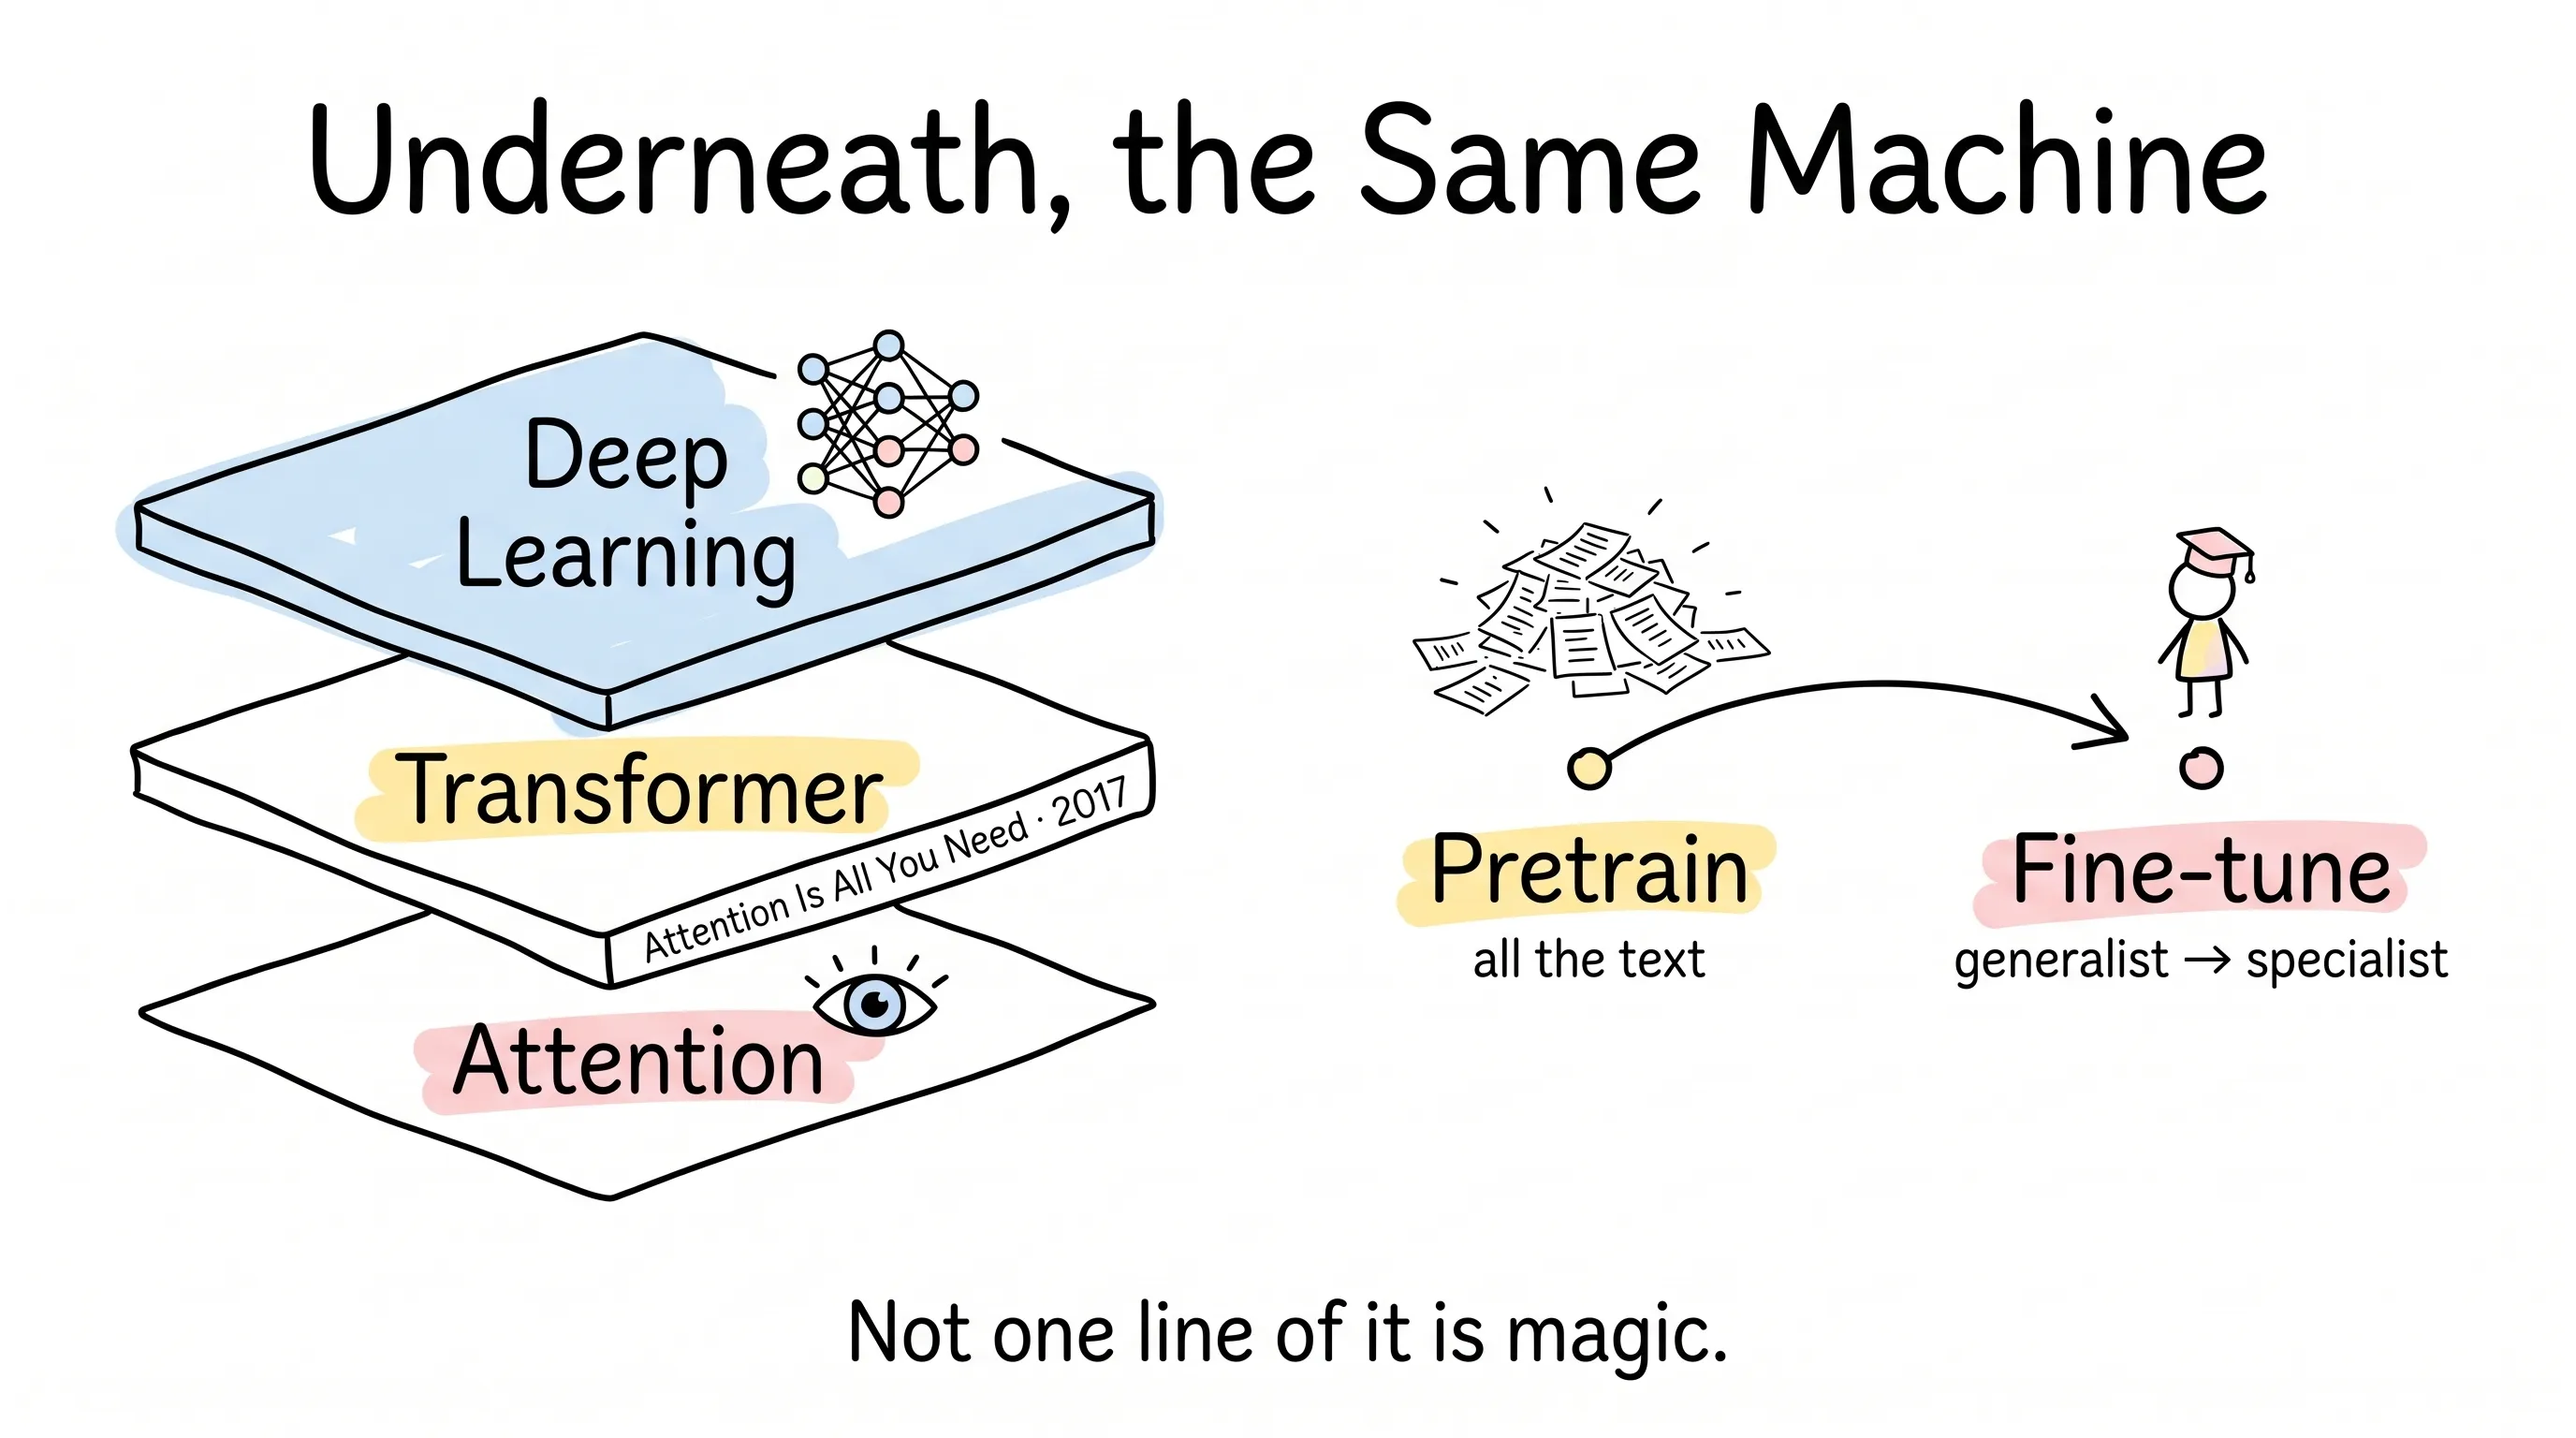
是。而且底下那台机器,拆开看没那么神秘。
第一层,深度学习。很多层的神经网络,一层一层加工文字。
第二层,Transformer。2017 年,有篇论文叫《Attention is All You Need》,提出的这个架构,是今天绝大多数大模型的地基。它的本事,是处理好文字里隔得很远的关联。
第三层,注意力机制。让模型在生成每个词的时候,知道该重点看输入里的哪几个词。就像你听人讲话,会自动抓重点。
然后是训练方法:先预训练,用天文数字的文本学会语言的通用规律;再微调,用专门的数据,把通用选手练成专项选手。
还有分词,就是把你的输入切成一小块一小块的 token,模型只认 token。以及怎么给模型打分(困惑度、BLEU 这些指标),怎么给它套上安全和伦理的笼头。
清单就这么几条。没有一条是魔法。
回到那杯茶
那天喝茶,我最后跟朋友说:你问大模型能干嘛,这个问题问反了。
该问的是:你的业务里,哪件事量极大、有规律、但特别耗人工?那件事,就值得先交给它。
客服是这样,文案是这样。读报告、做推荐、放广告、辅助诊断,全是这样。从亚马逊的客服,到可口可乐的文案,到摩根大通风控、Salesforce 的自动化报告,大公司买的就是这个判断。
至于那东西叫不叫 AI,不重要。
后来听说,我那位朋友回去的第一件事,是把团队三个月的客服对话记录全拉了出来,数了一遍:哪些问题占了八成?
你看,这就对了。
也祝你,早日找到属于你的那件「量极大、有规律、耗人工」的事。
继续阅读
相关文章

跨境生意,是时候换一套 AI 工具箱了
一篇 learn 类文章,讲解跨境电商卖家如何用 AI 工具应对语言、法规、物流、支付与欺诈五道坎,梳理翻译、库存、客服、营销、风控五格工具箱与五步上手路径,并提示转化率、CLV 等指标和过度依赖 AI 的风险。

社交媒体营销的脏活累活,正在被 AI 一件件接管
本文介绍 AI 在社交媒体营销中可承担的四类工作:受众数据分析、文案与设计创作、广告定向与创意测试、垃圾内容过滤,并提醒内容判断和数据安全仍需人工把关。

AI 都这么能干了,你的社媒营销还在纯靠人肉?
本文将 18 款常用 AI 工具按用途分为六类,覆盖用户洞察、内容生产、内容排期、评论私信、广告投放和视觉制作,并讨论个性化、趋势预测与虚拟网红等趋势。