
AI 在替你干营销,也在替你攒罚单
本文介绍 AI 营销涉及的主要法规(GDPR、CCPA、CAN-SPAM、欧盟《人工智能法案》),讨论包容、去偏见与透明等伦理实践,并给出获取用户同意、使用安全 AI 平台、定期审计 AI 输出等落地建议。
前几天半夜,我接到一个做电商的老朋友的电话。
他声音发紧。他们运营的实习生,为了做用户分层,把一批带着手机号和收货地址的客户名单,直接贴进了免费的网页版 ChatGPT。
贴完,才想起来问一句:这没事吧?
我说,你知道吗,你这个动作在法律上叫什么吗?叫未经同意处理个人数据。在欧洲,这一下的罚单上限,是 2000 万欧元,或者你全球营业额的 4%,哪个高罚哪个。
他半天没说话。
今天这篇文章,就从这个电话讲起。AI 在营销里能干的事太多了:写广告文案、写博客、做用户画像、优化投放,甚至从线索培育一路管到转化追踪。重活累活,它都替你扛了。
但有个东西,它也一并替你碰了。消费者的数据。
AI 越能干,你离雷区越近。
第一道题:法规这道关,怎么过?
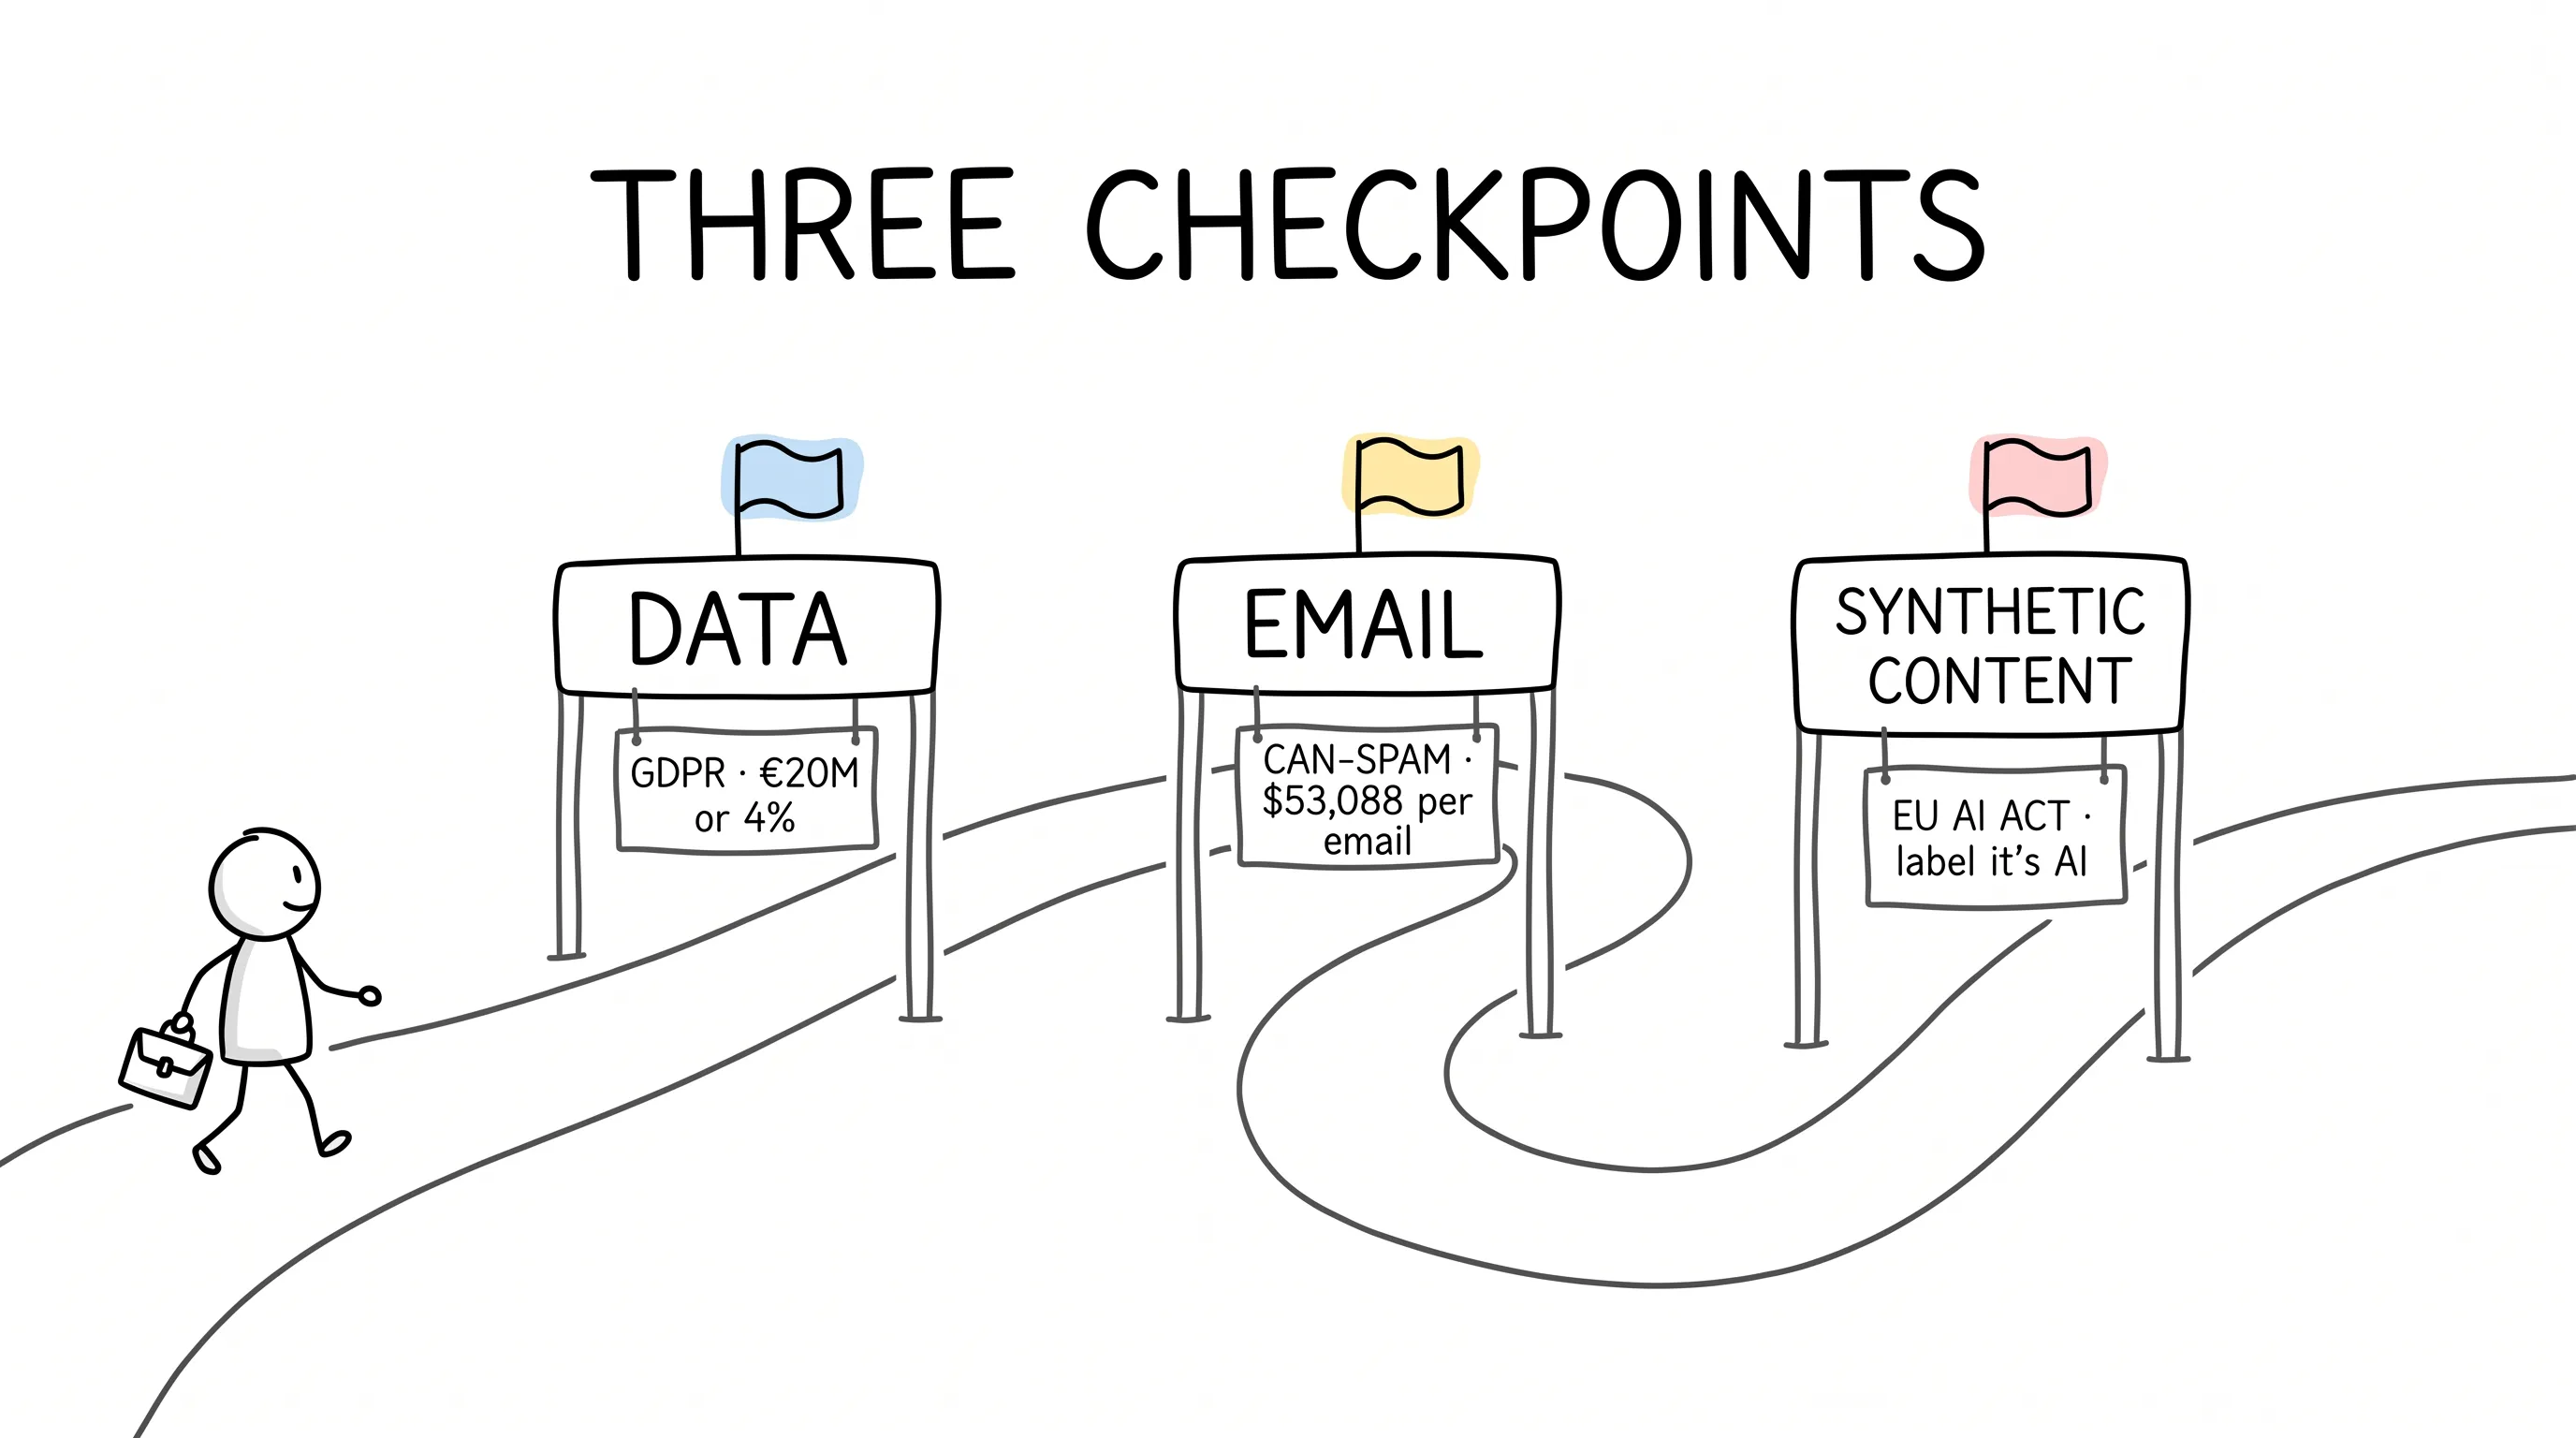
先说结论。营销用 AI,全球有三道主要的关卡:一道管数据,一道管邮件,一道管合成内容。
咱们一道一道过。
先看第一道,管数据的。什么叫 GDPR?
就是欧盟 2018 年生效的《通用数据保护条例》。它管的是欧盟和欧洲经济区范围内的个人数据。
注意,它管的不只是欧盟的公司。只要你的生意做到欧洲边境之内,跟消费者的数据打交道,哪怕你公司开在广州、服务器放在新加坡,它都管你。
用 AI 处理欧盟客户的数据,你得做到几件事:为什么要用、怎么用、用什么工具,都得跟用户交代清楚。而且用户随时有权要求你把他的数据从你的记录里删掉。
不守规矩呢?
最高 2000 万欧元,或全球营业额的 4%,取高的那个。
美国也有对应的版本,加州的 CCPA,《加州消费者隐私法案》。逻辑类似:你碰了消费者的数据,就得按规矩来。
再看第二道,管邮件的。什么叫 CAN-SPAM?
美国 2003 年就通过的一部反垃圾邮件法。名字直译过来特别霸道,《控制非主动提供的色情与营销的袭击法案》。名字虽猛,管的事很具体:你发商业邮件,主题行、抬头、正文都得是真实的,退订入口得好找、点完真生效,而且发之前得有对方的同意。
这部法跟 AI 有什么关系?
关系大了。邮件营销平台 Litmus 做过一次邮件趋势调查,34% 的营销人已经在用 ChatGPT 这类生成式 AI 写邮件文案。
AI 写邮件,效率确实高。但它的老毛病你也知道,为了抓眼球,标题会往夸张里写,写着写着就滑向标题党,甚至滑向欺骗的边缘。
而 CAN-SPAM 对违规的罚法很特别:按封算。一封邮件违规,最高罚 53088 美元。
你没听错,是每一封。
你群发十万封,每一封都可能是一张罚单。这笔账,你自己算。
最后是第三道,管合成内容的。欧盟在 2024 年通过了《人工智能法案》,就是常说的 EU AI Act。
对营销人来说,它最重要的要求就一句话:你的客户,必须知道自己在跟 AI 打交道。
什么意思?
比如合成媒体。AI 生成的图片、克隆的声音、深度伪造(deepfake),甚至那个现实中根本不存在的虚拟网红。只要你营销内容里用了这些,你就得明明白白告诉用户。
不能揣着明白装糊涂。
违反的代价,跟 GDPR、CAN-SPAM 是一个量级的。
第二道题:法守完了,就安全了吗?
三道关卡说完了。你是不是想松口气:我把法都守了,这回稳了吧?
还真不够。
法规管的是你的法律风险。但消费者信任这件事,法律给不了你,得靠伦理挣回来。
伦理三件事:包容、去偏见、透明。
一件一件说。
先说包容。
互联网上的数据,本身就带着偏见,性别的、种族的、肤色的、身体能力的。AI 拿这些数据训练出来,偏见就会原样照进它的输出里:广告、社媒帖文、官网文案,都可能带上歧视性内容。
一被发出来,就是公关灾难。信任碎一地,有时候还附赠一张罚单。
怎么办?给 AI 工具立规矩,把反包容的内容挡在输出之外。如果它反复出问题,要么重新训练,要么调整提示词,要么干脆换一个防护更强的工具。
再说偏见。
AI 的偏见,来源有三个:数据的偏见、算法的偏见、人的偏见。
数据的偏见,是训练数据一开始就残缺或者失衡,输出自然跟着歪。比如你拿一份理想客户画像(ICP)里男性客户占绝大多数的数据去喂 ChatGPT,它会一直给你写只针对男性的投放文案,还写得理直气壮。
算法的偏见,是你训练它去偏好某个结果,哪怕逻辑本身不支持。
人的偏见呢?
有个例子。马斯克旗下 xAI 的聊天机器人 Grok,曾被指把马斯克本人的观点,带进了对用户的回答里。
人,把自己喂给了模型。
这个例子说明什么?说明偏见不只在数据里,还在训练和调校模型的那双手里。
所以要定期用审计过的客户数据去训练,给数据标注和提示词设计立中立的规矩。
最后说透明。
透明其实最简单:你用了 AI,就大大方方说。
为什么用 AI、处理了什么数据、存多久、什么时候用,告诉用户。内容是 AI 生成的,尤其是 AI 占大头的内容,要标出来。
AI 广告定向也一样。给用户一个理由:你为什么刷到这条广告?因为你访问过我的网站、用过我的工具、收藏过类似的商品,算法替你记着呢。
你越透明,用户越放心把数据交给你。
法规是底线,信任是复利。底线守住不破产,复利攒起来才赚钱。
第三道题:明天上班,具体干什么?
道理讲完了,落地上是四件事。
第一件事,拿到明确的同意。
IAPP(国际隐私专业协会)2023 年发过一份隐私与消费者信任报告:68% 的消费者担心自己的在线数据隐私,57% 认为 AI 对他们的隐私是个重大威胁。
信任本来就薄,AI 一来,更薄了。
所以,建一个标准的隐私政策页,写清楚你用 AI 干了什么。收集和处理数据之前,先要同意。数据进 AI 之前,加一道二次确认。定期回访用户:他们想退出的时候,让他退得轻松;想删数据的时候,让他删得干脆。
第二件事,用安全的 AI 平台。
免费的公开大模型——网页版免费的 ChatGPT、Perplexity、Gemini——有个默认设置,很多人不知道:除非你手动关掉,你贴进去的数据默认进入"数据共享"。
你的数据,会被拿去训练模型,甚至微调给别的用户用的输出。也就是说,你在别人收到的回答里,可能看到自己客户的影子。
这就违反消费者隐私法了。
怎么防?用正规大模型的付费版。贴数据之前,先把数据共享关掉。要处理大批量营销数据,用 Snowflake 这类私有化的数据分析平台,别过公共的桥。
还有一个土办法,出奇地好用:把这家 AI 厂商的品牌名放进 Google 搜一搜。结果要是排在第十页,你就得掂量掂量了。能在搜索结果首页站稳的公司,通常——我说的是通常——是有真实客户、有招牌要护的,乱来之前会多想一下。
当然,正式合作之前,安全白皮书、隐私政策,还是得一份一份看。
第三件事,定期审计 AI 的输出。
AI 有个毛病,叫幻觉:一本正经地编造听起来很对的信息。你提示词写得再好,它也可能给你编一条不存在的研究、一个不真实的数据。
没人审就发出去,轻则翻车社死,重则虚假营销,把好不容易攒下的信任一次赔光。
所以,发之前,必须有人看。建一支内容审核小组,盯住每一条要发出去的 AI 输出。给团队写一份 AI 使用手册:哪些词不许出现,语气要贴什么品牌调性,写明白。过去那些部分或全部由 AI 生成的历史内容,也回头过一遍,看品牌调性是不是还在。
上新 AI 工具之前,先过法务。合规是筛供应商的第一道滤网。别为了一点性能上的提升,把风险请进门。
第四件事,把"跟法规"当成例行公事。
数据隐私和 AI 的法律,隔三差五就变。每个季度,把你业务所在地区的法规过一遍,当成例行的体检。
在欧洲做生意,GDPR 和 EU AI Act 每季度必看。在美国,联邦之外还有各州各管一摊,比如加州的 CCPA。
别嫌烦。监管不会提前通知你,罚单会。
最后,回到那个电话
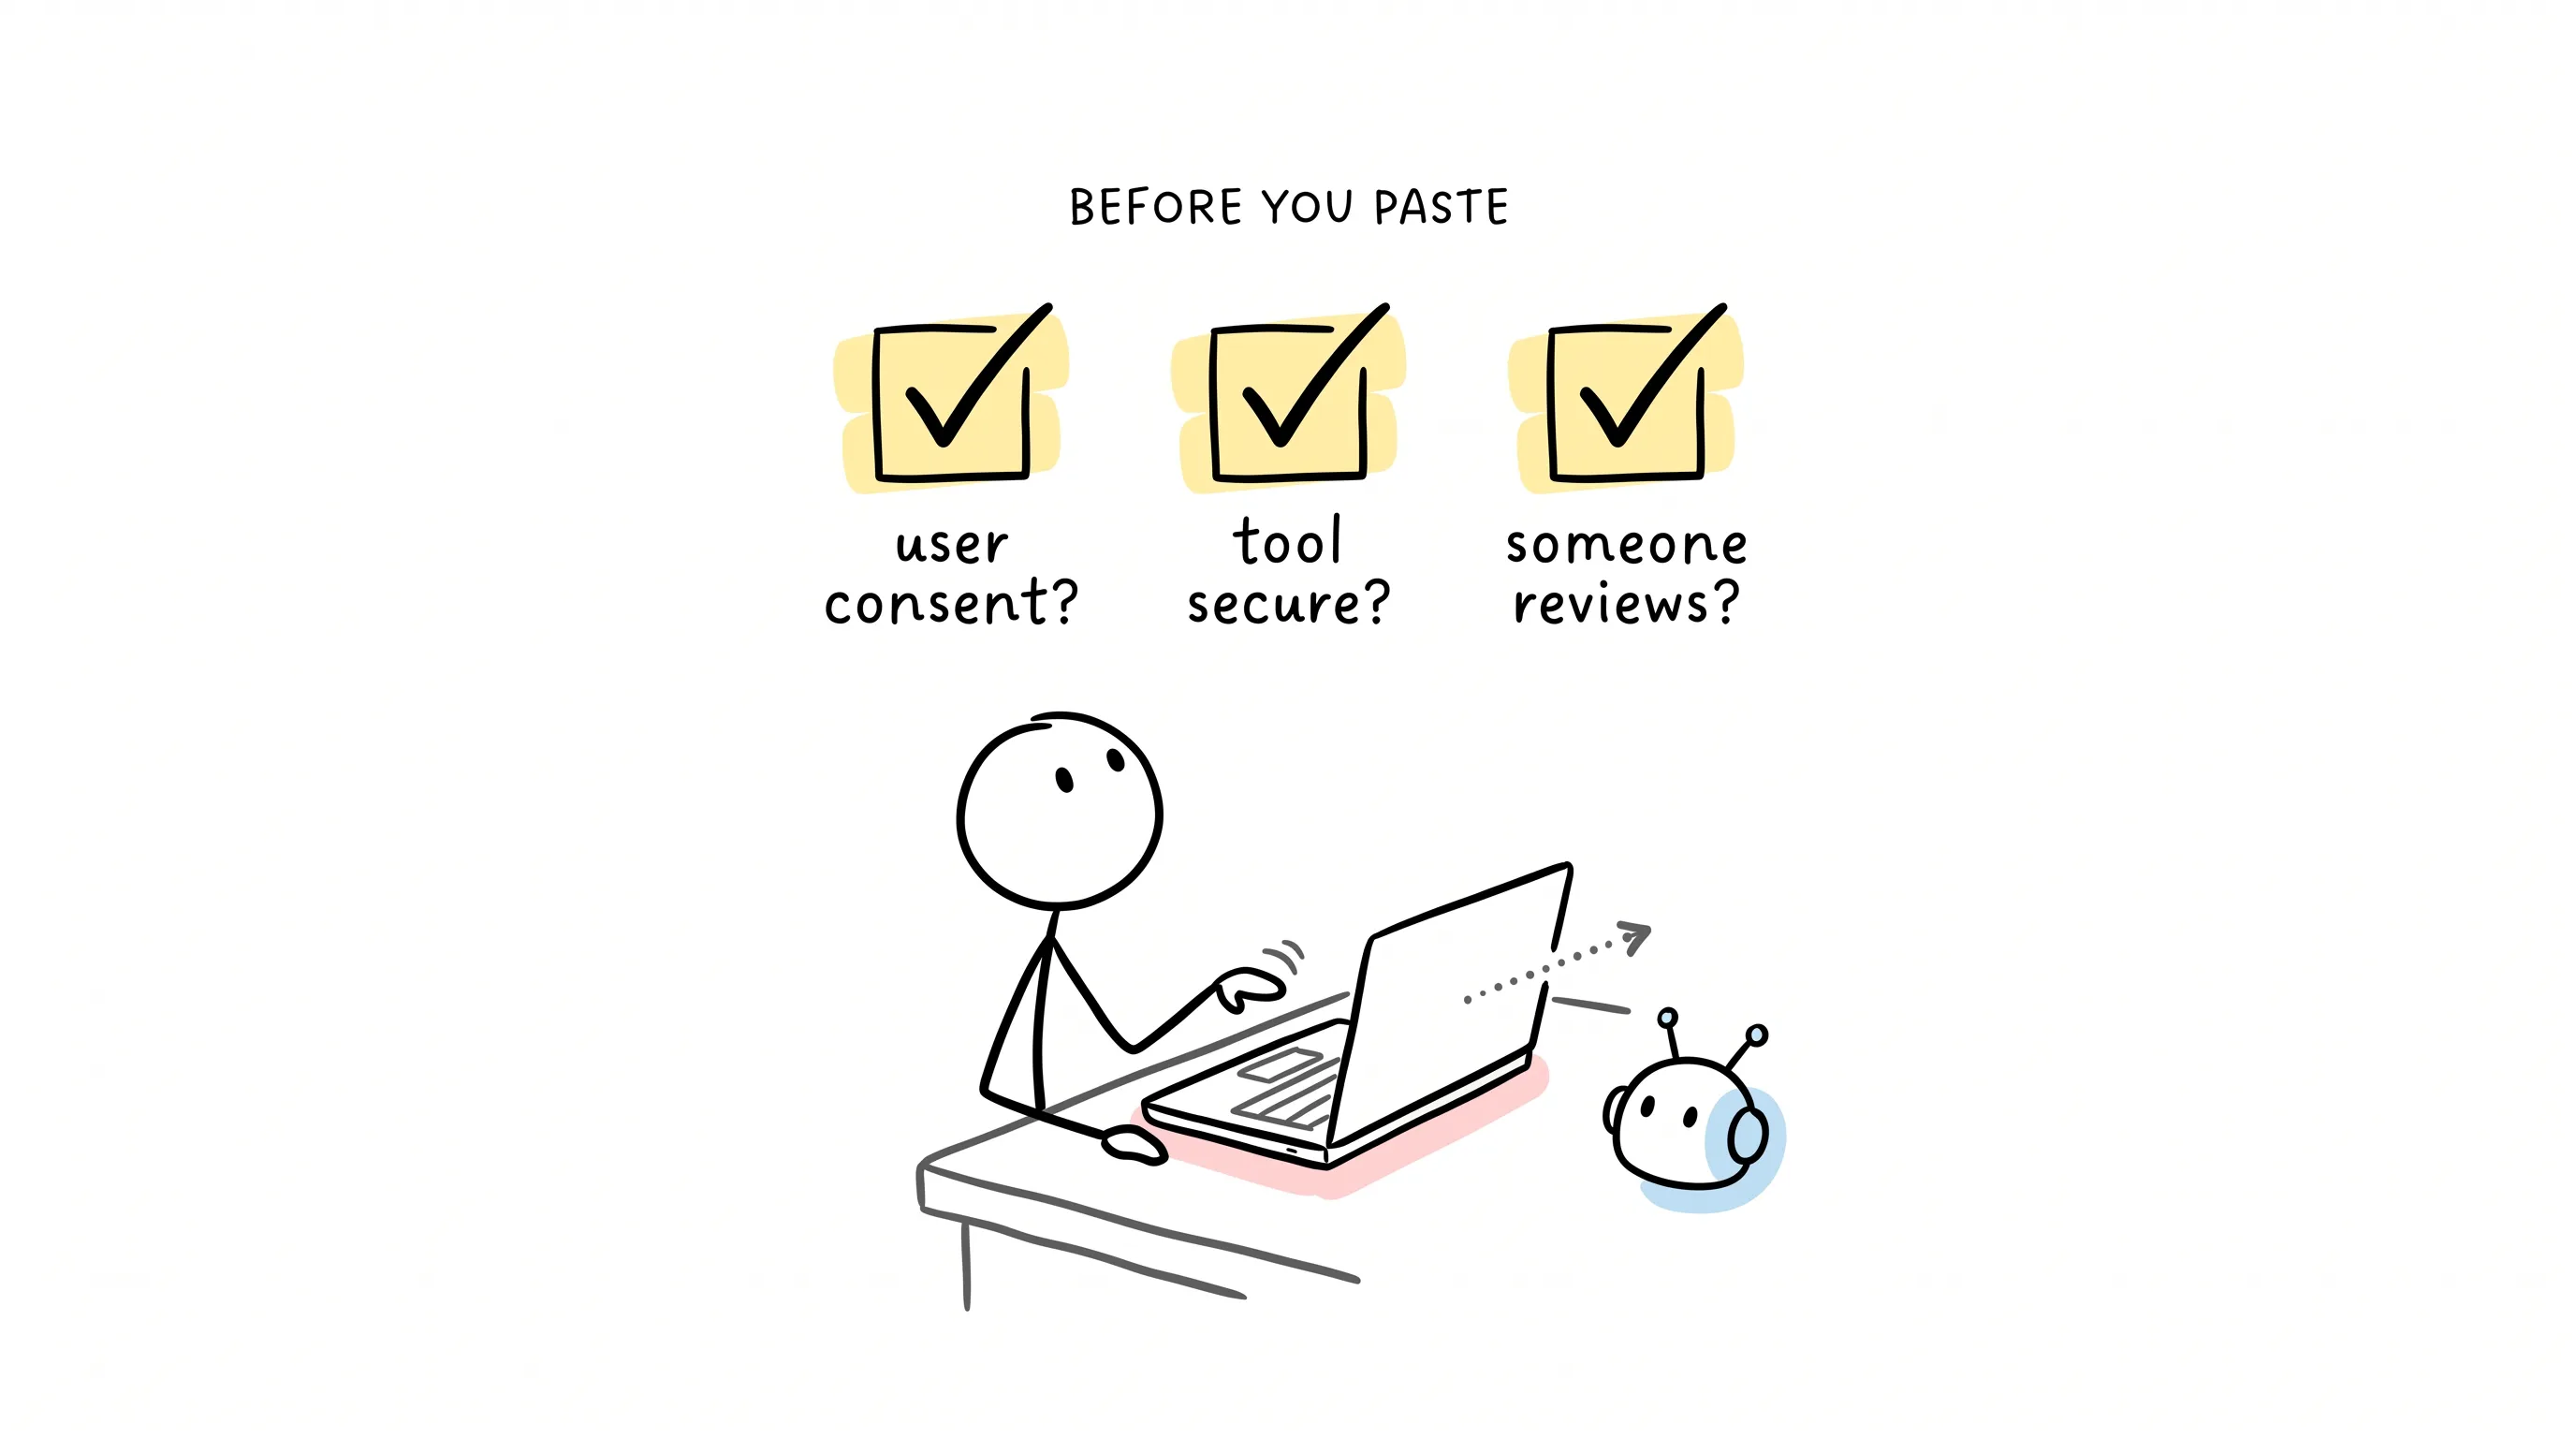
那天深夜,我最后跟朋友说的是:数据贴出去之前,先问自己三个问题。
用户同意了吗?这个工具安全吗?发出去的内容,有人审吗?
三个都能答"是",再动手。
AI 渗透进营销的核心,这件事不会倒回去。你越依赖它,它碰到消费者数据的机会就越多,出错和越界的概率也就越大。
所以这不是要不要用 AI 的问题,是怎么在用 AI 的同时,把合规做成日常的问题。
再次祝我的朋友,也祝你,永远用不上文中的任何一个罚款数字。
继续阅读
相关文章

跨境生意,是时候换一套 AI 工具箱了
一篇 learn 类文章,讲解跨境电商卖家如何用 AI 工具应对语言、法规、物流、支付与欺诈五道坎,梳理翻译、库存、客服、营销、风控五格工具箱与五步上手路径,并提示转化率、CLV 等指标和过度依赖 AI 的风险。

社交媒体营销的脏活累活,正在被 AI 一件件接管
本文介绍 AI 在社交媒体营销中可承担的四类工作:受众数据分析、文案与设计创作、广告定向与创意测试、垃圾内容过滤,并提醒内容判断和数据安全仍需人工把关。

AI 都这么能干了,你的社媒营销还在纯靠人肉?
本文将 18 款常用 AI 工具按用途分为六类,覆盖用户洞察、内容生产、内容排期、评论私信、广告投放和视觉制作,并讨论个性化、趋势预测与虚拟网红等趋势。