
AI 是吃数据长大的,但这顿饭,不是白吃的
本文讲解 GDPR、CCPA 与 PIPL 如何约束 AI 产品,涉及跨境数据流动、被遗忘权与模型偏见等难题,并介绍隐私即设计以及联邦学习、差分隐私、安全多方计算等隐私计算应对思路。
前几天,一个做 AI 应用的朋友约我喝茶。
他刚给产品接上大模型,把攒了多年的用户数据喂了进去,推荐准确率蹭蹭往上涨。说到兴头上,他一拍桌子:这下稳了。
我问他:数据是用户的吧?拿的时候,问过他们吗?
他端着茶杯,愣住了。
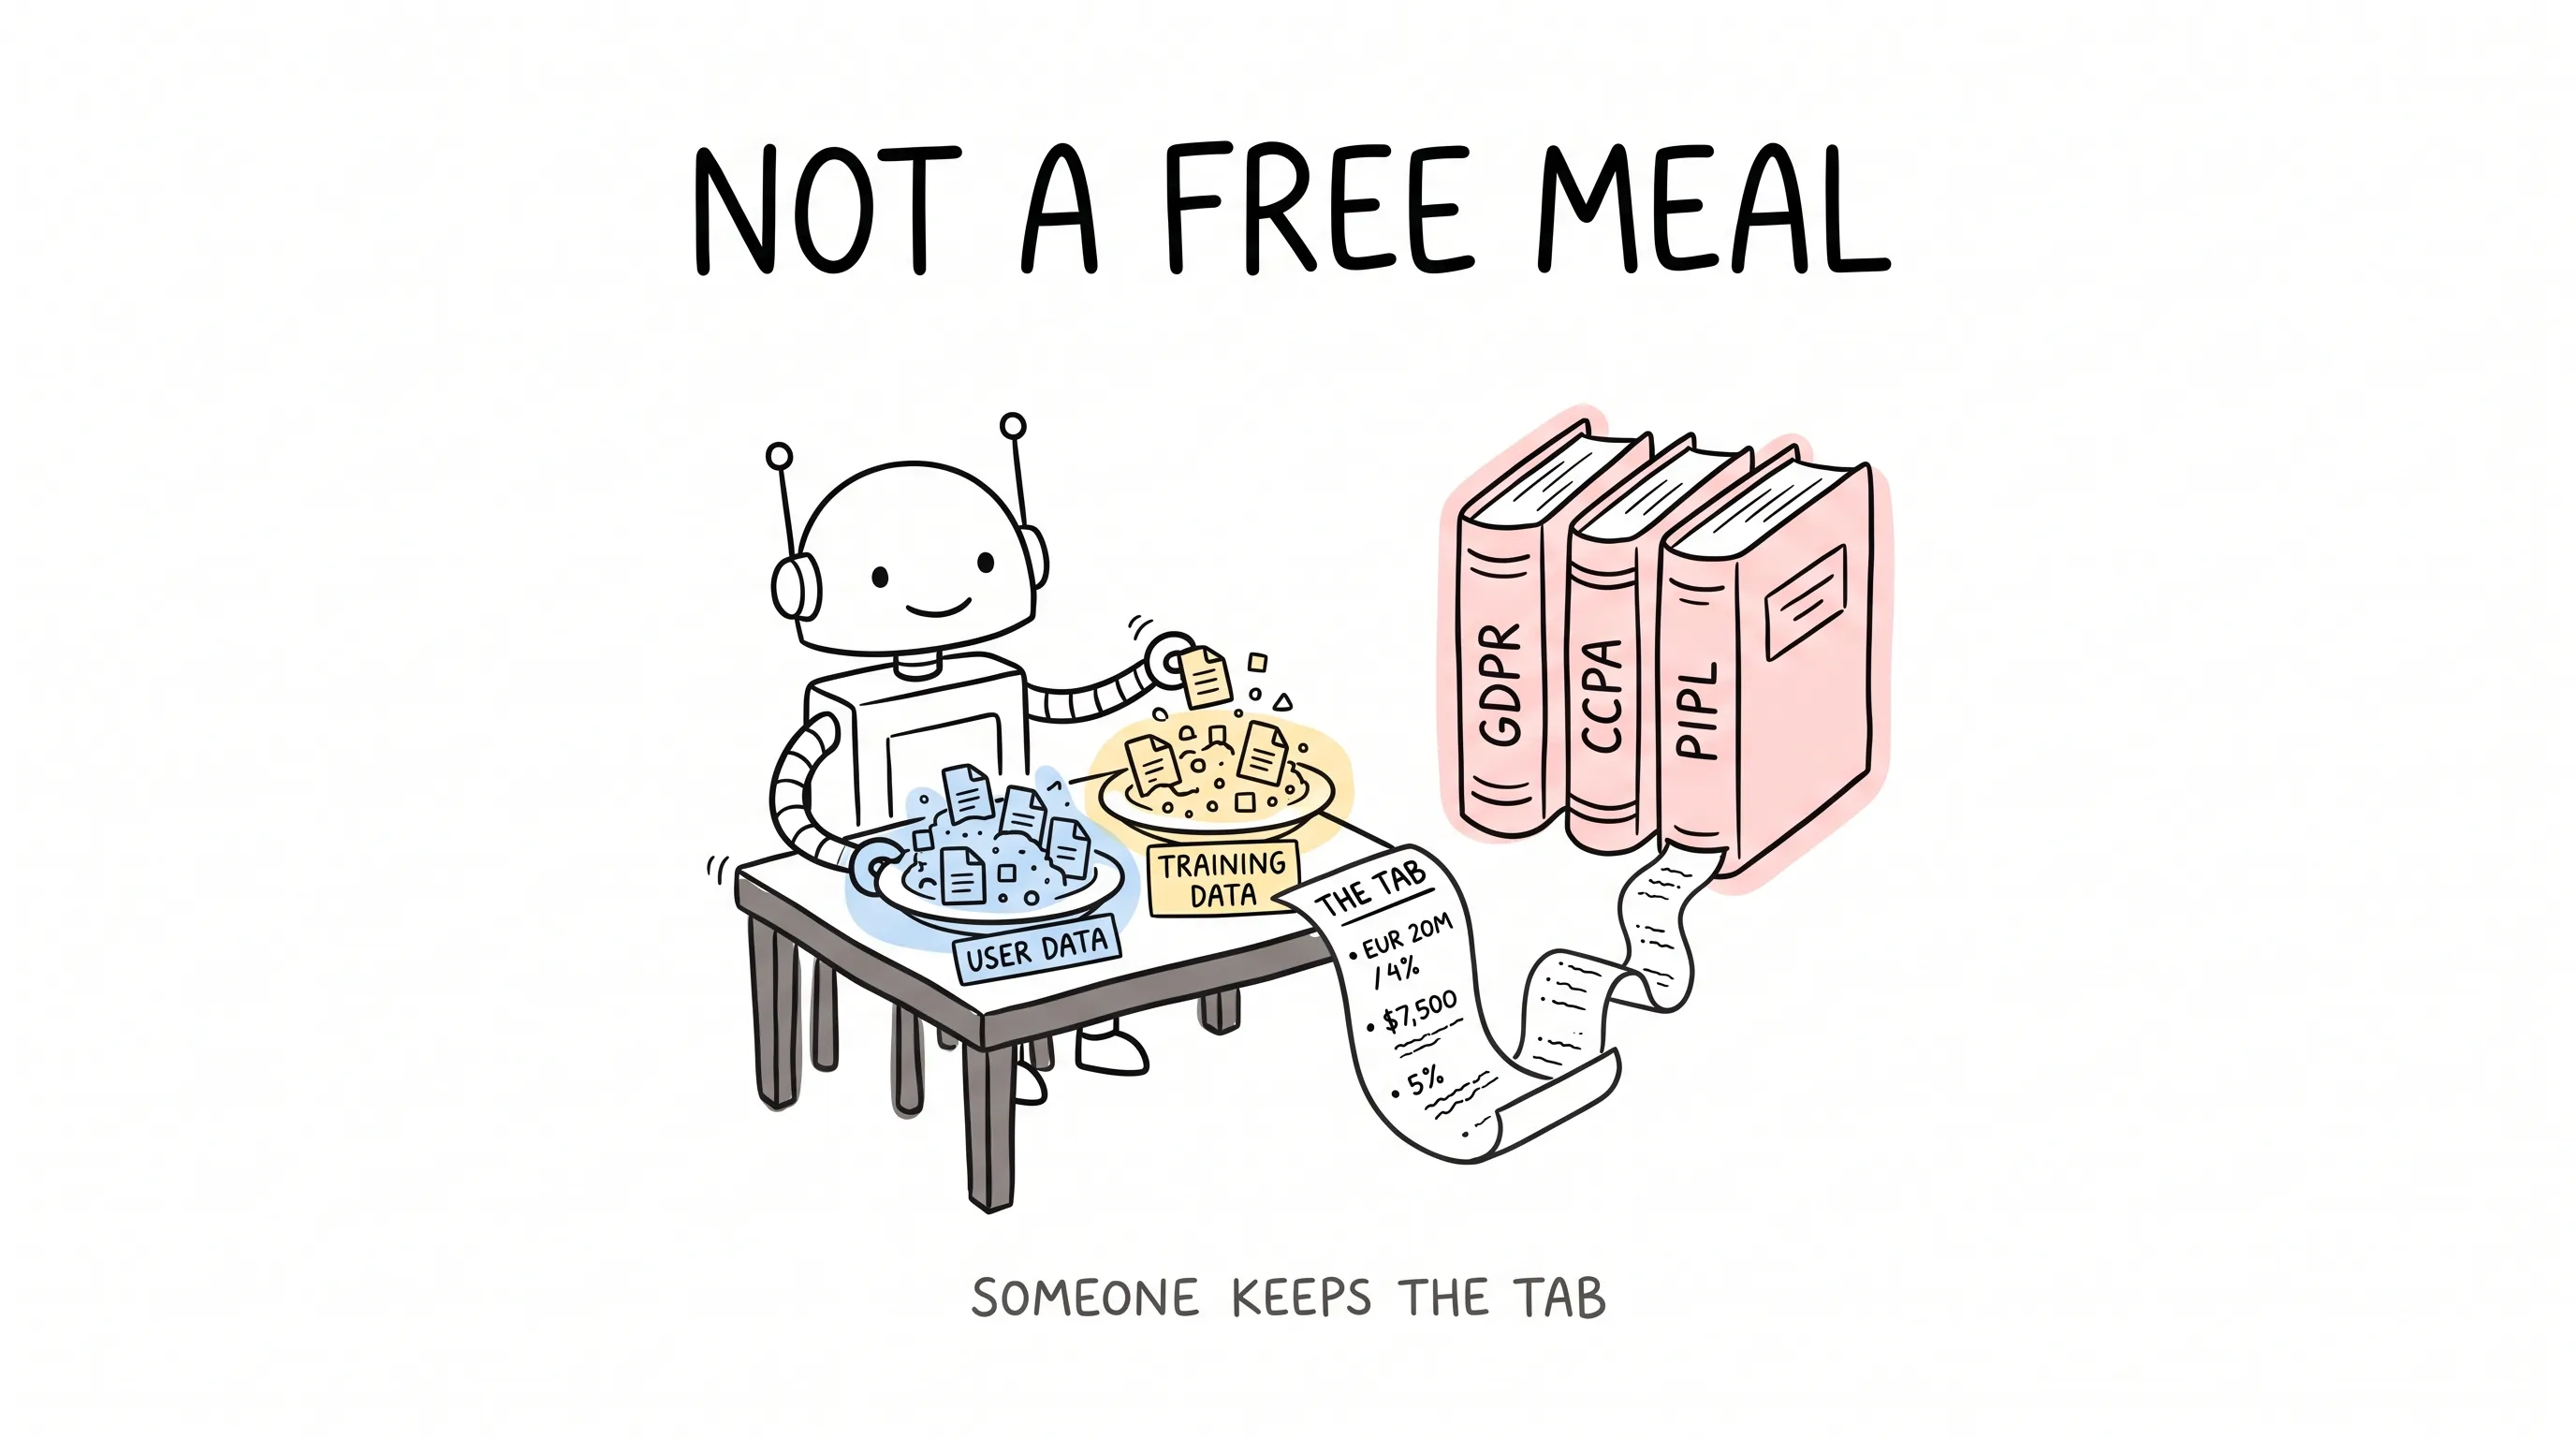
我说,你这顿饭吃得香。但这顿饭,不是白吃的。有人记账呢。
谁在记账?三部法律。一部在欧盟,一部在美国加州,一部在中国。
咱们一个一个说。
先看账本有多厚
什么叫 GDPR?
欧盟的《通用数据保护条例》,2018 年生效。全世界隐私立法里,它被抄作业抄得最多。
它有几条硬规矩:收集数据,要明明白白取得同意;用多少,收多少,不许顺手多拿;用户随时可以查、可以改、可以删。
删,这条特别狠。用户有权要求你把他的数据抹掉,行话叫「被遗忘权」。
不守规矩呢?罚。两个数取高:2000 万欧元,或者全球营业额的 4%。
注意,是全球营业额。你一年收入 100 亿,4% 就是 4000 万欧元,三亿多人民币。
加州的 CCPA,思路不太一样。它管的核心是:数据要是被拿去卖钱了,你得告诉用户,还得给他一个说「不卖」的入口。所以加州人的网站上,总能看到一个链接:别卖我的个人信息。违反一次,罚 7500 美元。
中国的 PIPL,2021 年 11 月生效,是第一部把个人信息保护讲全乎的法律。查、改、删,它都有。但它多了一层:数据主权。在中国境内收的数据,原则上得留在境内,想出去,得满足专门的条件。
罚起来也不含糊:最高一年营业额的 5%,还可能吊销执照。
一家年营收 10 亿的公司,顶格就是 5000 万。这是真往肉里割。
一份数据,三套规矩
有读者可能要问了:我一家公司,同时被三部法律管,听谁的?
这就是麻烦所在。它们仨,谁也不认谁。
你想想看,最拧巴的,是数据的跨境流动。
2020 年,欧盟法院出手,把「欧美隐私盾」这张传了多年的数据通行证,直接判了无效。理由是,美国政府的监控行为,保护不了欧盟用户的数据。
一纸判决,无数在欧美两岸来回搬数据的公司,一夜之间没了合法通道,只能退回去用标准合同条款,一条一条签。连 Google 都因为靠这个条款往美国传数据,被拽进了官司。
后来 2023 年,新框架出来了,通行证算是补上了。但经过这么一轮翻烧饼,大家都学乖了:鸡蛋,不能放一个篮子里。
再加上中国、印度都要求敏感数据本地化,得在当地建机房、雇团队。钱,哗哗地花。
所以现在跨国公司通行的做法,听着就心酸:按辖区把数据切开,一摊一摊分开存。
同一份数据,三套规矩,三份成本。
AI 一进场,别扭翻倍
上面说的,还只是普通互联网公司的问题。AI 一进场,别扭翻倍。
第一个别扭:AI 的饭量,和「最少够用」原则,天生犯冲。
AI 要效果好,就得吃得多。但 GDPR 说,收数据要最小化,用途要事先限定。训练一个看医学影像的模型,可能需要几十万份病历,可病历是敏感数据,没患者明确点头,你连碰都不能碰。
第二个别扭:「被遗忘权」撞上模型。
用户说,把我的数据删了。行,数据库里删掉,一分钟的事。
可数据已经训进模型里了。模型不是数据库,它把数据消化成了几亿个参数。要吐出来,只能重新训练。
重训一次,几百万的算力钱,加上几周的时间。用户一个删除请求,你接还是不接?接,成本疼;不接,违法。
第三个别扭:黑箱。
什么叫黑箱?就是模型给了你一个答案,但说不出为什么。
2020 年,一家大型信用卡公司的评分系统被推上风口浪尖:条件差不多,给女性的信用额度,明显比男性低。是故意歧视吗?没人说得清。因为连开发它的人,也只能看到输入和输出。
后来业内搞出了 LIME、SHAP 这类「解释工具」,能给模型的判断做点翻译。有用。但离把黑箱完全打开,还差得远。
更别提亚马逊那个著名的教训:训练数据里男性简历多,招聘 AI 就学会了给女性降分,最后整个项目被砍掉。
数据里带着的偏见,AI 不但不消化,还放大着端上桌。
所以欧盟又追了一部《人工智能法案》,已经生效,正在分阶段落地:高风险的 AI,必须把透明度、安全性这些事,提前做到位。
那怎么办?两招
先别慌。路,不是没有。
第一招:开工前,就把隐私画进图纸。
这个思路有个名字,叫 privacy by design,隐私即设计。
什么意思?装修的时候,先布好水电,再砌墙。而不是住进去了,天天跳闸,再砸墙重来。
落到 AI 项目上:动手前做一次隐私风险评估,把数据流从头到尾捋一遍;能用加密的地方都加密;每个环节多问一句,这条数据,非收不可吗?
第二招:数据不出门,也能干活。
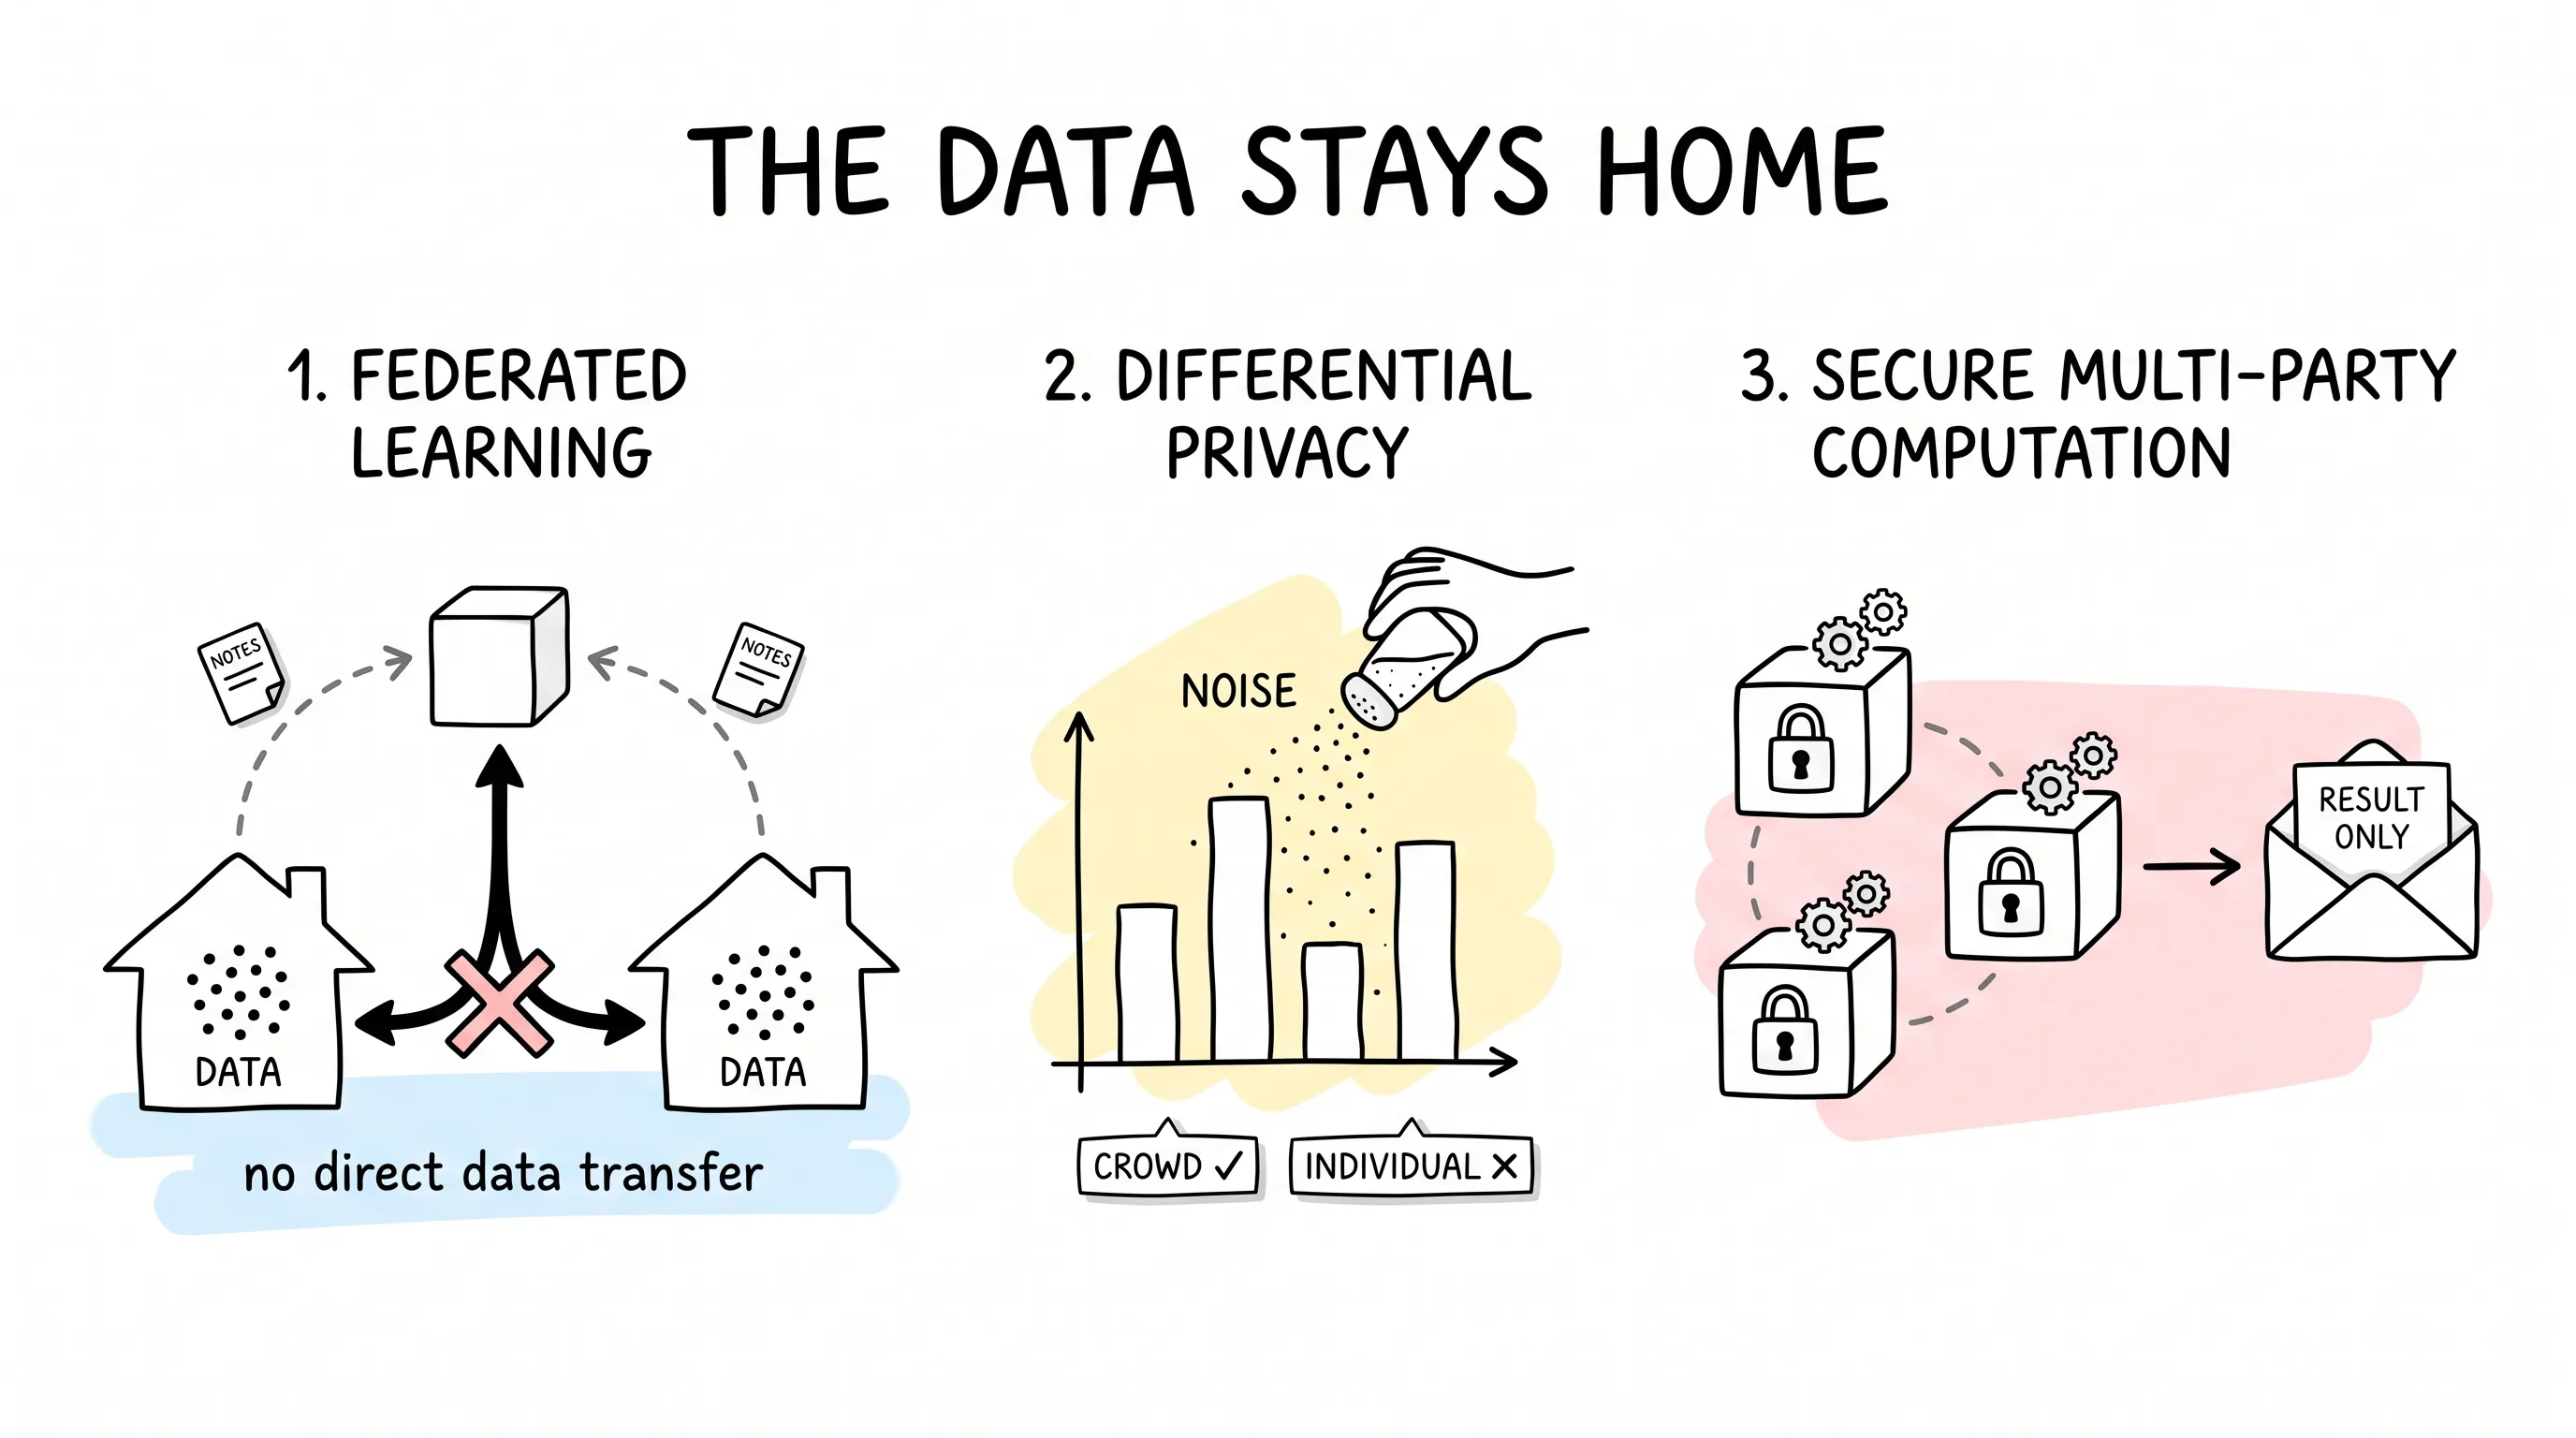
这一类技术,统称隐私计算。给你讲三个。
第一个,联邦学习。
以前的玩法:各家银行把客户数据拷到一台服务器上,一起训模型。数据全裸奔。
联邦学习反过来:数据待在自己家,谁也不动。派出去的,是模型学到的东西。中央把大家的学习笔记汇总起来,模型就训成了。原始数据,一步都没出门。
微众银行开源的 FATE,就是干这个的。银行、保险业用它,在数据互不开放的前提下,一起做反欺诈、做风控。
第二个,差分隐私。
往统计结果里,加一点恰到好处的噪音。
加多少?有严格的数学标准:多一个人、少一个人,查不出任何区别。这样,你只能看见人群长什么样,永远定位不到某个人长什么样。
苹果是把这个用出名的:收集 iPhone 用户的使用习惯,比如哪个 emoji 最火、哪些应用老崩溃。统计照做,但每一份数据,都追不到具体的手机。
第三个,安全多方计算。
几家机构想一起算个账,又谁都不想亮底牌。怎么办?各自把数据锁进加密的盒子里,在盒子上完成计算,最后只打开结果。
算完了,大家知道答案,底牌一张没翻。
别以为这是别人的事
金融业,已经把这套打法跑通了。
反欺诈,靠 AI 实时盯着:异地登录、连续输错密码、半夜的奇怪大额转账,当场拦下。核身,靠人脸、声纹。跨境合规,用联邦学习和安全多方计算绕开:数据不出境,模型照样联合训练。
有人可能会说,我们公司小,没人盯着我们那点数据。
Facebook 当年一次泄露,5.33 亿人的个人信息被挂到了网上。
5.33 亿,比美国全国人口还多。天呐。
而另一项调查显示,87% 的消费者认为,数据隐私是一项基本人权。
用户不是不在意,只是在等一个出事的由头。
AI 的天花板,从来不是算力,是信任。
回到开头那个喝茶的朋友。我给他的建议,就一句话:趁项目还早,把合规画进图纸里。别等罚单来了,再回头学什么叫 GDPR。
祝你的 AI,吃得下数据,也经得起查账。
继续阅读
相关文章

跨境生意,是时候换一套 AI 工具箱了
一篇 learn 类文章,讲解跨境电商卖家如何用 AI 工具应对语言、法规、物流、支付与欺诈五道坎,梳理翻译、库存、客服、营销、风控五格工具箱与五步上手路径,并提示转化率、CLV 等指标和过度依赖 AI 的风险。

社交媒体营销的脏活累活,正在被 AI 一件件接管
本文介绍 AI 在社交媒体营销中可承担的四类工作:受众数据分析、文案与设计创作、广告定向与创意测试、垃圾内容过滤,并提醒内容判断和数据安全仍需人工把关。

AI 都这么能干了,你的社媒营销还在纯靠人肉?
本文将 18 款常用 AI 工具按用途分为六类,覆盖用户洞察、内容生产、内容排期、评论私信、广告投放和视觉制作,并讨论个性化、趋势预测与虚拟网红等趋势。