
Adobe 只用 9 个月,把 AI 做成了 Photoshop 里最常用的功能。凭什么?
文章拆解 Adobe Firefly 的打法:只用 Adobe Stock 商业授权图与公有领域内容训练,9 个月内整合进 Photoshop 等应用,依托 AWS 基础设施扩展训练规模,并通过 RLHF 用户反馈与基于 C2PA 的内容凭证建立 AI 图片信任。
前段时间,我和一位做了十几年设计的老朋友吃饭。
聊起 AI 生成图,他一肚子苦水。工作室早就试过各种 AI 工具,出图确实快。但客户一句话就把他问住了:这图的素材哪来的?万一哪天版权方找上门呢?
于是那些 AI 工具,试完就搁置了。好看,不敢用。
但这次见面,他掏出手机给我看,满屏都是 Photoshop。他说,现在工作室一半的活儿,都靠里面的「生成填充」干。
我说,等会儿。你不是怕版权吗?怎么现在敢用了?
他笑了:Adobe 把这事儿从头到尾捋顺了。
回家路上我一直在想这件事。想明白之后,我觉得 Adobe 这套打法,值得每一个想做大模型应用的团队细看。今天讲给你。
第一刀,砍向数据
很多人以为,Adobe 做 AI 是从模型开始的。
不是。它是从「食材」开始的。
什么叫食材?就是训练模型用的数据。
市面上绝大多数生成式模型吃什么?互联网上刮来的数据。能刮到什么吃什么,至于这些图有没有版权、归谁,模型不管。图是学会了,但每一张的来路都说不清。
这在实验室里无所谓。可你要把 AI 塞进 Photoshop,卖给全球的设计师、摄影师,还有广告公司,就是另一回事了。
你的客户是要拿这些图去商用的。食材来路不明,菜再香,也没人敢吃。
Adobe 做创意软件,做了四十多年。它比谁都清楚,这门生意建立在信任上。
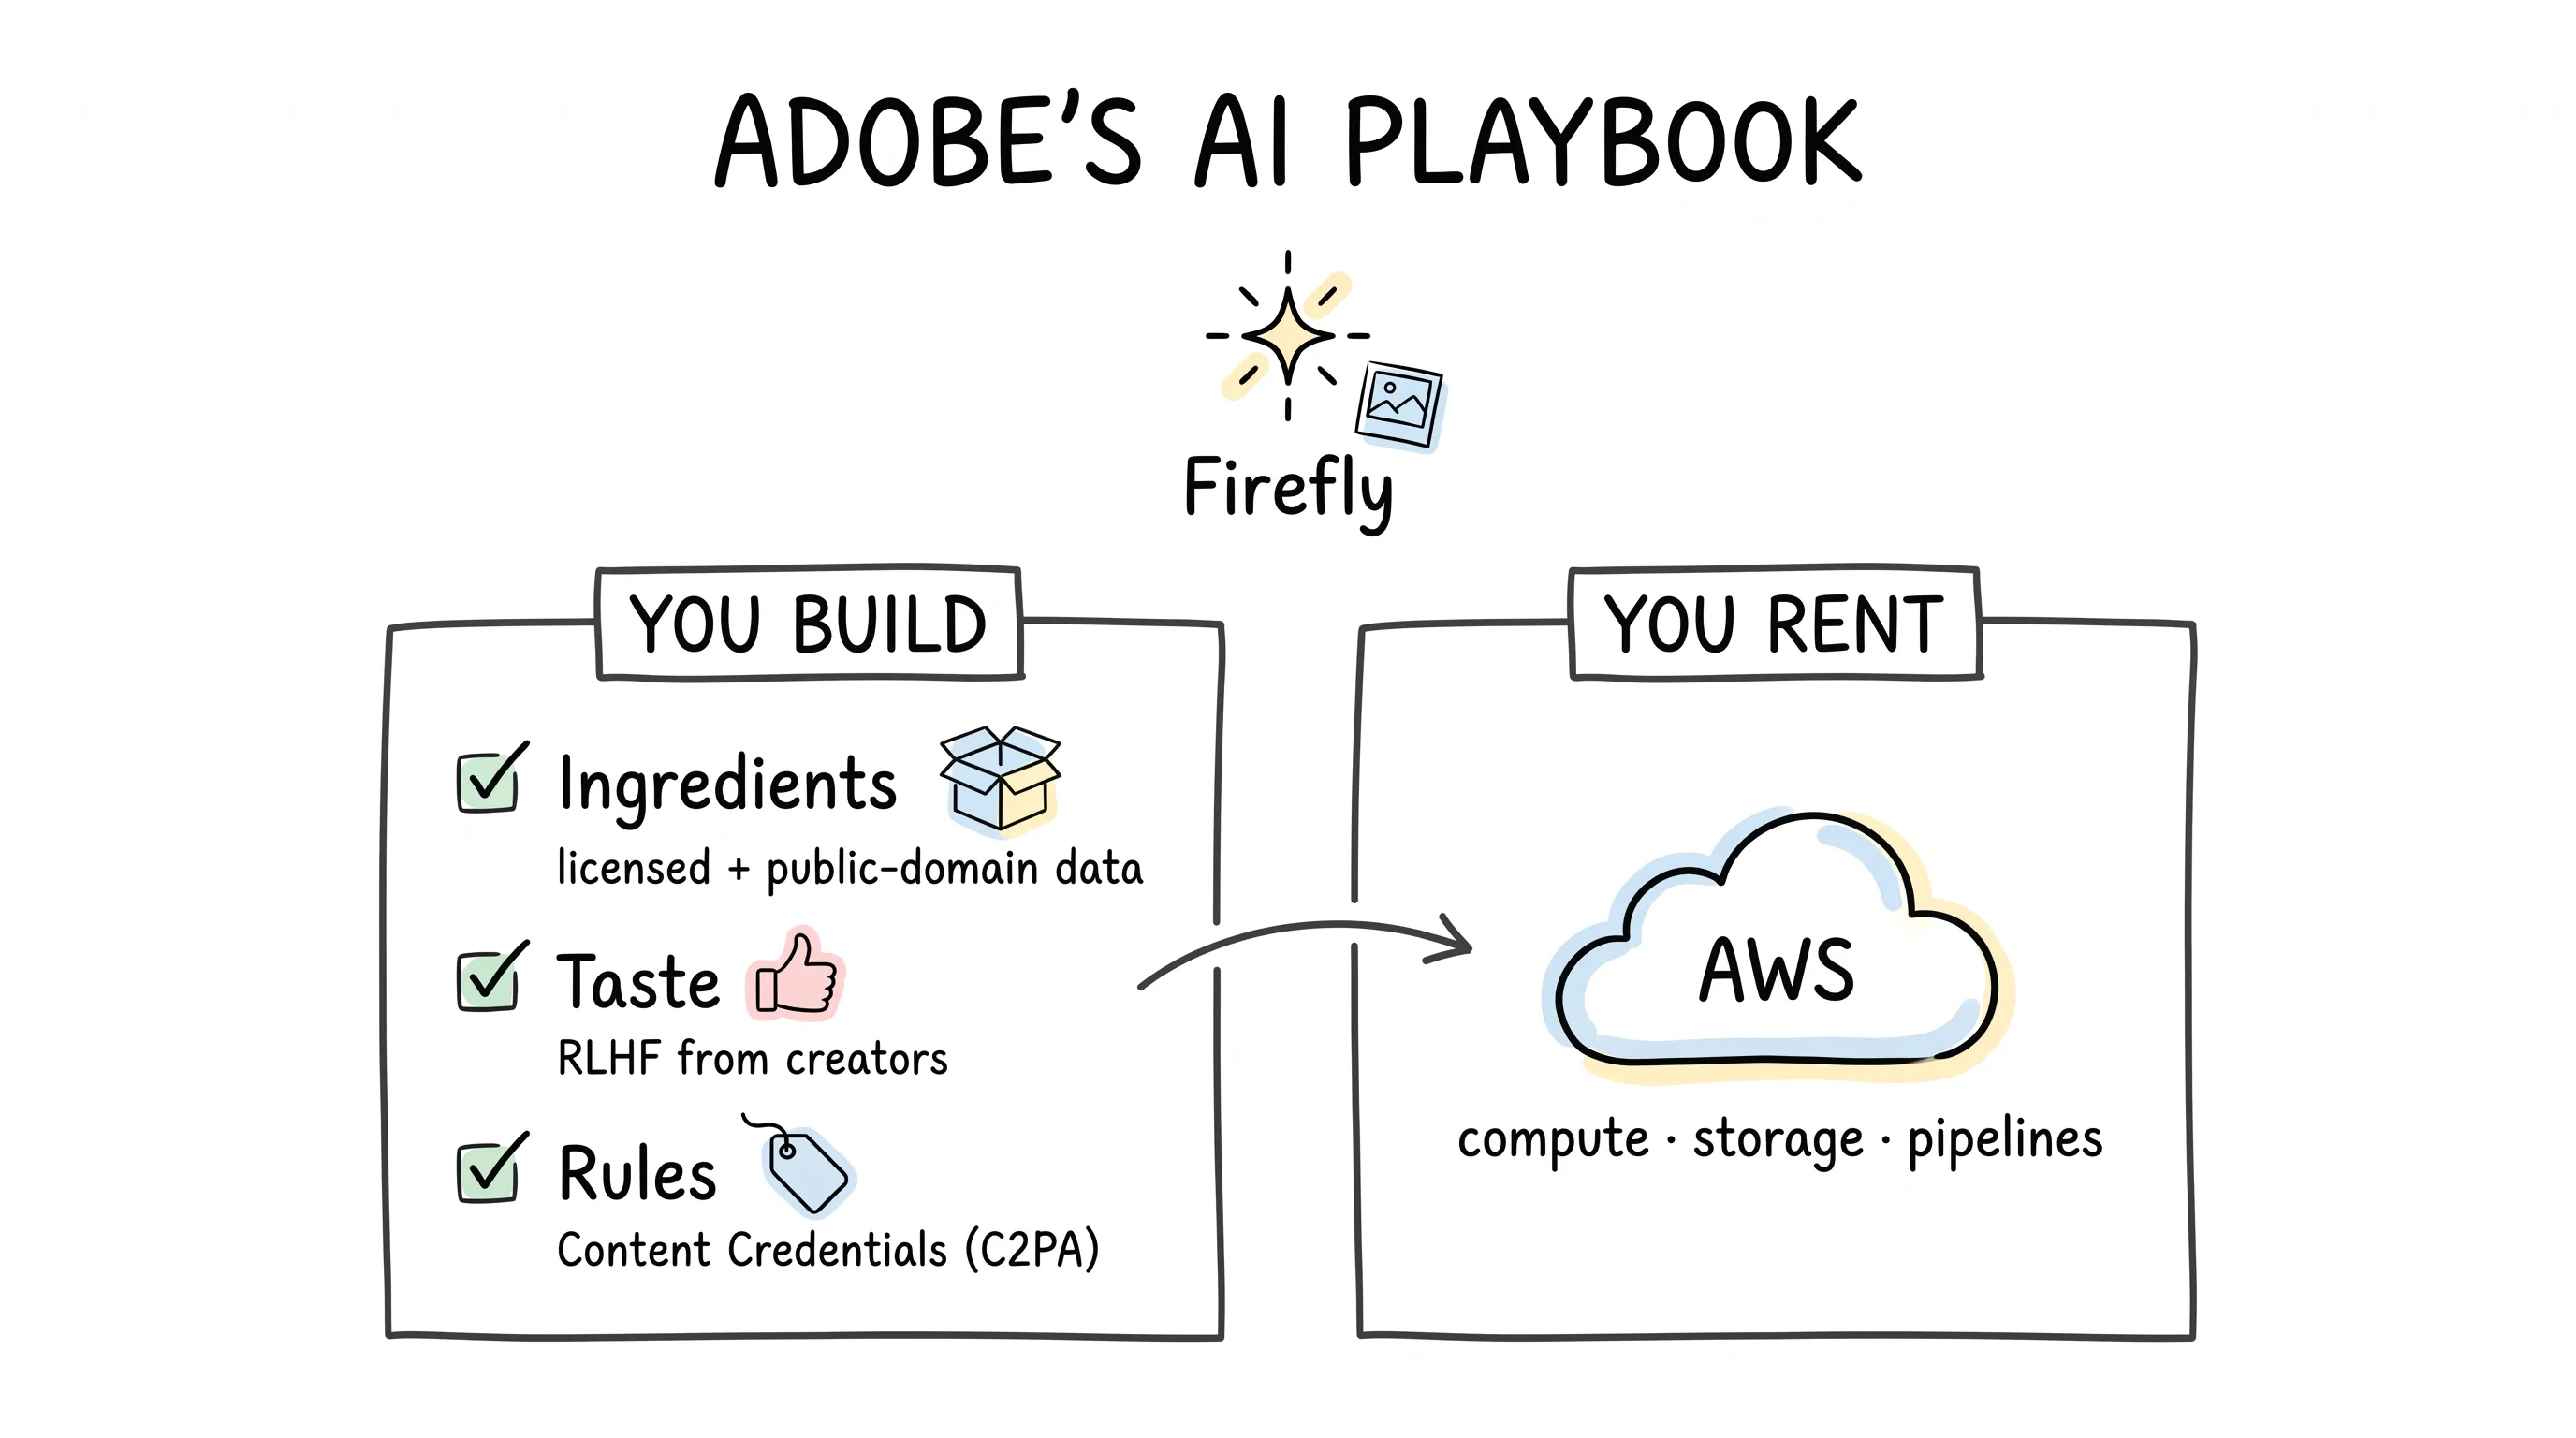
所以 Adobe 干了一件特别「笨」的事:不用现成的开源模型,自己训。为什么?用 Adobe 负责生成式 AI 的高管的话说,模型的质量和能力,必须自己可控。
更关键的是喂什么。Adobe 只用两类数据:一类是 Adobe Stock 里拿到商业授权的图,一类是版权早已过期、进入公有领域的内容。
每一张图,来路清清楚楚。
你想想看,这相当于什么?相当于一家餐厅,不用菜市场来路不明的散装货,全部食材自建农场种、签合同买,每一批都能溯源。
成本是高。但 Firefly 生成的图,设计师敢直接用在客户的项目里。
这一刀,砍在了别人最不敢碰的地方。
9 个月,凭什么?
食材定了,接下来是厨房。
按照常规剧本,一家公司决定自研大模型,接下来的剧情应该是:招几百个基础设施工程师,租机房,买卡,搭集群,两三年后见分晓。
Adobe 没这么干。它只用了 9 个月,就把 Firefly 模型家族推了出来,还顺手整合进了 Photoshop、Illustrator、Substance 3D、Adobe Express。
9 个月。从零到全家桶。
凭什么这么快?
因为它压根没打算自己打地基。训练平台、数据管道,全部架在 AWS 上。计算用带 NVIDIA GPU 的 EC2 实例,调度用 EKS,网络加速用 EFA,海量训练数据全放进 S3 这个数据湖。
那 Adobe 自己干什么?干只有它能干的事:让模型真正懂创意工作。
这里面有个细节,特别值得说道。
训练大模型,GPU 是按小时烧钱的。这时最可怕的事是什么?是 GPU 闲着等数据。数据管道一堵,算力就在那儿空转,烧的全是钱。
Adobe 用 FSx for Lustre 这个高性能文件系统,专门解决「喂不饱」的问题,让数据跟得上算力,保证 GPU 不空转。
这就好比请了米其林大厨,就不能让大厨站在厨房等外卖。备菜、传菜这些杂事,得安排得明明白白。
地基能租,就别自己打。楼上的房子,才是你的差异化。
模型的品味,是怎么来的?
数据解决了「敢不敢用」。但还有一个问题:好不好用。
一个模型,技术上跑通了,不代表它能生成让设计师满意的图。审美这个东西,怎么教给机器?
Adobe 的答案是:让人来教。
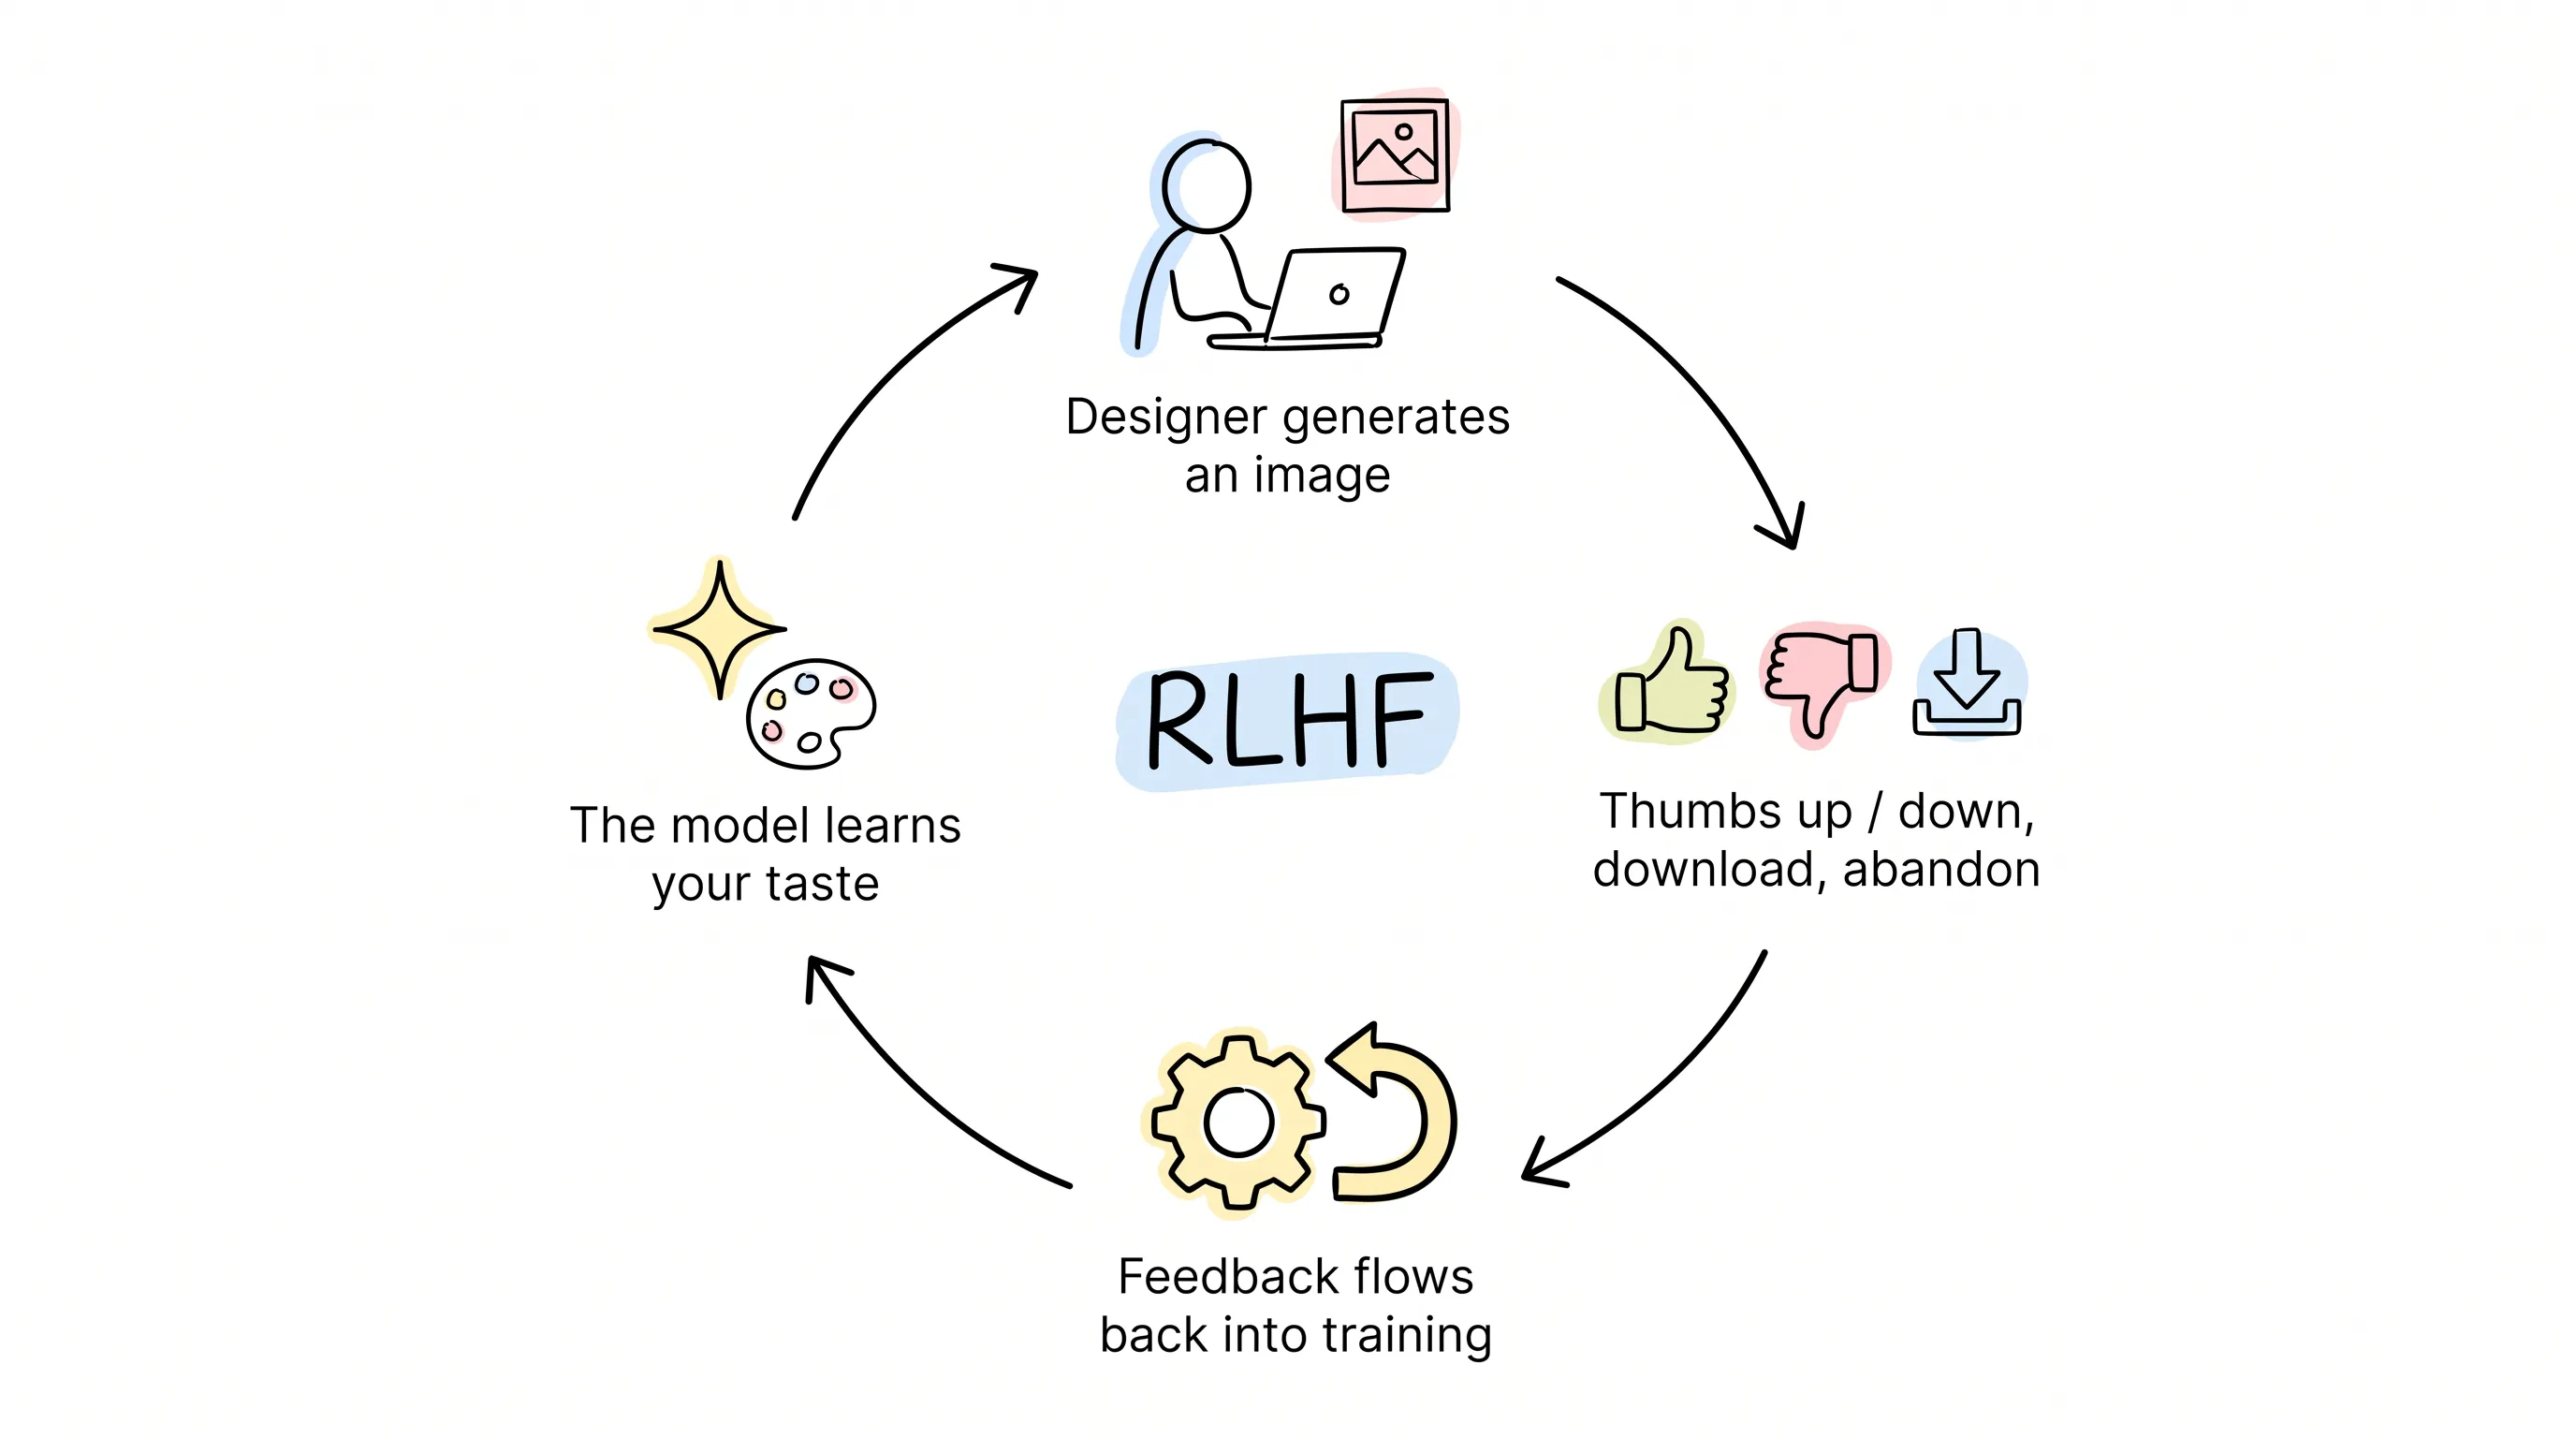
这套机制叫 RLHF,翻译成人话,就是用人类的反馈来调教模型。说穿了特别朴素:用户在软件里的每一个动作,点赞、点踩、下载、放弃,都被收集起来,回流到训练过程。
你点了赞,模型知道这个方向对。你点了踩,模型知道这不对。你把这张图下载了拿去交稿,模型知道,这不光对,还挺有用。
亿万创意人的审美偏好,就这样一天一天喂给模型。
我第一次想明白这个循环的时候,只能说一句:太强了。
这就像一家餐厅,每天打烊后盯着看:哪道菜被吃光了,哪道菜剩下大半。第二天菜单就改。改一次不难,难的是天天改,改上几年。
菜单会越来越懂食客。Firefly 就是这样越来越懂设计师的。
同时,Adobe 还持续做测试,防止模型生成有害或有偏见的内容,也留了用户反馈的入口,发现问题立刻修。
机器越来越懂人。人也在这个过程里,越用越顺手。
爆量来了怎么办?
故事到这儿还没完。真正考验一家公司的,是爆发。
Firefly 上线之后,用的人一下子上来了,训练需求跟着暴涨。怎么办?
Adobe 用 6 个月,把训练规模扩大了 20 倍。
20 倍。这不是加几台机器的事,这是把整个后厨复制二十遍,还得保证出菜口味一致。它用预留实例锁定资源,用流水线并行这类分布式训练技巧,把 GPU 的每个计算单元都吃满。
训练之外是推理,也就是用户每按一次「生成」背后的那道工序,同样全在 AWS 上。Adobe 把推理系统做成无状态的,铺在多个区域,哪里有需求就在哪里出货。为了压成本、提速度,它还在评估 Inferentia2 这类专用推理芯片。
性能和成本,两头都要顾,随时能把硬件搬来搬去。
从一家店,到连锁店。后厨标准化了,才敢开分店。
敢不敢承认,这是 AI 做的
最后说一个我认为最被低估的动作。
AI 生成的图越来越多,一个问题浮出水面:你怎么知道眼前这张图,是拍的,还是生成的?
Adobe 的答案叫「内容凭证」。Firefly 生成的每张图,都会自动附着一段防篡改的元数据,像一张「营养标签」,告诉你这份内容的成分:是不是 AI 参与了创作或编辑。
这套东西建立在 C2PA 开放标准之上。Adobe 牵头的内容真实性倡议,2019 年就发起了。
天呐,2019 年。那时候,这波生成式 AI 大潮连个影子都还没有。
AI 的竞争,上半场拼的是模型,下半场拼的是信任。
模型追一追,总能追上。信任这个东西,是拿一年一年的干净数据、一张一张带凭证的图,慢慢攒出来的。
最后,说给同行
Adobe 负责生成式 AI 业务的副总裁,给同行留过一段话,我印象很深。
他说,AI 研究、工程、应用机器学习的人才,太难招了。招不到就别硬撑,用云上现成的 AI 服务,比如 Amazon SageMaker、Amazon Bedrock。把力气花在你自己的差异化价值上。重造所有地基这件事,难度会超出想象。
还有一句,我觉得更狠:想自建 AI 云,动念头很容易。但正是和 AWS 的合作,让 Adobe 能专注在自己的差异化上。
说白了,这是一道「什么该自己干,什么该交给别人」的选择题。
Adobe 的答案是:食材自己选,品味自己教,规矩自己立。机房、算力、管道,交给别人。
回到开头我那位朋友。那天散场前,他说了句让我印象很深的话:以前怕 AI 抢活儿,现在怕的是自己不会用。
工具从来不可怕。可怕的是,别人已经用工具跑起来了,你还在纠结要不要用。
更祝你,赶上了这一波,还不必烧自己的地基。
继续阅读
相关文章

跨境生意,是时候换一套 AI 工具箱了
一篇 learn 类文章,讲解跨境电商卖家如何用 AI 工具应对语言、法规、物流、支付与欺诈五道坎,梳理翻译、库存、客服、营销、风控五格工具箱与五步上手路径,并提示转化率、CLV 等指标和过度依赖 AI 的风险。

社交媒体营销的脏活累活,正在被 AI 一件件接管
本文介绍 AI 在社交媒体营销中可承担的四类工作:受众数据分析、文案与设计创作、广告定向与创意测试、垃圾内容过滤,并提醒内容判断和数据安全仍需人工把关。

AI 都这么能干了,你的社媒营销还在纯靠人肉?
本文将 18 款常用 AI 工具按用途分为六类,覆盖用户洞察、内容生产、内容排期、评论私信、广告投放和视觉制作,并讨论个性化、趋势预测与虚拟网红等趋势。