
AI Marketing Daily · 2026-09-10
每日简报汇总六条内容:HubSpot 的 AI 搜索(AEO/GEO)优化指南、AI ROI 三层汇报方法、MarTech 圆桌的数据管道建议、浏览器代理读取 LinkedIn 评论的受监督实测,以及 AI 时代人才与组织布局的两个案例。
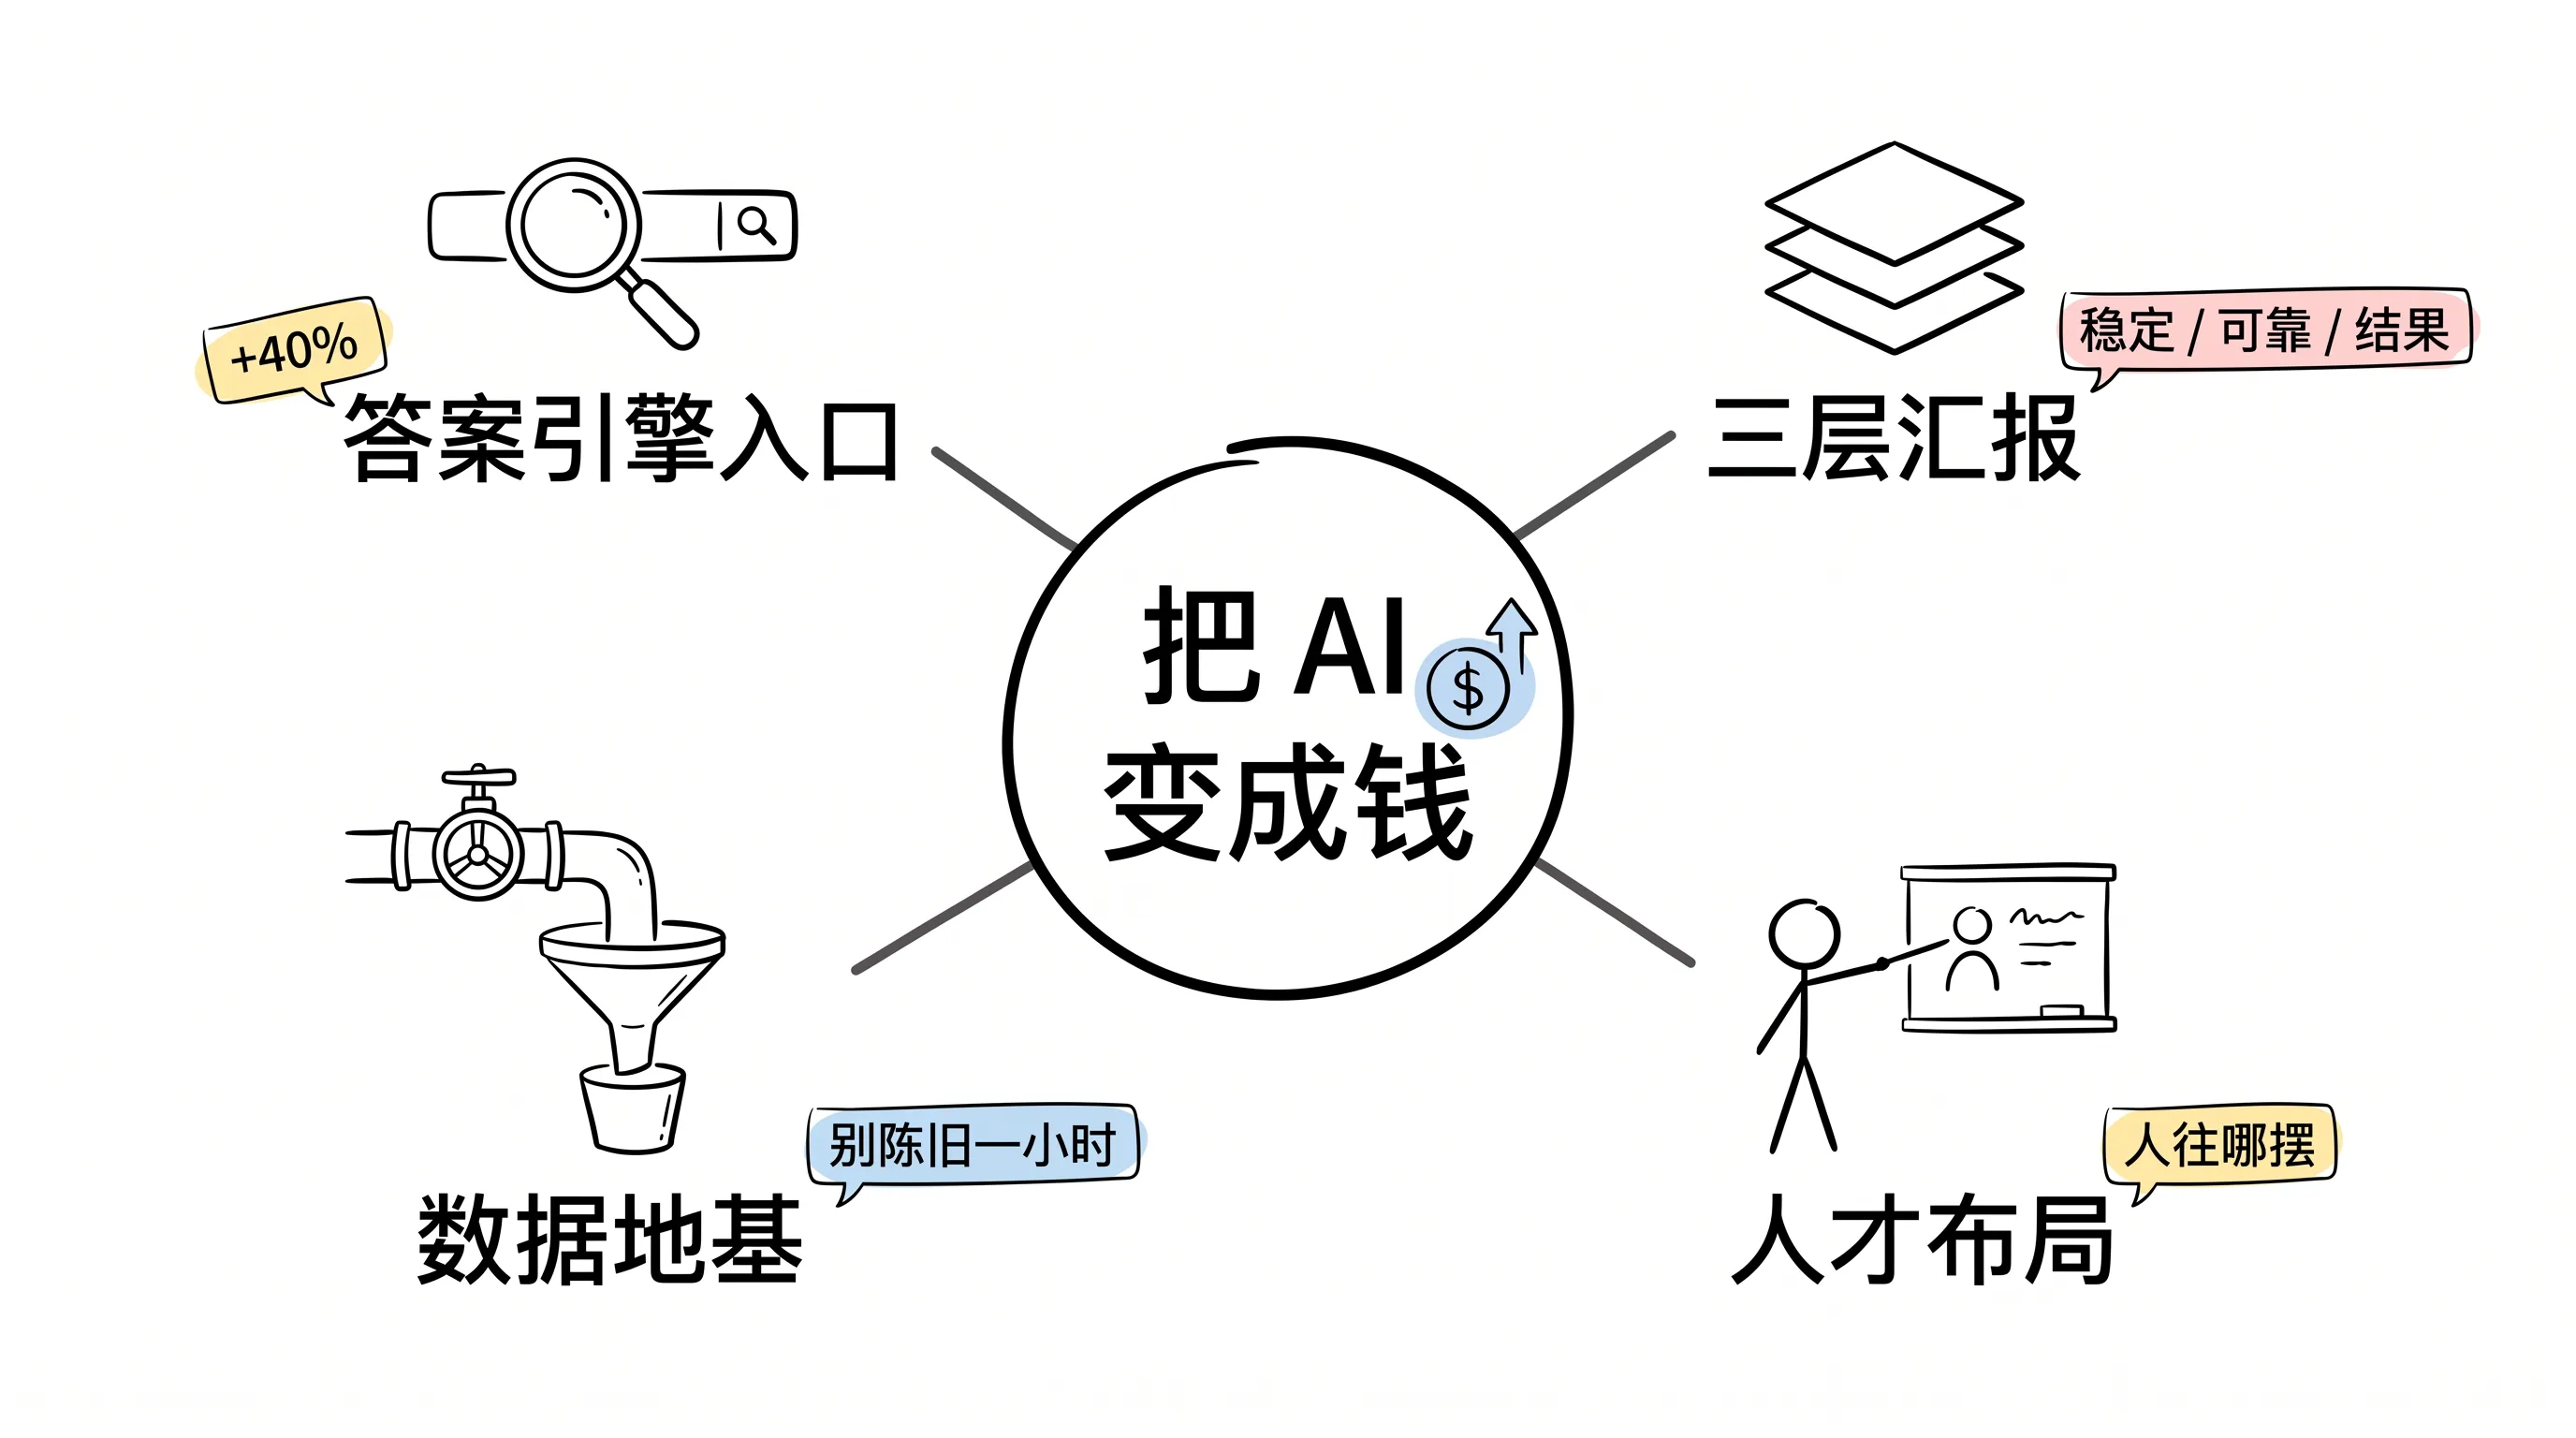
今天这 6 条消息里没有一条是模型发布,全部指向同一件事:怎么把已经到手的 AI 变成钱。HubSpot 把 AI 搜索优化的家底盘了出来,MarTech 连发两篇,一篇教你怎么向老板交代 AI 的价值,一篇劝你先修数据地基再谈智能。营销 AI 研究院用浏览器代理几分钟读完几百条评论,另外两篇在算人该往哪摆。读完这一份,你会拿到一套 AEO 打法、一套 ROI 汇报话术、一份数据自查清单和两个人才布局样本。
🎯 今日头条
AI 搜索月访客一年涨 40%,HubSpot 把优化全流程拆给你看
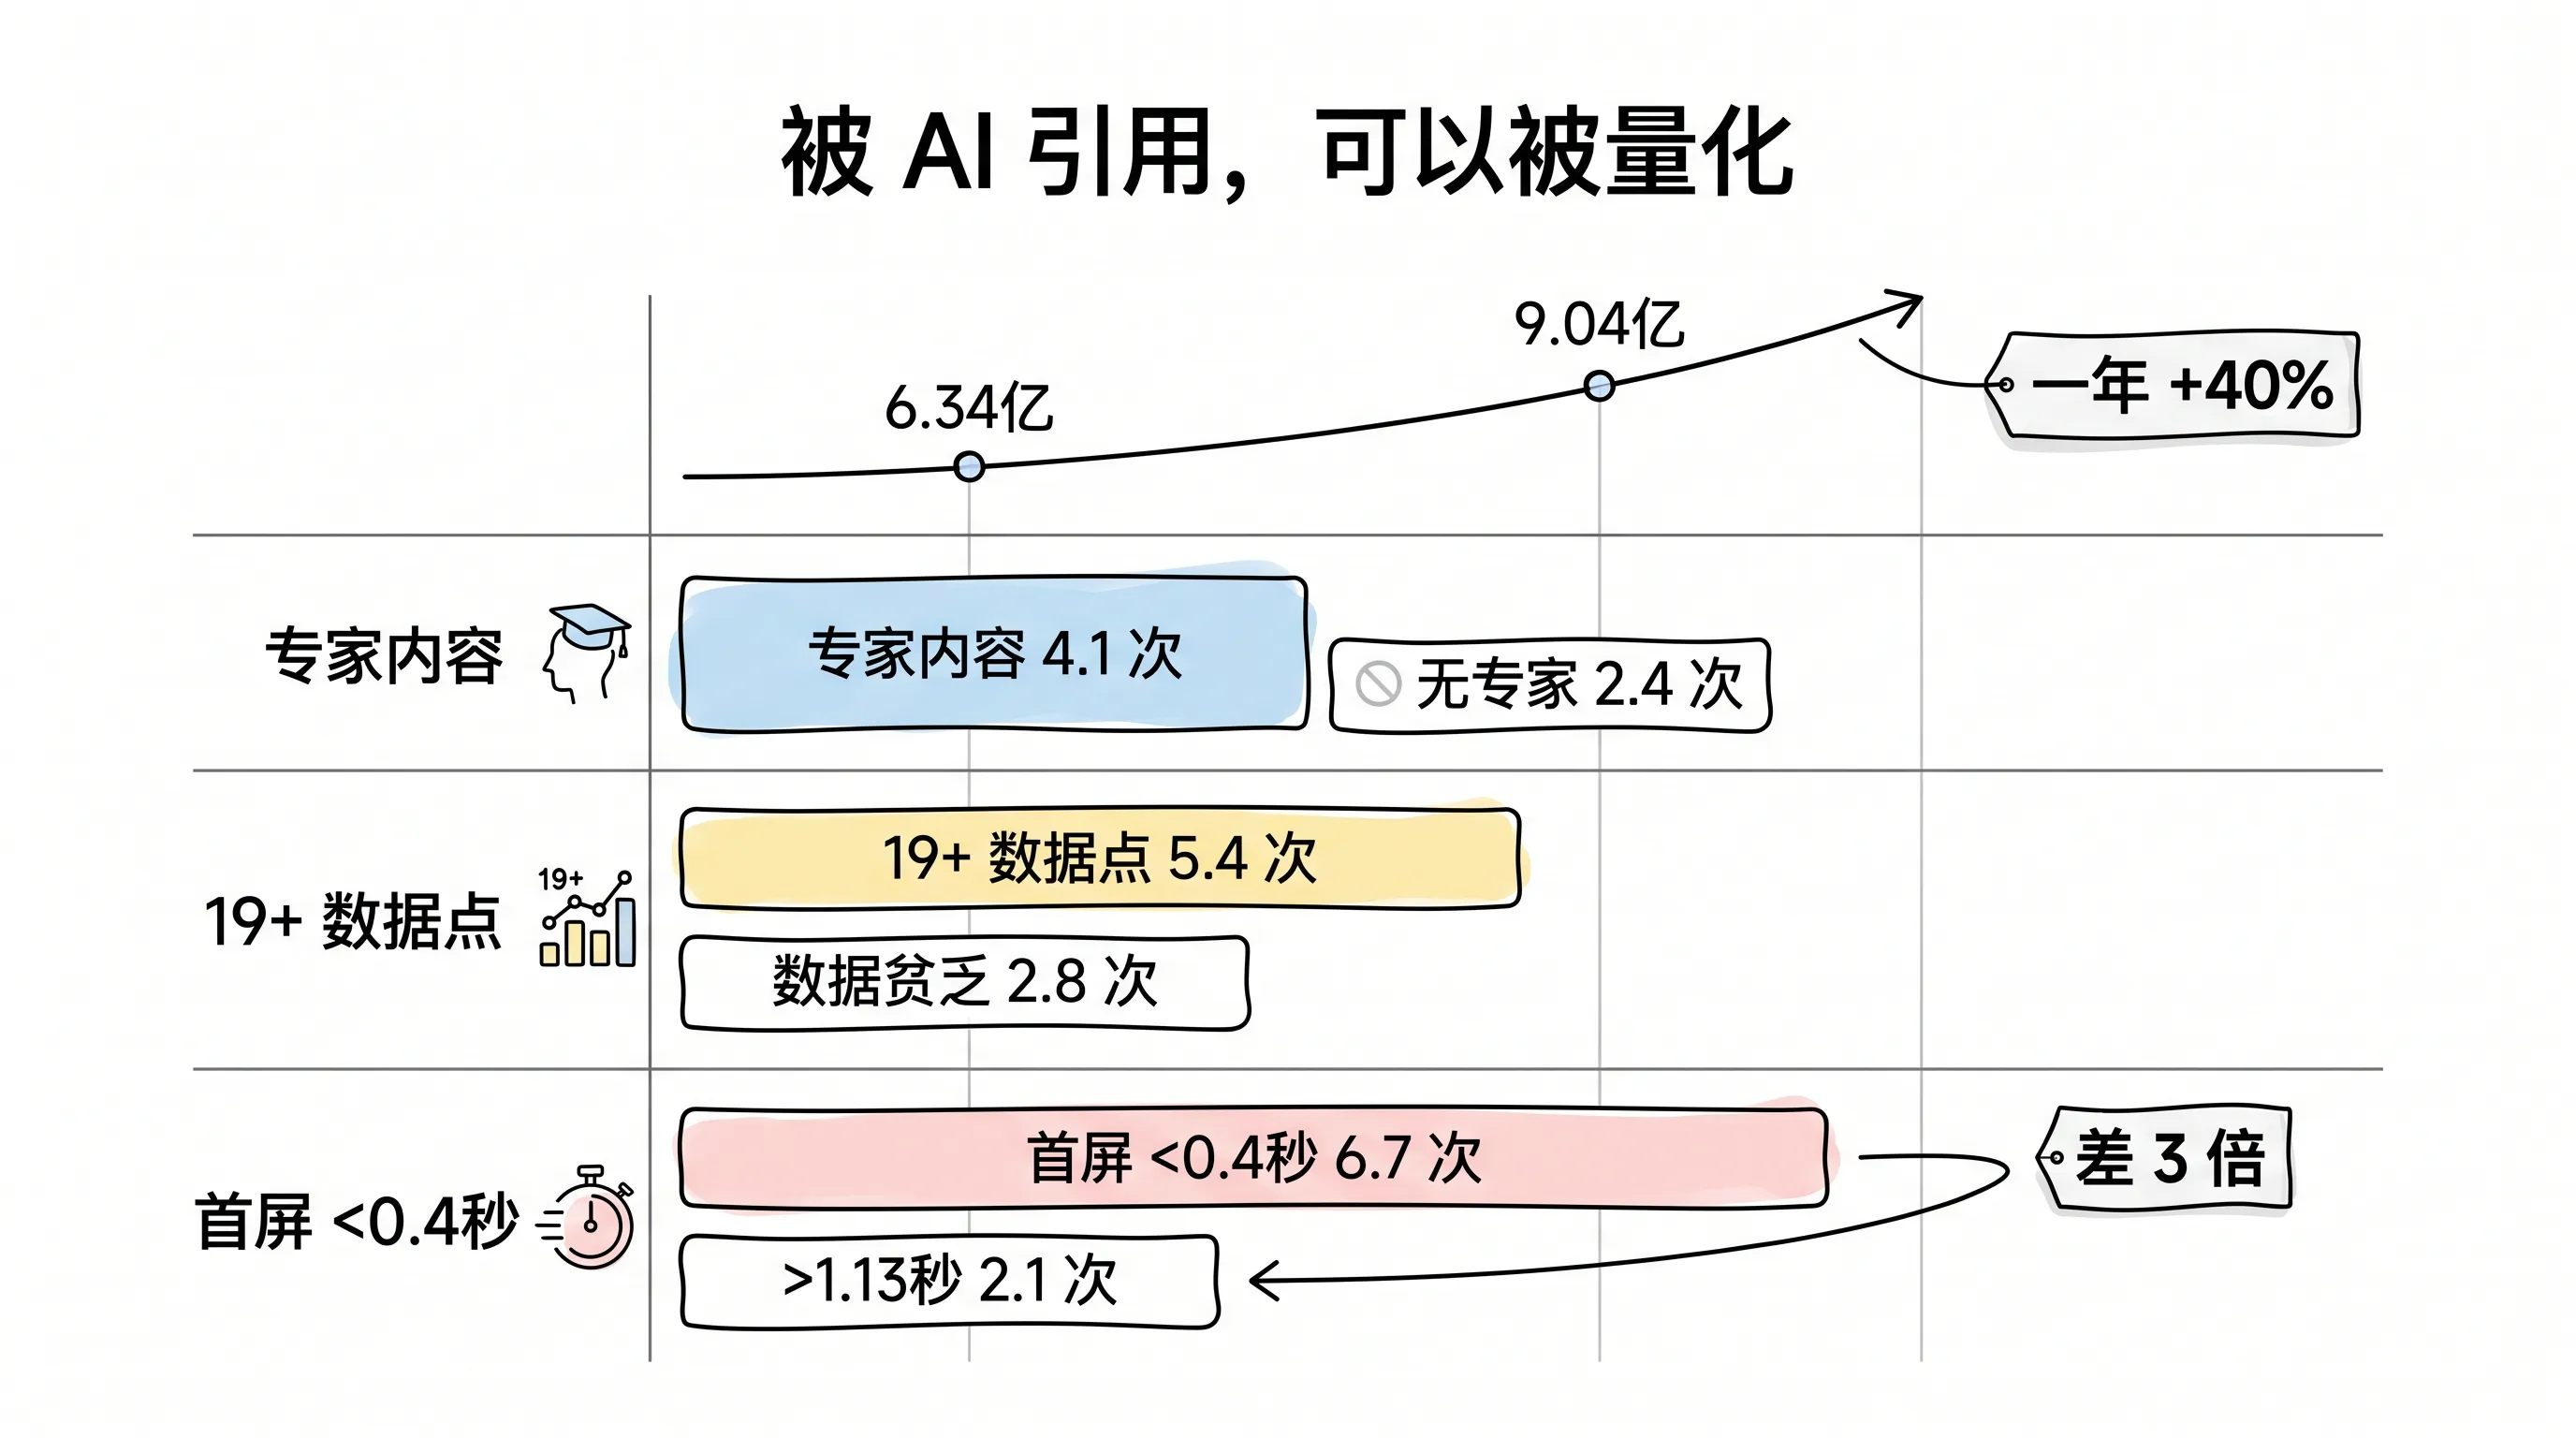
HubSpot 博客 9 月 9 日更新的 AI 搜索优化长文给出一个基本判断:AI 搜索没有另起炉灶,它踩在传统搜索的基建上。Google 的 AI Overviews 跑在定制版 Gemini 上,与现有搜索系统共用同一套信号;ChatGPT 搜索在部分场景直接调 Bing 的结果。也就是说,一个页面能被爬、能被索引、能出摘要,才有资格进 AI 答案。增速数据很直白,Wix Studio 统计,主流答案引擎的月独立访客从 2025 年一季度的 6.34 亿涨到 2026 年一季度的 9.04 亿,一年涨了 40%。这个量级意味着,答案引擎已经从尝鲜渠道变成正经阵地。
AEO 和 GEO 讲了一年,大部分建议停留在玄学。这篇长文的价值在于拿数据说话。SE Ranking 分析了 216,524 个页面:引用专家内容的页面平均被 ChatGPT 引用 4.1 次,没有专家引用的只有 2.4 次;带 19 个以上数据点的页面平均 5.4 次,数据贫乏的页面只有 2.8 次。速度也是变量,首屏渲染低于 0.4 秒的页面平均拿到 6.7 次引用,慢于 1.13 秒的只有 2.1 次,差了三倍。
技术侧还有个容易踩的坑,多数 AI 爬虫只读原始 HTML 不执行脚本,客户端渲染的内容在 ChatGPT 和 Perplexity 眼里可能就是一张白页。摘要控制是另一道闸门,robots meta 里一个 nosnippet,或者 max-snippet 设成 0,页面会同时退出经典摘要和 AI 答案;字符上限设太低,模型就没有足够的上下文可引。只想保护某段敏感文字,可以用元素级的 data-nosnippet 单点屏蔽,其余内容照常可引。多媒体也是入口,生成式结果可以图文视频混排,Fan Out 的站外研究显示 YouTube 是被引用第二多的平台,拿到 1,531 次引用,其中 13.7% 指向带时间戳的具体片段;给视频补上字幕、描述和时间戳,就多了一批被引的机会。本地和商品数据同理,Google 点名 Merchant Center 和 Google Business Profile 是让商品与门店进 AI 回答的通行证,feed 过期等于自动弃权。被引用这件事可以被拆解、被量化,这是它与玄学的分界线。
内容团队的写作方式要动两处。一是答案前置,HubSpot 建议在每个小节的前 40 到 60 个词里把问题答掉;CXL 的引用分析显示,多数被引用的段落落在页面顶部三分之一,只有约五分之一来自底部 40% 的区域。二是格式,问题式小标题的收益有实测支撑:Kevin Indig 的研究发现,被引用文本里出现问号的概率是普通文本的两倍,标题承担了 78.4% 与问题相关的引用;一篇 2026 年的预印本论文测出,列表和表格比同样的散文表述提取精度高 43%。把结论写成一句能独立站住的断言,引擎才能整段抬走。
另一层影响是渠道观。Perplexity 一次回答平均引用 10.8 个来源,ChatGPT 只引 3.3 个;Perplexity 更爱讨论区内容,B2B SaaS 查询里 96% 的 LinkedIn 引用来自它。而 Fan Out 的数据显示,只有 7.7% 的被引用网址出现在多个引擎里。同一篇页面在两个引擎里的命运基本独立,得按两条渠道分别经营,别指望一稿通吃。
动手顺序也有讲究:先把买家问题聚成簇,画出品牌、产品与主题的实体关系图,再按答案前置起草,加结构化数据,上线前验证页面可爬、主内容走服务端 HTML、schema 校验通过,发布当天记录基线位置,然后按固定节奏刷新。
按 90 天节奏动起来。前 30 天指定一个 AI 可见度负责人,用免费的 AI Search Grader 给品牌在 ChatGPT、Perplexity、Gemini 里的现状拍快照,留一份基线。31 到 60 天把刷新节奏写进日历,数据与案例过期最快的页面优先更新,常青页可以缓一缓。61 到 90 天上治理,统一信源、命名和 schema 标准,健康、金融、法务类内容加一道事实核查再发。同时省掉四件白费功夫的事:llms.txt 在近 30 万个域名的分析里与引用量零相关,从预测模型里删掉它反而更准了;给爬虫单开 Markdown 镜像页属于 cloaking,Google 明言反对;专用 AI schema 并不存在,Ahrefs 用 1,885 个页面做对照实验没测出提升;制造虚假提及能骗来短期可见度,SE Ranking 与 Search Engine Land 的假品牌实验里,一个虚构品牌 30 天内几乎拿满了五个引擎上无人能答的品牌词可见度,但在有竞争的通用话题上毫无建树;Google 也已把操纵生成式回答定性为垃圾行为,这买卖从一开始就不划算。
这篇指南里真正值钱的判断是一个词:非商品化。模型引用你的前提是它自己生成不出你这段话,原创数据、一手经验、立场清晰的独立论点,这三样是模型的盲区。追引用流量也要看对盘子,Microsoft Clarity 对 1200 多个站点的统计显示 AI 引荐只占访问量不到 1%,但注册点击率 1.66%,是搜索渠道 0.15% 的 11 倍;WebFX 分析 23 亿次会话,生成式 AI 访客的转化率约为自然搜索的 1.2 倍。量小、质高、涨得快,这是现在就动手的理由。我的建议落在一周内:本周先拍基线快照,把首页和最赚钱的三篇内容改成答案前置写法,下个月同一个时间点再看快照变化,用数据决定加码还是转向。
🔗 深入阅读:查看完整文章
🏷 AI 落地方法
AI 的 ROI 怎么报:Expedia 总监给了一套三层话术
MarTech 9 月 9 日刊出 Expedia 集团能力与运营总监 Angela Vega 的方法论文章,给「AI 的 ROI 怎么算」换了个答法:别把每个 AI 项目硬塞进收入指标,按三层拆开汇报。Base 层是地基,包括统一的数据源、成文的品牌与政策规范、稳定的平台、留痕的决策逻辑,这一层的汇报语言是稳定性;Builder 层是建起来的系统,工作流、代理、路由逻辑、自动化,汇报可靠性与范围纪律;Beneficiary 层才谈业务结果,周转更快、吞吐更高、服务成本更低,偶尔才有增量收入。
作者为什么要较这个真?因为收入归因本来就是笔糊涂账,AI 在其中的贡献多因、下游、滞后,和营销人吵了多少年的多触点归因是同一类难题。数据更说明问题:MIT 2025 年的商业 AI 现状报告发现,大企业 95% 的生成式 AI 试点在损益表上测不出回报;麦肯锡的调查里 88% 的企业用上了 AI,只有 39% 能指出利润影响,归因超过 5% EBIT 的仅 5.5%;BCG 的数字是 75% 的高管把 AI 列为前三优先级,只有 25% 认为组织真的收到了价值。收入那一栏很难看,生产力这一栏倒是扎实的:NBER 的研究发现生成式 AI 助手让客服每小时解决的工单量提升 14%;GitHub 统计 Copilot 把编码任务提速 55%;斯坦福 2026 年 AI Index 给出的区间从客服的 14% 一直到营销产出的 50%。
Vega 给的解法是 lab-factory 模式:实验室快速试错,不按生产标准要求产出;工厂严格把关,负责把验证过的工作流规模化。关键是想清楚一条工作流从实验室毕业到工厂需要满足什么,比如基座稳定性达标,或者准确率在一段时间内保持住。没有这道门,团队会在两个极端之间摇摆:实验永远停在实验,或者半成品直接冲进生产,两种都会烧掉团队信任。分层之后汇报话术也齐了,base 层讲稳定,builder 层讲可靠性提升与范围纪律,beneficiary 层才讲业务结果。BCG 的另一项研究补了一个数:聚焦平均 3.5 个用例的公司,ROI 是撒胡椒面公司的 2.1 倍。文中的正面样本也全:Adobe 先花两年做内容供应链,把品牌规范、元数据、审核工作流统一成代理可调用的系统;可口可乐与 OpenAI、贝恩搭了 Create Real Magic 生成平台;多邻国把每季度课程单元从 7100 个做到 20500 个,并在投资者沟通里把这条提速与两位数营收增长直接挂钩。
资源往哪投,文章也给了先后:先立统一的数据定义与信源,任何代理和工作流最终都从这里取数;给多团队共用的信息建一层共享上下文,否则同一个知识库会被重复建五遍;再定一条仲裁规则,两个数据源打架时听谁的,缺了这条,产出会看着自信、行为却不一致,调试远比预防费劲。规模扩大后把代理当产品养,要有负责人、版本号和下线方案。她给过一个对照:专精度 98% 的窄代理,比在五个领域各 80% 的通用代理更值得信任,修水管要叫水管工而不是万金油师傅,就是这个理。
💬 营销人本周就能用上这套语言:把周报里的 AI 进展按三层重排,base 层报数据与规范,builder 层报可靠性与范围,beneficiary 层报周转与成本,别再拿生产力故事硬凑收入数字。这样改一处模板,能同时防住两种扣分,虚报收入被拆穿,实打实的提速被低估。
🔗 深入阅读:查看完整文章
数据陈旧一小时,营销执行就注定被动
9 月 MarTech 大会的圆桌给出一个扎心诊断:营销团队不缺 AI 点子,缺的是喂得动 AI 的数据管道。这场名为「为昨天而建」的小组讨论请来 MessageGears 内容与产品营销负责人 Courtney Adams、Monarch Advisory Partners 创始人 Jacqueline Freedman、Napier 主席 Mike Maynard,主持是 Qualify Digital 数据策略高级副总裁 Kevin Haag。
Adams 的判断很直接:数据只要陈旧一小时以上,执行就注定被动。她举例,想激活一个客户属性,如果需要专门开一轮数据科学冲刺、写定制集成、再写复杂 SQL,一个简单请求会滚成数月项目。她的另一句提醒值得抄在备忘录上:AI 的强弱取决于你喂给它的信息,关键行为信号、购买动态、服务互动到不了模型那里,盲区会直接毁掉输出。她还提醒,换营销自动化供应商治不了这个病,底层架构刚性不改,同样的延迟会原样跟到新平台。Maynard 用自家机构的口头禅补刀:点子容易,执行难。B2B 场景尤其如此,复杂采购委员会需要足够的上下文数据,喂不饱,AI 就只会批量产出更泛的通用文案,最后发现卡住自己的原来是数据可得性,与模型无关。Freedman 把矛头指向系统设计:新工具治不了工具外面的老毛病,买软件之前先画清信息在各系统之间怎么流、人每天怎么用这些工具。
讨论里最容易被忽视的一条是回流。多数团队从数仓取数做营销,却忘了把营销互动数据写回去,结果营销、BI、数据科学各抱一份互相打架的客户记录,谁也没有真正的单一视图。架构选择上也没有标准答案:Freedman 力挺组合式,她问「你要一套最佳组件的堆栈,还是要一座能搬动的单体」,把单体平台比作老房子,每次小修都可能牵出隐藏的结构性问题,组合式的真正好处是可拆换,AI 厂商迭代这么快,换掉一个组件不用掀翻整个系统;Maynard 泼了冷水,小团队没有工程人力去维护几十个点状集成,功能够用的一体化套件往往更实用。Freedman 还留下一句流传度会很高的警告:AI 修不好你的坏线路,只会让坏流程跑得更快、错得更彻底。
三位给出的自查动作很具体。先做数据足迹审计,摸清客户数据散在哪些库、谁在管、有没有真正的单一客户视图;再排查断掉的反馈回路,找出互动数据没能流回中央数仓的断点;最后盯高价值信号,Maynard 提醒,一个关键数据点,比如买家打算开几年换车,往往比几十个低价值行为指标更有杠杆。收尾建议一人一条:Adams 说先在单个战役上把 AI 激活跑通,别想一口吃成胖子;Freedman 说自己从头到尾走一遍客户旅程,从注册到售后亲自体验每个触点;Maynard 说少看新工具有多炫,多看客户需要什么数据。
💬 MarOps 下周就能动手的三件事:画出客户数据的存放地图,标出写不回数仓的断点,挑一个能撬动决策的信号补进模型上下文。做完这三步再评估要不要换平台,大概率你会省下一次白花钱的迁移,下个 AI 项目的立项理由也站得更稳。
🔗 深入阅读:查看完整文章
🏷 营销工具
浏览器代理几分钟读完几百条 LinkedIn 评论
Marketing AI Institute 9 月 9 日发布了一个浏览器代理的一手实测。创始人 Paul Roetzer 发帖评论纽约市公立学校课堂禁用生成式 AI 的决定,几百条评论涌进来,从认真讨论到尖锐对立都有。人工的选项只有两个,复制粘贴到文档里整理几个小时,或者干脆放弃分析,团队选了第三条路,把活交给 AI。他们用的是 GPT-5.6 Sol 的浏览器操作能力,经 ChatGPT/Codex 桌面端在已登录的浏览器会话里执行,不需要人手动导航。
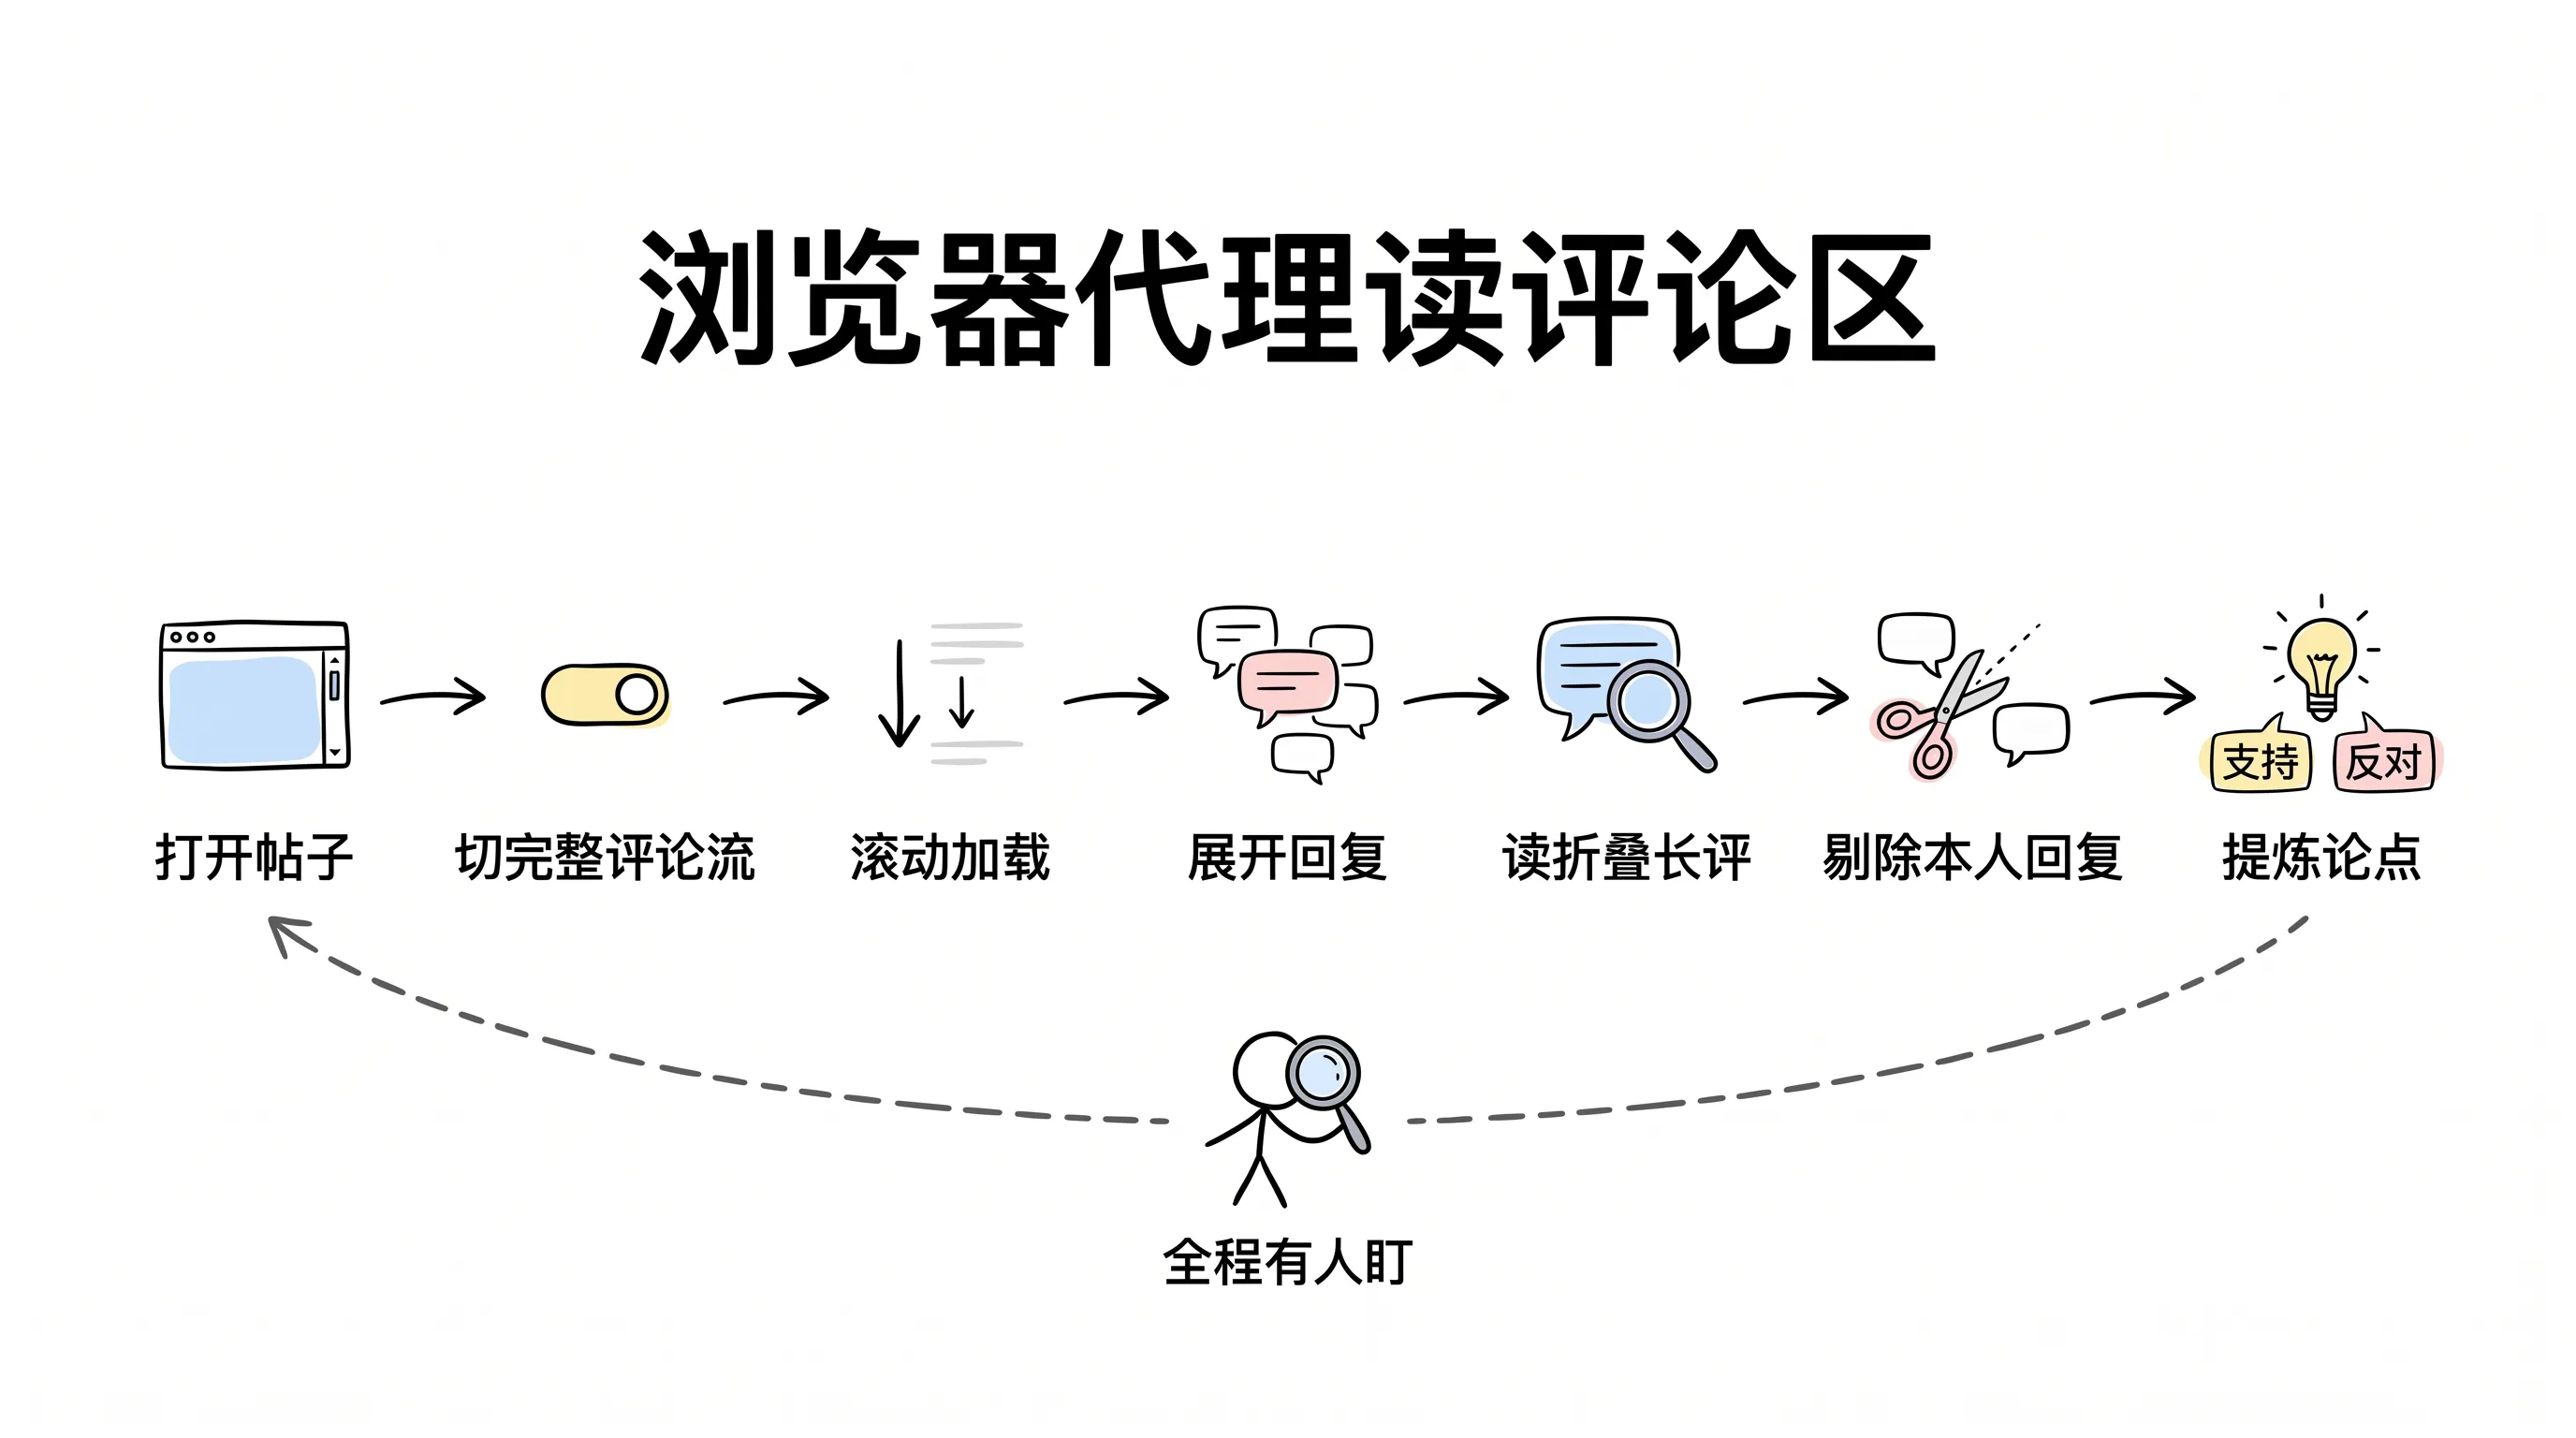
整个过程 AI 做的事比想象中细:打开帖子后先把默认的最相关排序切到完整评论流,按顺序逐条推进,滚动触发加载更多,主动展开楼层里的回复,点开被 See More 折叠的长评论读全文,把 Roetzer 本人的回复从受众评论里剔掉,还区分了同一个人的多条评论,避免一张嘴被算成两票,最后按支持与反对分组,提炼出跨楼层反复出现的论点和代表性例子。全程有一个人盯着看。团队明确提醒,别让代理在你登录着的账号里独自干活。
结果层面,情绪正负各占约一半,这不算意外;有意思的发现是嗓门最大的那批评论并不代表多数。按人头加权、不按条数算之后,被两边极端声音淹没的温和中间派浮出水面,观点结构立刻变得立体。团队把这个套路迁移到四个场景:产品发布帖的即时情绪,不用再等正式调研;竞品评论区反复出现的异议,直接喂进话术优化;战役上线后的社区反应,用数据决定放大还是调整;行业争论里被忽略的主流观点,替品牌找到安全的站位。原则就一条:凡是你要从浏览器里复制粘贴内容来分析的地方,浏览器代理都能接手。
风险也说得明白。浏览器代理跑在真实登录态里,要放在受控环境、全程有人监督、任务范围收窄到单一目标,现在的正确姿势是监督着用、想清楚了用;LinkedIn 等平台的条款可能封号,规模化无人值守等于拿账号冒险,团队这次只做了小范围试验,正是冲着这条边界去的。文末预告,OpenAI 最新的 GPT-6 Astra 专门在计算机使用的速度、准确与可靠性上做了大升级,现在就在受控条件下练手的团队,等能力成为标配时已经领先一个身位。这期实测出自他们播客第 237 期 The Artificial Intelligence Show 的用例环节,每一步都有记录,可复现。
💬 本周可以挑一个不敏感的帖子试跑一轮:自己的账号、单帖范围、人工全程盯着,先拿产品发布帖或竞品帖练手。一轮能省下两三个小时的人工翻评时间,读舆情时记得按人头加权,别被高赞极端评论带偏。合规红线别碰,公司主账号别拿来当试验田。
🔗 深入阅读:查看完整文章
🏷 组织与人才
IKEA 把 8500 名客服转训成设计顾问,一年赚回 17 亿美元
MarTech 9 月 9 日刊登 Wyndham 酒店集团营销技术专家 Steve Petersen 的专栏,借 WYSIWYG 编辑器 50 年的历史讲 AI 与就业:技术改变的是角色,不消灭专业本身。WYSIWYG 最早能追溯到 1974 年,CMS 普及后写网页的人没有被淘汰,工作重心从写代码转向编辑与维护。更早的例子在音乐圈,MTV 1981 年开播时打的宣传曲叫 Video Killed the Radio Star,近 45 年过去,电台活得很好,播客和有声书还把音频做成了更大的生意。vibe coding 时代的软件工程师正在经历同样的位移,从写变成审。卫报作者 Varsha Banal 描写过这个群体的状态:技能价值突然变得不确定,有人回去补基础,有人追新技能,有人寻求集体行动,有人干脆考虑离开行业。
社会层面在补结构性缺口。跨党派组织 Raise U.S. 由前商务部长雷蒙多与前印第安纳州州长霍科姆牵头,想避免重演上世纪制造业外迁的社会代价;软件工程师 Kaitlin Cort 创办的互助社区 What Will We 为受冲击的知识工作者提供社区岗位板、裁员危机支持、共享学习工具、申请进度追踪,到 2026 年 7 月中还在筹备基本收入试点与互助基金。
公司层面的样本更有说服力。IKEA 分析了机器人答不了的用户诉求,发现室内设计咨询是个大空白,于是把 8500 名客服转训成设计顾问,这块新业务 2024 年带来 17 亿美元收入,占总营收 3.3%,预计 2028 年冲到 10%。Best Buy 走的同一条路:训练店员帮客户做复杂选购,用真人专业度与纯线上对手拉开差距。两家共同点是,重复问答被网站和 AI 接走后,人被挪到了能涨价的位置上。反面样本也有,Gartner 发现很多用 AI 名义裁员的公司在后悔,预测 2027 年前一半裁员会被逆转,原因在于 AI 知识广但缺人类判断。作者给营销技术人的建议落在习惯上:中年从业者每天用公司批准的 AI 工具处理几件小事,把新习惯养出来;主动宣传自己的成果,他引述过一位前任 VP 的提醒,向上同步不等于自私,上级会记着你的价值;用平台去解真问题。基本功也重新值钱,美国联邦政府的系统至今还跑着上世纪 50 年代的 COBOL,懂旧学问的人照样有饭吃,旧知识偶尔还能点燃新技术。他举的转型样本是滑雪场 Snowbasin 的营销总监 Michael Rueckert,发现 AI 聊天机器人不推荐自家雪场后,用 Claude 搞出了解决方案,顺势创业做 AEO 与 GEO 服务,公司叫 Centium。
💬 给团队排座次前先看两件事:哪些岗位每天被重复问答占满,能不能学 IKEA 把人转去卖专业服务;哪些判断环节 AI 答不了,那才是该加预算的地方。个人层面每天雷打不动用 AI 做一件真活,把「用过」变成「用顺」,顺便把自己的成果记下来向上同步,别等组织安排。
🔗 深入阅读:查看完整文章
BCG 合伙人三年前的 TED 演讲,说中了今天的 AI 营销困境
bestdaily 今天收录的这条是常青内容:BCG 合伙人 Jessica Apotheker 2023 年 12 月的 TED 演讲,至今 93 万次观看。她当时给出一组判断,今天回头看几乎全中。BCG 与哈佛的研究测出,ChatGPT 已让营销人的右脑产出提升约 40%;但这份生产率不会变成闲暇,只会变成更多内容,就像文字处理机没有让人少上班,只是把汇报从 6 页 PPT 做到 50 页。她描绘过的那种完全定制的邮件正在成真,图片里的模特年龄性别都对得上,衣服印着你喜欢的那支乐队,每件商品都踩在点上;对品牌这是效率,对收件箱这是灾难。
由此她推演出两个风险。一是内容过载,个性化推送的量会爆炸,用户被同样内容反复追着跑。二是内容同质化,生成式 AI 在既有内容上训练,会压缩产出结果的差异度;研究显示人们过度依赖生成式 AI 后,集体观点分歧度下降 40%,新想法冒不出来,真正的创新被闷死。对一个靠差异吃饭的行业来说,这是比效率更贵的问题。
药方分三步。第一,给营销组织长出左 AI 脑:她与一家消费品公司合作,建了 30 多人的营销数据科学团队,把预测工具铺给每一个营销人,让每次投放前都能预估各渠道的销量结果,形成正反馈循环;哪组创意素材真的在跑量、漏斗正往哪里演变,每个营销人开工前就能看到答案,不用再等季度复盘。第二,别只用自家内容训练模型。一个在千禧一代里很强的品牌,靠自己的数据永远打不开 Z 世代;要到生态外找数据伙伴,她举例建筑公司想营销建筑师,可以去和金融机构、保险公司共建联邦学习模型,绕开直接的同行数据壁垒。第三,识别并保护右脑人才,这群人的识别方法很朴素:他们总是不同意你。要教他们用 AI 找灵感、快速出原型,好想法一旦成形就用 AI 放大冲击力,但拦着他们用 AI 直接原创想法,那部分必须留给人的脑子,否则品牌的独特性会在平均化里一点点漏掉。她给每个营销人的收尾建议是选边站:偏创意的,把原创能力练成护城河;偏数据的,往预测技能里深耕。当下每个人都得先选好自己的脑。
💬 组织动作可以照着抄:盘一下你的营销数据科学力量,凑不出 30 人就先立 3 人小组,把预测能力铺到投放决策里;数据合作去生态外谈,同行是对手,金融、保险这类跨行伙伴反而干净。最要紧的一条,把你团队里那个总唱反调的人保护好,别让模型替他做原创。
🔗 深入阅读:查看完整文章
💡 今日总览
把今天 6 条放在一起看,没有模型发布,没有融资新闻,全是同一件事的不同侧面:怎么把已经到手的 AI 变成钱。头条讲流量入口在向答案引擎迁移,一年涨了 40%;ROI 那篇讲这部分投入怎么向老板交代;数据架构那篇讲地基喂不喂得动;浏览器代理实测演示 AI 已经开始替人干活;IKEA 和 TED 那两篇算的是人往哪摆。
串起来看,一个分水岭正在拉开。模型能力的差距在收窄,人人都能调用同一个 GPT-5.6 Sol,人人都能读同一篇优化指南。真正拉开差距的是模型之外的部分:你的数据管道是实时还是陈旧一小时,你的汇报语言能不能换来预算,你的内容有没有模型生成不出的原创密度,你的组织有没有保护那个总唱反调的人。这四问今天各有一条新闻在给答案。MIT 那句 95% 试点测不出回报的判词,和头条里 6.34 亿到 9.04 亿的访客曲线,放在同一天看很有意思:能力在普及,兑现靠地基,两条曲线之间隔着的就是这四问。
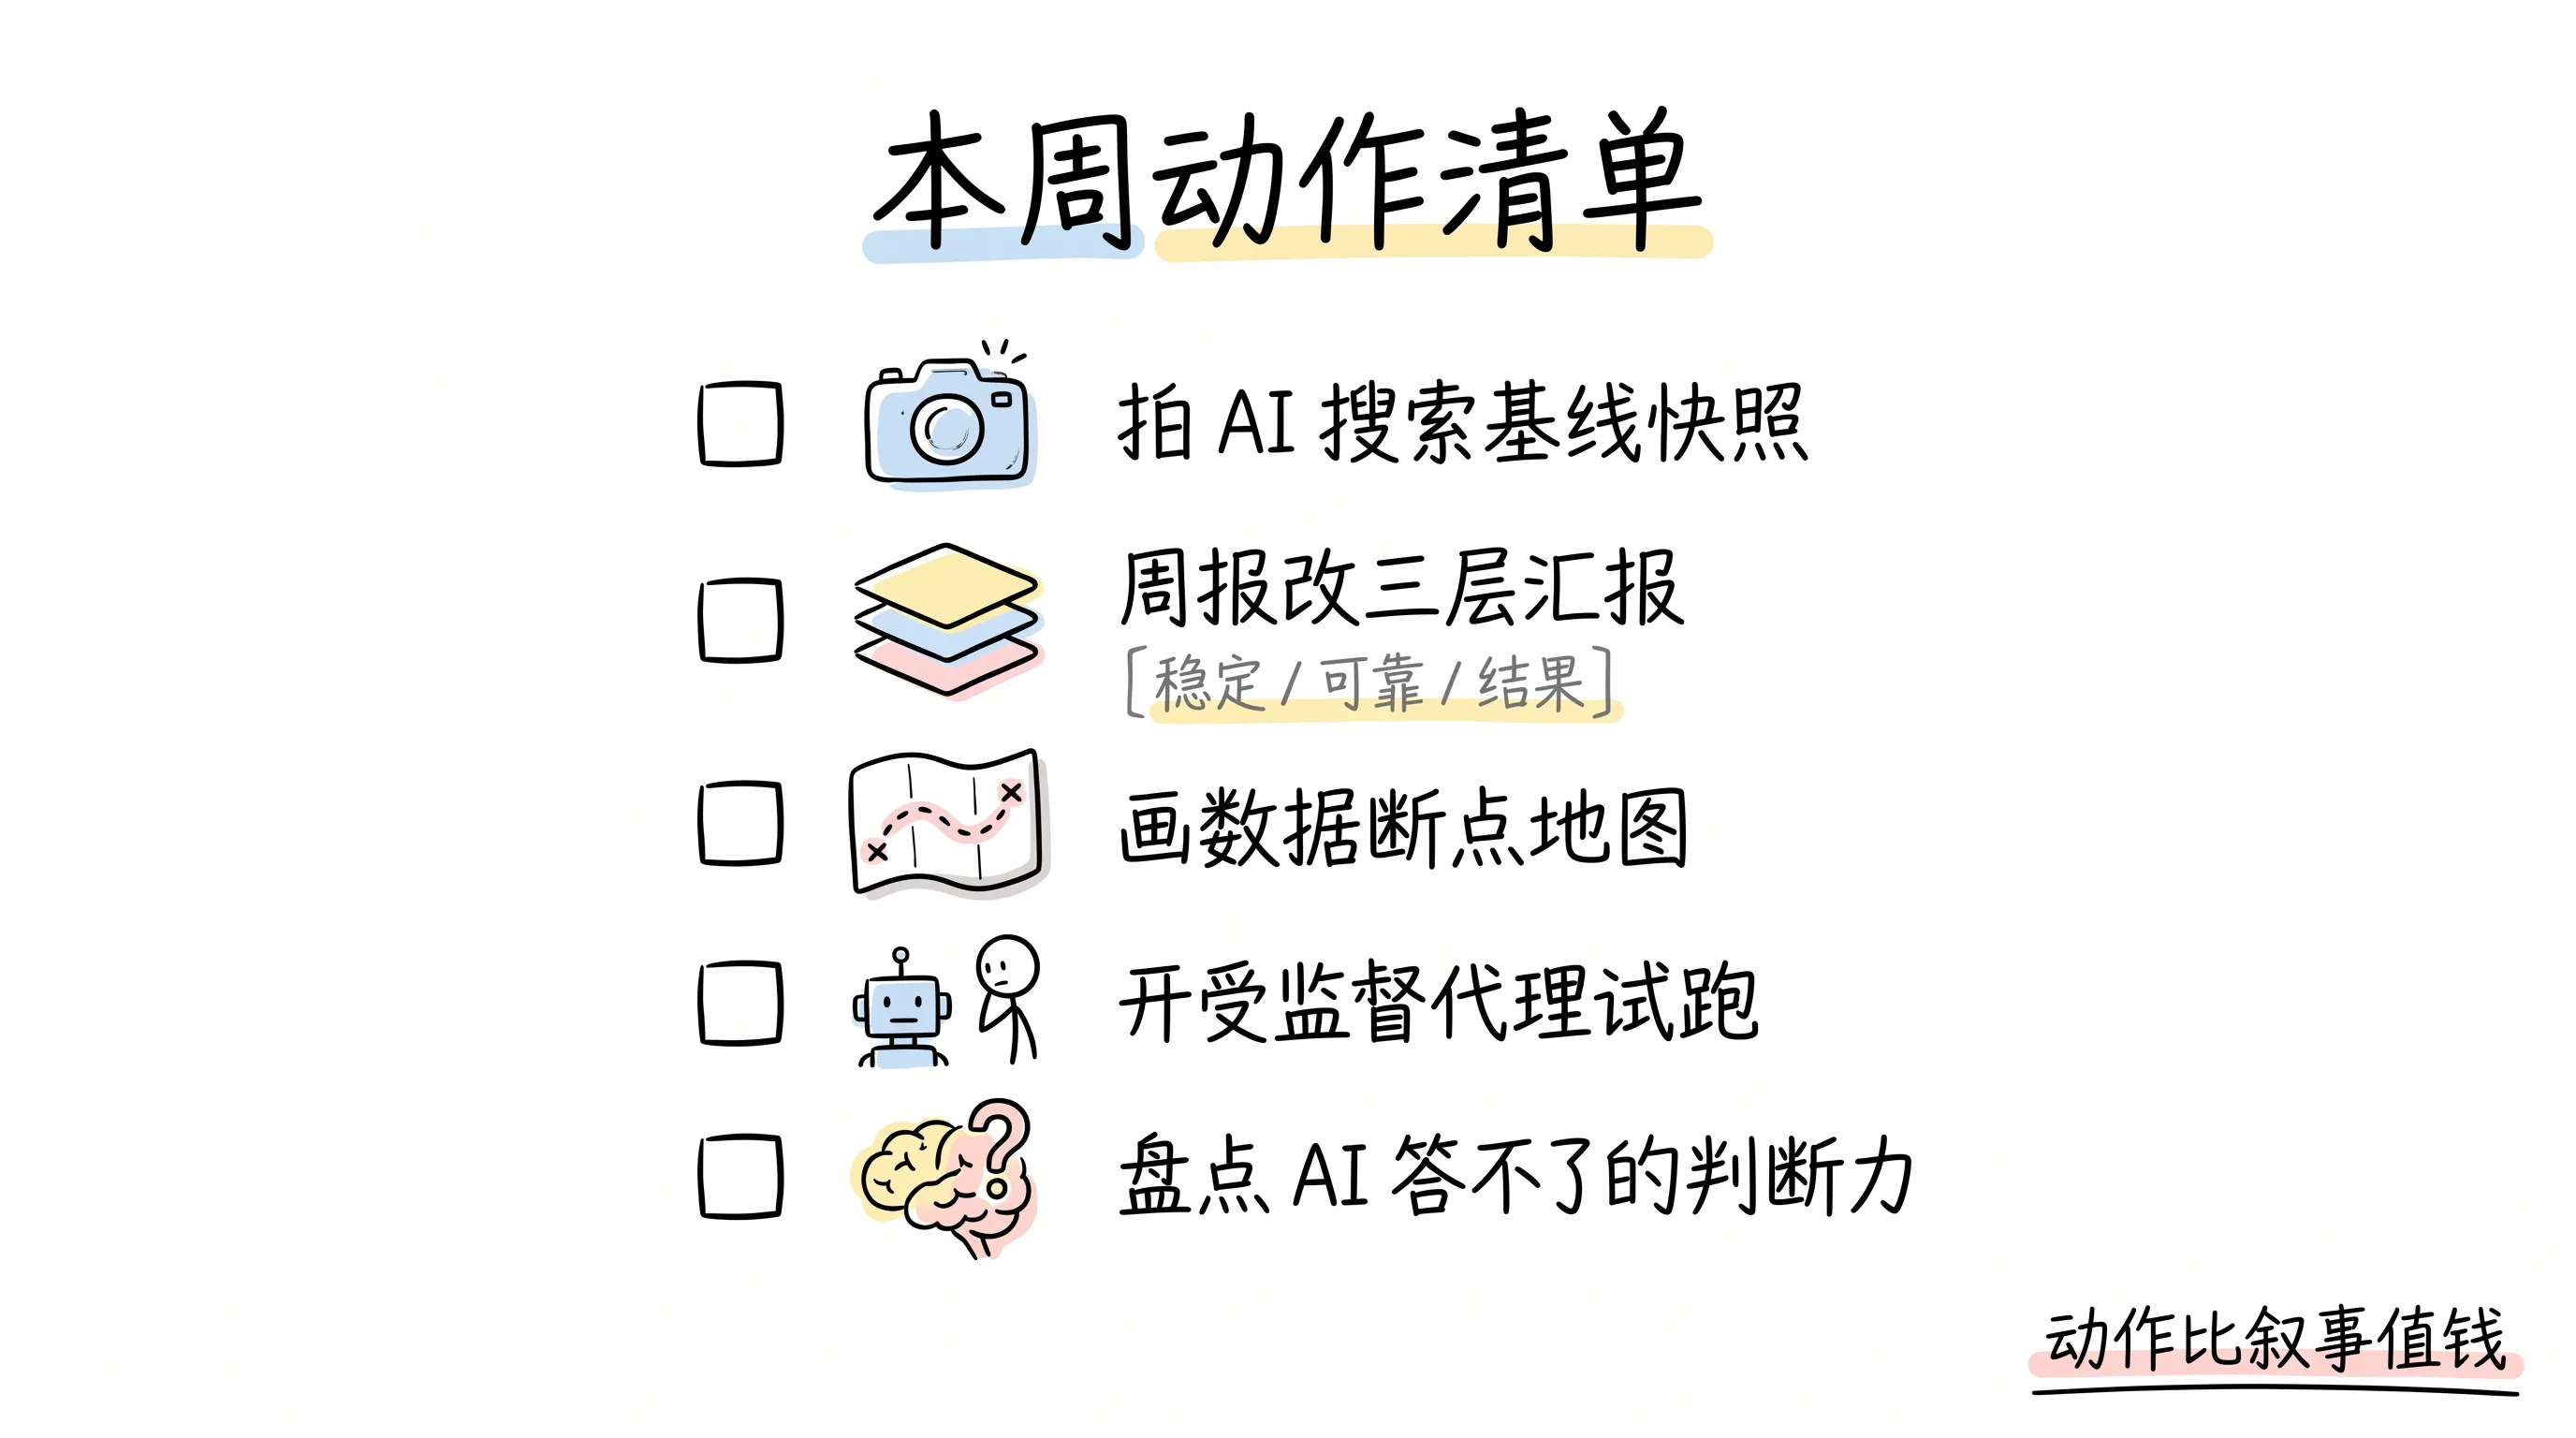
给读者留一个动作清单:本周拍 AI 搜索基线快照,把周报改成三层汇报语言,画出数据断点地图,开一个受监督的代理试跑,再盘点你团队里 AI 答不了的那部分判断力握在谁手里。风口讲了一年,这一天的主旋律已经从讲故事换成算账,动作比叙事值钱。
继续阅读
相关文章

AI Marketing Daily · 2026-10-09
2026-10-09 AI 营销日报,共 11 条:品牌度量从问卷面板转向搜索、社交、电商与 AI prompt 信号;GEO 与 share of model 打法、代理式投放安全护栏,以及广告平台、跨境工具与社媒用法的选型盘点,主线是从买工具转向搭系统。

AI Marketing Daily · 2026-10-08
2026-10-08 的 AI 营销日报汇总 20 条内容,覆盖 GEO 可见度、广告、平台选型、跨境电商与 ROI 度量。头条观点认为战略决策应由人负责,AI 适合辅助执行层。

AI Marketing Daily · 2026-10-07
今天的主线是答案引擎优化。MarTech 头条讲品牌故事怎么决定 AI 可见度,HubSpot 一天发出五篇分岗位的 AEO 指南,两条线合成一个信号:AI 搜索的可见度经营正式开工。